Im Sommer hatte ich ein Gespräch mit einer Kollegin und Anlass war eine der unzähligen KI‑Meldungen. Sie fragte mich, wie ich die aktuelle Lage und vor allem die Zukunft von WordPress einschätze und, ob ich die Gefahr sehe, dass WordPress irgendwann von der Bildfläche verschwindet.
WordPress als Alltags-Infrastruktur?
Ich war damals überzeugt, dass WordPress nicht verschwinden wird. Es würde wohl noch ein bisschen an den Marktanteilen verlieren, sich bald stabilisieren und dann allmählich zu einer Art »Alltags-Infrastruktur« im Web werden.
So wie heute kaum jemand von Redakteuren auf Anhieb weiß, welche PHP-Version auf dem Server läuft, und so in etwa, wie kaum ein Mieter auf Anhieb genaue Infos zur Elektrik und Verkabelung in der Wohnung parat hat. Das sind Sachen, die werden vorausgesetzt, laufen im Hintergrund, sind aber dennoch äußerst wichtig. Erst wenn sie nicht funktionieren, fängt man an, sich wirklich Gedanken darüber zu machen.
Mittlerweile bin ich mir nicht mehr so sicher, ob meine Einschätzung noch passt. Um genauer zu sein, einige der Meldungen stützen meine Einschätzung, andere deuten eher auf ein etwas pessimistisches Szenario hin. Hier einige Gedanken von mir und ich bin gespannt, wie ihr die Lage einschätzt.
Einfachheit war der Grund für den Aufstieg von WordPress
Jeder, der in den Jahren 2002 oder 2003 versucht hat, auf dem Server ein Perl-Skript oder eine PHP-Anwendung zum Laufen zu bringen, weiß genau, wie umständlich und unnötig kompliziert es vielfach war. Dann kam WordPress mit seiner berühmten »5‑Minuten-Installation« und für viele Leute war das ein krasses Aha-Erlebnis.
Klar, am Anfang hatte WordPress lachhaft wenig an Funktionalität zu bieten. Es war aber einfach und das hat viele Menschen ermutigt, es zu installieren und loszulegen. Blogs und kleine Websites wuchsen, sprichwörtlich wie die Waldpilze nach dem Regen.
Das ist damit gemeint, wenn gesagt wird: »WordPress hat das Web demokratisiert«. Auch jemand, der kein IT-Fachexperte oder Server-Admin war, war auf einmal in der Lage, ein Publikations-Tool einzurichten, zu betreiben und sich zu vernetzen.
Blog-System → CMS → E‑Commerce → Design-Tool
Genau diese Einfachheit hat WordPress zu seinem Aufstieg verholfen. Obwohl die anderen Systeme auf dem Papier vielfach eleganter und leistungsfähiger waren, hat die Einfachheit das alles in den Schatten gestellt. Du warst schnell einsatzbereit und warst schnell in der Lage, deine Inhalte zu publizieren.
Mithilfe von externen Diensten und den Plugins, die bald kamen, hat man dann allmählich die fehlenden Funktionen nachgerüstet und somit fing der Aufstieg an. Zuerst zum ernst zu nehmenden CMS, dann zu einer E-Commerce-Plattform und mittlerweile zu, wie ich es nenne, einem Design-Tool.
Heute sind andere einfach und schlank
Mittlerweile fühlt sich WordPress nicht mehr so schlank an und es ist auch nicht mehr so schnell einsatzbereit. Zur Zeit von Themes wie Kubrick, 2010 oder 2011 konntest du eine Seite installieren, ein wenig anpassen und schon den ersten Inhalt publizieren, und das alles unter einer Stunde, während du dabei noch gemütlich deinen Kaffee getrunken hast.
Heute ist es aus einer Reihe von Gründen anders. Klar, es ist eine andere Zeit, Menschen haben höhere Ansprüche, aber vieles liegt auch an WordPress und seinem Ökosystem selbst.
Jetzt sind andere Lösungen einfacher. Auch wenn es vielfach nur vermeintlich ist. Es ist deutlich unkomplizierter, mit einer KI zu quatschen, und die übernimmt den Rest für dich, als sich in eine Tool-Oberfläche einzuarbeiten.
Wenn ich via ChatGPT oder Claude auf Sistrix, Ahrefs oder Supermetrics zugreifen und von dort die Infos holen kann, warum soll ich mich dann ernsthaft in die Oberfläche der einzelnen Tools einarbeiten? Die Zeit für eine ernsthafte Einarbeitung in die Tools muss man auch erst mal haben.
Es ist schon seit Längerem möglich, Skripte, kleinere Apps, einfache WordPress-Plugins und auch umfangreiche Google-Tabellen und Diagramme zu erstellen, ohne Ahnung von PHP, Javascript oder Google Apps Script zu haben. Warum sollte es daher nicht möglich sein, WordPress-Projekte via Claude, ChatGPT & Co. zu erstellen und zu betreuen? Nicht zuletzt so Projekte wie Elementor MCP zeigen, wo die Reise hingehen kann.
Die KI wird zu einem universellen Dashboard und einer Steuerzentrale und die anderen Tools stellen Informationen, Daten und Funktionen bereit. Diese Zukunft wird auch WordPress ereilen und das wäre meiner Meinung nach die optimistische Variante.
WordPress als Perl des World Wide Webs?
Wer kann sich noch an Perl erinnern? Diese Programmiersprache in Verbindung mit CGI (Common Gateway Interface) war zu Anfang des Jahrtausends das Power-Duo, wenn es darum ging, etwas auf dem Server zu machen oder Dynamik ins Web zu bringen. Perl ist aber nicht komplett weg, lebt jedoch ein sehr abgeschiedenes und ruhiges Leben in der Provinz. 😀
Perl läuft nicht nur in vielen Legacy-Projekten, sondern auch als wichtiges Tool für Server-Admins, etwa bei der Logfile-Analyse, bei der Automatisierung von Cron-Jobs usw. Es wird auch fleißig weiterentwickelt. Aber es wird kaum noch für neue Projekte herangezogen.
Ähnliches Schicksal, denke ich, wird WordPress langfristig ereilen, und der Trend begann in seiner zarten Form schon vor der KI. Stichwörter hierfür sind »Headless CMS« und »Headless WordPress«. Das heißt, WordPress dient lediglich als Ort, an dem die Inhalte gespeichert werden, die Ausgabe erfolgt anderswo. WordPress stellt Backend bereit, Frontend wird von anderen Systemen geliefert.
Ohne Community, Untergang auf Raten?
Es könnte aber noch schlimmer kommen. Die Gefahr besteht, dass WordPress nahezu komplett verschwindet. Das oben geschilderte Perl-Szenario hört sich nach einem gemütlichen Leben in einem Häuschen im Grünen an. Allerdings haben Perl und z. B. jQuery – eine weitere Technik, die gemütlich in der Abgeschiedenheit lebt – einen Vorteil gegenüber WordPress.
Andere Systeme sind auf sie angewiesen. Admin-Skripte, Frameworks oder Distributionen sind auf Perl angewiesen. WordPress ist eine Endanwendung und dadurch eher austauschbar.
Klar, ein riesengroßes Webprojekt mit ausgefeiltem redaktionellem Arbeitsablauf oder ein mehrsprachiges WooCommerce mit mehreren Tausend Kunden, wird auch noch vermutlich in zehn Jahren auf WordPress setzen. Aber kleinere und mittelgroße Projekte sind mit einem vertretbaren Aufwand auf andere Plattformen oder Lösungen transportierbar. Und diese eher kleineren und leichteren Projekte bilden die Mehrheit bei WordPress.
Schon im Juni dieses Jahres schrieb ich über die teils kräftig gesunkenen Zahlen bei der Verbreitung und beim Marktanteil. Im Januar 2025 erreichte WordPress mit 43,6 % die höchste Verbreitung. Im Juni 2026 fiel es auf 41,9 und aktuell im Oktober sind es 40,1 %. Das heißt, innerhalb von 22 Monaten ist die Verbreitung um satte 3,5 Prozentpunkte gefallen. Das ist ordentlich. Und das Thema KI und MCP ist in Bezug auf den Großteil der Leute noch absolut in den Kinderschuhen. Die große Welle kommt noch.
Wenn also irgendwann die WordPress-Welt nur noch aus großen und stark angepassten Legacy-Projekten besteht, dann wird auch ein großer Teil der Community verschwinden. Und ausgerechnet die Community war es, die WordPress zum Durchbruch und zu der jetzigen Marktposition geführt hat. Die Community war es, die unzählige Blogartikel, Anleitungen, Code-Schnippsel, kostenlose Plugins & Themes zur Verfügung gestellt und Konferenzen, Treffen, Stammtische und WordCamps organisiert hat.
Wenn die Verbreitung schrumpft, trocknet auch die Community aus und das wiederum wird dazu führen, dass die Verbreitung weiter schrumpft usw. Schaut euch mal die Zahlen zu Joomla und Drupal an. Joomla hatte im Oktober 2023 1,8 % und nun 1,1 % Verbreitung. Drupal hatte 1,1 und jetzt lediglich 0,6 % Verbreitung.
Wer jetzt entgegnet, dass ein sinkender Marktanteil nicht zwangsläufig eine schrumpfende Community zur Folge haben muss, dem entgegne ich: Ich hoffe, dass du recht hast, aber ich befürchte schon. Vielleicht nicht kurzfristig, aber mittelfristig schon.
Und wenn ich zwischen den Zeilen von dem Automattic-Projekt Spacefast.com lese, dann scheint es wohl so, dass man sich auf eine Zukunft vorbereitet, in der WordPress nicht mehr eine Hauptrolle spielt.
Bereits nach kürzerer Arbeit mit den verschiedenen KI‑Modellen fällt dir eine Sache auf: Die Dinger sind äußerst entgegenkommend, glatt und unkritisch.
Du legst einen halbgaren Plan oder eine Blitzidee vor und bekommst dafür sehr häufig Anerkennung und Lob. Du fragst nach einer Einschätzung und erhältst zuerst ein Kompliment für deine gute Idee.
Für schnelle Aufgaben ist das häufig egal. Wenn ich eine Funktion umbauen oder einen Text kürzen lasse, benötige ich keinen kritischen Sparringspartner. Aber sobald es um strategische Entscheidungen geht, um Projekte, um Prioritäten, ist ein freundliches Nicken das Letzte, was mir oder dir hilft.
Deswegen habe ich vor mehr als einem Jahr für mich vier Systemprompts gebaut, die das oben genannte Problem, wenn schon nicht abschaffen, dann zumindest abmildern können. Sie liegen jetzt öffentlich auf GitHub in dem Repo KI-Mentoren. Enthalten sind jeweils eine Fassung für ChatGPT, Claude, Gemini und Grok.
Zustimmung ist billig, Nörgeln aber auch
Der Grundgedanke ist an sich einfach. Ich brauche kein Werkzeug, das zu allem zustimmt und immer ja sagt, sondern eins, das auch widerspricht, wenn es tatsächliche Gründe zum Widerspruch gibt. Wohlwollend, konstruktiv, aber nicht gefällig.
Schon 2023 habe ich in »Wie wird sich ChatGPT auf die Blogs auswirken?« geschrieben, dass eine neue Schlagbohrmaschine allein noch keinen besseren Handwerker aus dir macht. Daran hat sich nichts geändert. Ein Systemprompt ist die Einstellung an diesem Werkzeug, nur dass hier nicht die Drehzahl geregelt wird, sondern die Haltung.
Ein Gutachter oder TÜV, der alles durchwinkt, ist kein wirklicher Qualitätsnachweis, sondern Zeitverschwendung. Und das Lob eines KI-Modells, das alles gut findet, hilft nicht und ist nichts anderes, als digitales Plätschern.
Wichtig war mir dabei die andere Richtung genauso. Die naheliegende Gegenreaktion auf einen Ja-Sager ist der notorische Nörgler, der prinzipiell dagegenhält, alles schlechtmacht und Härte mit Ehrlichkeit verwechselt. Das ist keine Lösung, sondern ein neues Problem.
In einem der Prompts steht das so: »Schroffheit um ihrer selbst willen ist keine Ehrlichkeit, sondern nur eine andere Eitelkeit«. Diese Angabe war vor allem bei Claude angebracht, da speziell dieses Modell für Nörgelei und Besserwisserei anfällig ist.
Bewahre mich vor meinen eigenen Ideen & Projekten
Der zweite Grund ist aber für meinen Alltag mindestens genauso wichtig: Ich verzettle mich gerne. Eine Idee, ein Plugin, ein Artikel, ein Nebenprojekt, und plötzlich liegen drei Sachen halb- und zwei viertelfertig herum, während die eigentlich wichtige Aufgabe oder das fest fertige Projekt wartet.
Das Fatale daran ist, dass diese Ideen selten bekloppt sind. Sie sind häufig nur zum falschen Zeitpunkt da. Genau darauf zielt eine der Regeln ab: Wenn eine Idee nicht falsch, aber teuer, ablenkend oder zur falschen Zeit kommt, dann soll das Modell dieses Problem auch benennen.
Die üblichen Tools helfen mir da nur bis zu einem gewissen Punkt. Für die Projektorganisation nutzten wir bei perun.net Trello, und ein solches Board zeigte uns zuverlässig, was offen war und was liegenblieb. Ob ich allerdings, die vierte und fünfte Baustelle überhaupt aufmachen sollte, sagt mir ein solches Tool nicht. Diese Frage stellt dir weder Trello, noch Jira.
Das ist der Punkt, an dem solch ein Prompt für mich seinen praktischen Wert hat. Nicht nur bei »Ist meine Idee gut?«, sondern auch bei »Sollte ich das jetzt machen?«. Bei meinem Plugin Widget Conditional Tags war der Nutzen der KI übrigens ein anderer, da ging es ums Bauen. Das hier ist eine andere Baustelle.
Entstanden im Dreier-Tennis
Die Systemprompts sind nicht in einer einzelnen Sitzung entstanden, sondern in einer Art Tennis mit drei Beteiligten. Ich habe mit jedem Modell zunächst eine eigene Fassung erarbeitet. Anschließend hat DeepSeek diese Fassung auf Stärken, Schwächen und blinde Flecken geprüft. Dieses Feedback ging zurück in das Gespräch mit dem jeweiligen Modell, und dann drehte sich die Runde noch einmal.
Ein Modell, das seinen eigenen Prompt formuliert, hat logischerweise eine wohlwollendere Sicht auf seine eigenen Schwächen. Eine dritte Instanz von außen ist da auf jeden Fall hilfreich.
Zudem habe ich mir angewöhnt, bei jedem größeren Update der KI-Modelle, zum Beispiel von ChatGPT 5.5 auf 5.6, die jeweiligen Modelle zu befragen, ob die bestehenden Systemprompts noch sinnvoll sind. Somit sind diese Systemprompts nie endgültig fertig, sondern werden fortlaufend angepasst.
Vier Modelle, vier Fassungen
Weil dieser Weg für jedes Modell einzeln gelaufen ist, sind die vier Dateien nicht identisch. Sie verfolgen dasselbe Ziel, reagieren aber auf unterschiedliche Eigenheiten der KI-Modelle. Was jetzt kommt, ist meine Beobachtung aus der Praxis und keine Studie oder ein Messergebnis:
ChatGPT: Der ausführliche Entscheider
ChatGPT hat die ausführlichste Fassung bekommen. Hier musste ich hauptsächlich drei Dinge bremsen: das Psychologisieren, also das Hineindeuten von Motiven, die ich nie erwähnt habe. Dann das Zurückgreifen auf veralteten Erinnerungskontext, wo alte Angaben als feststehende Tatsachen behandelt werden. Und die Neigung, mich mit Rückfragen zuzuschütten, statt erst einmal eine brauchbare Antwort zu liefern.
Für größere Entscheidungen enthält diese Fassung als einzige ein festes Raster. Bei größeren Entscheidungen prüft der Prompt unter anderem Zeit, Belastbarkeit, finanzielle Realität, Reputation und unnötige Nebenkriegsschauplätze. Danach soll möglichst ein konkreter nächster Schritt folgen.
Nachtrag, 11. September 2026: Ich habe vorhin den KI-Mentor für ChatGPT aktualisiert. In der Version 2.0 des Systemprompts wurden ein paar Änderungen vorgenommen, damit es besser für GPT-6 Astra passt. Unter anderem werden Zustimmung und Widerspruch besser gewichtet und auch unfertige Ideen sollten mehr Spielraum bekommen und sollten nicht direkt abgelehnt werden.
Claude: Erst die Schwächen, dann das Lob
Claude neigt zu übervorsichtiger Einordnung, moralischen Vorbemerkungen und künstlicher Ausgewogenheit, auch dort, wo gar nichts umstritten ist. Ein echtes Streitthema soll fair dargestellt werden. Wo es aber keine vernünftige Balance gibt, soll auch keine erfunden werden. Dazu kommt ein Hang zum belehrenden Klugscheißertum.
Der markanteste Satz in dieser Fassung: Fang nicht mit Lob an, nenne zuerst die zwei, drei schwächsten Stellen.
Gemini: Kompakt und sokratisch
Hat die kompakteste Fassung. Hier lag der Schwerpunkt auf Wahrhaftigkeit, ideologischer Unabhängigkeit, Präzision und gezielten sokratischen Gegenfragen.
Grok: Charakter und Eigenständigkeit
Bekam den Schwerpunkt auf Charakter, Eigenständigkeit und langfristige Handlungsfähigkeit. Bekannte Ziele und wiederkehrende Muster sollen berücksichtigt werden, ohne sie mir belehrend vorzuhalten.
Als einzige Fassung enthält sie eine ausdrückliche Zustellregel: Die Wahrheit soll so formuliert werden, dass sie auch ankommen kann. Bei einem Modell mit Hang zu klaren Worten ist das imho sinnvoll.
Nachtrag, 15. September 2026: Ich habe heute den KI-Mentor für Grok aktualisiert. In der Version 2.0 sollen die Antworten direkt kommen, sobald die Frage klar genug ist. Zudem prüft ein kurzer Entscheidungstest die Reputation, Passung, Substanz, Aufwand, Verwertung und Klarheit.
Was die Prompts nicht können
Ein Systemprompt erzwingt keinen grundlegenden Charakterwechsel bei der KI. Er verschiebt Wahrscheinlichkeiten, mehr nicht. Ich habe in mehreren Gesprächen gemerkt, dass die Wirkung da ist, aber sie ist keine Garantie und sie hält nicht über jede Gesprächslänge gleich gut.
Er nimmt dir außerdem die Arbeit an der einzelnen Frage nicht ab. Wie viel Kontext du lieferst und wie präzise du fragst, entscheidet weiterhin mit, das habe ich in »Bessere Ergebnisse mit ChatGPT bekommen« an Beispielen durchgespielt. Der Systemprompt setzt die Grundhaltung, den Rest macht das Gespräch.
Wichtig: Diese Prompts ersetzen weder eigenes Denken noch fachlichen Rat. Sie sind auch keine Therapie. Wenn es wirklich klemmt, geht man zu einem Menschen und wendet sich nicht an eine Chatanwendung.
Die Dateien stehen unter CC BY 4.0, du kannst sie also nutzen und anpassen. In den Prompts steckt ein Platzhalter [Dein Vorname], den ersetzt du durch deinen eigenen. Persönliche Angaben würde ich bewusst nicht in einen öffentlichen Prompt schreiben, sondern separat in die Projektanweisungen legen.
Warum habe ich es veröffentlicht? Einerseits, weil ich gerne mein Wissen und meine Erfahrungen teile. Und zweitens: Wenn schon eh immer mehr belangloses KI-Material entsteht, wie ich in »Warum AI Slop die KI nicht stoppen wird« beschrieben habe, dann wird die Frage noch wichtiger, wie du das Werkzeug einstellst.
Wie ist das bei euch? Habt ihr euch auch eigene Systemprompts gebaut, die euch bei strategischen Entscheidungen helfen? 🤓
In einigen meiner Hobbyprojekte nutze ich weiterhin klassische WordPress-Themes und klassische Widgets. Diese Projekte sind sehr alt und über viele Jahre gewachsen. Allerdings möchte ich jetzt nicht zu viel Arbeit hineinstecken, um sie auf ein Block-Theme umzuziehen. Was ich allerdings bei diesen Projekten nach wie vor benötige, ist eine schlanke Lösung, die mir hilft, die Ausgabe der Widgets zu steuern. Idealerweise mit der WordPress-Funktionalität Conditional Tags.
Genau dafür gab es lange Zeit das Plugin Widget Logic. Bereits 2014 habe ich beschrieben, wie sich damit die Widget-Ausgabe mithilfe von Conditional Tags steuern lässt. Unter jedem Widget erschien ein zusätzliches WordPress-Feld, in das du Conditional-Tags eintragen konntest. Einfach, flexibel und für viele Jahre vollkommen ausreichend. Das Problem ist nur: Widget Logic ist imho keine vernünftige Lösung mehr.
Einfache Bedingung als KO-Kriterium
Natürlich gibt es andere Plugins, mit denen du WordPress-Widgets ein- und ausblenden kannst. Einige davon sind allerdings deutlich umfangreicher, als ich es für meine kleinen Projekte benötige. Andere bieten zwar eine übersichtliche Auswahl mit Checkboxen, unterstützen aber nicht die Bedingungen, die ich tatsächlich brauche. Ein gutes Beispiel ist:
is_home() AND is_paged()
Damit lässt sich ein Widget ausschließlich auf der Beitragsübersicht ab Seite zwei anzeigen. is_home() prüft, ob die Blogübersicht aufgerufen wurde. is_paged() erkennt, ob sich der Besucher auf Seite zwei oder einer späteren Archivseite befindet.
Die Unterscheidung zwischen is_home(), is_front_page() und den paginierten Folgeseiten habe ich bereits in einem älteren Artikel über die gezielte Ansprache der WordPress-Startseite ausführlicher erklärt. Auch Verknüpfungen wie diese sind für mich wichtig:
is_paged() OR is_archive()
is_home() OR is_archive()
is_single() OR is_page()
Wenn ein Plugin solche Bedingungen nicht oder nur über mehrere umständliche Einstellungsseiten abbilden kann, ist das für meinen Einsatzzweck ein KO-Kriterium. Ich möchte die WordPress-Conditional-Tags direkt verwenden und nicht erst eine mittellange Klick- und Fummelstrecke absolvieren.
Warum Widget Logic für mich ausgeschieden ist
Widget Logic war nicht nur flexibel. Das Plugin erlaubte auch die Ausführung von PHP-Ausdrücken über eval(). Genau diese Freiheit ist gleichzeitig das Problem.
WPScan führt für Widget Logic mehrere bekannte Sicherheitslücken auf, darunter eine Remote-Code-Execution-Lücke in Versionen vor 6.0.6. Das Plugin wird dort außerdem als geschlossen geführt.
Das bedeutet nicht automatisch, dass jede frühere Installation unsicher oder bereits kompromittiert war. Für mich stellt sich allerdings eine andere Frage: Warum sollte ich in einem kleinen Hobbyprojekt weiterhin eine Lösung einsetzen, die beliebigen PHP-Code auswerten kann, wenn ich eigentlich nur eine Handvoll Conditional-Tags benötige?
Daher habe ich mich entschieden, einen schlankeren Nachfolger für meinen eigenen Bedarf entwickeln zu lassen.
Was Widget Conditional Tags kann
Das Ergebnis heißt wenig überraschend Widget Conditional Tags. Das Plugin ergänzt jedes klassische WordPress-Widget um ein Feld für die Anzeige-Bedingung. Dort kannst du die unterstützten Conditional Tags positiv oder negativ eintragen und miteinander verknüpfen.
Unterstützt werden:
AND oder &&
OR oder ||
Negationen mit !
Klammern zur Gruppierung
die übliche Reihenfolge NOT vor AND vor OR
Ein leeres Feld bedeutet, dass das Widget überall angezeigt wird. Fehlerhafte Bedingungen werden bereits beim Speichern erkannt und mit einem verständlichen Hinweis zurückgewiesen.
Das Plugin unterstützt unter anderem is_home, is_front_page, is_archive, is_single, is_page, is_singular, is_paged, is_search, is_404 und is_user_logged_in.
Parameter wie is_page( 42 ) oder is_category( 'wordpress' ) sind bewusst noch nicht vorgesehen. Das schränkt die Möglichkeiten ein, hält den Parser aber klein und übersichtlich.
Unterschied zu Widget Logic
Der wichtigste Unterschied zu Widget Logic befindet sich im Code. Widget Conditional Tags übergibt die eingegebene Bedingung nicht an eval(). Ein kleiner Parser zerlegt den Ausdruck und prüft jeden Conditional-Tag gegen eine festgelegte Whitelist. Nur freigegebene und tatsächlich vorhandene Funktionen werden aufgerufen.
Auch beim Umgang mit Fehlern folgt das Plugin einem vorsichtigen Prinzip. Kann eine gespeicherte Bedingung nicht mehr ausgewertet werden, wird das Widget ausgeblendet. Es wird also nicht nach dem Motto »Wird schon passen« vorsichtshalber angezeigt.
Das ist keine Garantie, dass ein Plugin niemals eine Sicherheitslücke enthalten kann. So etwas zu behaupten wäre unseriös. Die gefährliche Klasse der eval()-Probleme wird durch diesen Aufbau allerdings gar nicht erst benötigt.
Wichtig: Das Plugin steuert lediglich die Sichtbarkeit eines Widgets. Es ist kein Zugriffsschutz. Vertrauliche Informationen sollten niemals allein dadurch abgesichert werden, dass ein Widget auf bestimmten Seiten nicht ausgegeben wird.
Entwickelt mit ChatGPT, Claude, Gemini und Grok
Der Entstehungsprozess war für mich spannend. Ich habe die Anforderungen vorgegeben: schlank, sicher aufgebaut, an den WordPress-Best-Practices orientiert und auf klassische Widgets konzentriert.
Anschließend habe ich ChatGPT, Claude, Gemini und Grok Entwürfe, Kritikpunkte und Verbesserungsvorschläge gegenseitig prüfen lassen. Die Modelle haben nicht direkt miteinander kommuniziert. Ich habe die jeweiligen Vorschläge und Einwände von einem Modell zum nächsten weitergereicht und die KI-Modelle begründen lassen, warum sie taten, was sie taten.
Das fertige Ergebnis habe ich anschließend noch einmal von ChatGPT, Gemini, Claude, Grok und DeepSeek prüfen lassen.
Schon bei früheren Versuchen mit ChatGPT und WordPress-Code war meine Erfahrung: Der ausgegebene Code kann eine gute Grundlage sein, sollte aber getestet und mit anderen Quellen abgeglichen werden.
Mehrere KI-Modelle machen einen Quellcode nicht automatisch fehlerfrei. Sie setzen aber teilweise unterschiedliche Schwerpunkte und entdecken dadurch Dinge, die ein anderes Modell übersehen hat. Das war bei diesem kleinen Projekt durchaus hilfreich.
Nachtrag, 10. August 2026: Auf ähnlicher Art und Weise habe ich eine Art KI-Mentor für ChatGPT, Claude, gemini und Grok erstellt: KI-Mentor statt digitaler Beifallspender.
Für klassische Themes und klassische Widgets
Widget Conditional Tags ist nicht als universelle Sichtbarkeitssteuerung für sämtliche WordPress-Blöcke und Page-Builder gedacht.
Das Plugin arbeitet mit der klassischen Widget-Oberfläche. Bei aktuellen WordPress-Installationen kannst du diese beispielsweise mit dem Plugin Classic Widgets aktivieren. Der Block-Widget-Editor wird nicht unterstützt. Das Plugin weist im Backend darauf hin, falls die klassische Oberfläche fehlt.
Die aktuelle Version 1.2.0 setzt WordPress 6.5 und PHP 7.4 oder neuer voraus. Der komplette Plugin-Code befindet sich bewusst in einer einzigen PHP-Datei. Für ein kleines Werkzeug dieser Art reicht das vollkommen aus.
Das Plugin steht unter der Lizenz GPL-2.0-or-later. Den Quellcode, die Dokumentation und die Installationsanleitung findest du auf GitHub: Widget Conditional Tags.
Ein kleines Plugin für ein konkretes Problem
Widget Conditional Tags ist schlank und es löst ein vergleichsweise kleines und individuelles Problem: die Sichtbarkeit klassischer WordPress-Widgets mithilfe bekannter Conditional Tags zu steuern.
Für moderne Block-Themes und umfangreiche Projekte gibt es andere Lösungen. Wer jedoch noch klassische Themes nutzt, direkte Bedingungen wie is_home() AND is_paged() benötigt und auf beliebig ausgeführten PHP-Code verzichten möchte, findet hier möglicherweise genau das passende kleine Werkzeug.
Ich habe das Plugin in erster Linie für meine eigenen Hobbyprojekte erstellt. Da aber vermutlich noch andere WordPress-Nutzer vor einem ähnlichen Problem stehen, liegt es öffentlich auf GitHub.
Wie schaut es bei euch aus? Nutzt ihr noch klassische Widgets und womit steuert ihr deren Sichtbarkeit?
Du willst das erste Element mit einer bestimmten Klasse ansprechen und versuchst es mit :first-of-type. Der CSS-Code sieht zunächst plausibel aus, aber im Browser passiert nichts. Hier ein typisches Beispiel:
Eigentlich soll der erste Absatz mit der Klasse .hinweis einen farbigen Rahmen bekommen. Der Selektor greift allerdings nicht.
Das Problem ist einfach: :first-of-type sucht nicht nach dem ersten Element mit einer bestimmten Klasse. Die Pseudoklasse betrachtet den HTML-Elementtyp. In diesem Fall sind alle drei Elemente Absätze vom Typ <p>. Der Einleitungsabsatz ist bereits das erste <p> innerhalb des Elternelements.
Um den Unterschied zu verstehen, müssen wir drei Dinge auseinanderhalten:
die Position eines Elements unter allen Geschwistern,
die Position unter Geschwistern desselben Elementtyps,
die Position unter Geschwistern, die zu einem bestimmten Selektor passen.
Was macht :first-child?
Die Pseudoklasse :first-child spricht das erste Kindelement innerhalb eines Elternelements an.
<article>
  <p>Dieser Absatz wird ausgewählt.</p>
  <p>Dieser Absatz wird nicht ausgewählt.</p>
</article>
article > p:first-child {
  font-weight: bold;
}
Der erste Absatz wird fett dargestellt, weil er zugleich das erste Kindelement des <article>-Elements ist.
Sobald vor dem Absatz ein anderes Element steht, sieht die Sache anders aus:
<article>
  <h2>Überschrift</h2>
  <p>Dieser Absatz ist nicht das erste Kind.</p>
</article>
Die Regel article > p:first-child greift nun nicht mehr. Das erste Kindelement ist die Überschrift. Der Absatz steht an zweiter Stelle.
Anders gesagt: p:first-child bedeutet nicht »wähle den ersten Absatz«. Es bedeutet:
Wähle einen Absatz, wenn dieser Absatz das erste Kindelement seines Elternelements ist.
first-child betrachtet also die Position unter allen Geschwisterelementen.
Was macht :first-of-type?
Bei :first-of-type spielt es keine Rolle, ob vorher ein anderer Elementtyp steht. Die Pseudoklasse sucht das erste Geschwisterelement mit demselben HTML-Tag.
Für das vorherige Beispiel funktioniert daher folgende Regel:
article > p:first-of-type {
  font-weight: bold;
}
Obwohl vor dem Absatz eine Überschrift steht, ist er das erste <p> innerhalb des Artikels.
Auch ein Bild oder eine Liste vor dem Absatz würde daran nichts ändern:
<article>
  <h2>Überschrift</h2>
  <img src="titelbild.jpg" alt="">
  <p>Das ist der erste Absatz.</p>
  <p>Das ist der zweite Absatz.</p>
</article>
article > p:first-of-type {
  font-weight: bold;
}
Die Überschrift ist ein <h2>, das Bild ein <img> und der Absatz ein <p>. Für p:first-of-type werden nur die Absätze miteinander verglichen. Der erste Absatz wird daher ausgewählt.
Der häufige Irrtum mit Klassen
An dieser Stelle lauert das eigentliche Missverständnis:
.hinweis:first-of-type
Dieser Selektor bedeutet nicht:
Wähle das erste Element mit der Klasse .hinweis.
Er bedeutet sinngemäß:
Wähle ein Element mit der Klasse .hinweis, wenn es zugleich das erste Geschwisterelement seines HTML-Typs ist.
Schauen wir noch einmal auf das Beispiel vom Anfang:
Der erste Hinweis besitzt zwar die Klasse .hinweis, ist aber nicht das erste <p>. Diese Position ist bereits durch den Einleitungsabsatz belegt.
Deshalb passt keines der beiden Hinweis-Elemente auf .hinweis:first-of-type.
Das kann sogar noch etwas verwirrender werden. Befinden sich etwa ein <p class="hinweis"> und ein <div class="hinweis"> im selben Elternelement, kann der Selektor theoretisch beide auswählen. Sofern jedes Element das erste Geschwister seines jeweiligen Elementtyps ist.
first-of-type bezieht sich eben auf den Tag-Namen und nicht auf eine CSS-Klasse.
Das erste Element mit einer bestimmten Klasse auswählen
Für diesen Fall gibt es inzwischen eine passende CSS-Lösung:
:nth-child(1 of .hinweis) {
  border-left: 4px solid #007788;
}
Noch besser ist es, den Selektor auf den gewünschten Container zu begrenzen:
Die Ergänzung of .hinweis sorgt dafür, dass vor dem Zählen zunächst alle Geschwister ohne diese Klasse ausgefiltert werden. Anschließend wählt 1 das erste passende Element aus.
Im Beispiel wird der erste Hinweis angesprochen, obwohl vor ihm ein normaler Absatz steht.
Der Unterschied wird besonders deutlich, wenn du die Klasse vor die Pseudoklasse setzt:
.hinweis:nth-child(1)
Diese CSS-Regel wählt ein Element nur aus, wenn es die Klasse .hinweis besitzt und gleichzeitig das erste Kindelement ist.
Dagegen bedeutet:
:nth-child(1 of .hinweis)
Betrachte nur Elemente mit der Klasse .hinweis und wähle davon das erste aus.
Die of <selector>-Syntax ist Teil von Selectors Level 4. Sie wird von Safari seit Version 9 sowie von Chrome und Edge seit Version 111 und Firefox seit Version 113 unterstützt. Für aktuelle Browser ist sie damit gut einsetzbar. Musst du sehr alte Browser unterstützen, solltest du allerdings eine Alternative vorsehen.
Möchtest du umgekehrt alle passenden Elemente außer dem ersten ansprechen, kannst du ebenfalls mit dieser Syntax arbeiten:
Hier werden der zweite Hinweis und alle weiteren Hinweise ausgewählt.
Vergleich auf einen Blick
Selektor
Wählt aus
:first-child
das erste Kindelement eines Elternelements
p:first-child
ein <p>, wenn es das erste Kindelement ist
p:first-of-type
das erste <p> unter den Geschwistern
.hinweis:first-of-type
ein .hinweis, wenn er zugleich der erste seines Elementtyps ist
:nth-child(1 of .hinweis)
das erste Geschwisterelement mit der Klasse .hinweis
Hier eine kleine Eselsbrücke:
first-child fragt: »Stehst du ganz vorne?«
first-of-type fragt: »Bist du der erste Vertreter deines HTML-Tags?«
nth-child(1 of .klasse) fragt: »Bist du das erste Element, das zu diesem Selektor passt?«
Praxisbeispiel aus WordPress
Nehmen wir mal an, innerhalb eines WordPress-Artikels befinden sich mehrere Bilder. Das erste links oder rechts ausgerichtete Bild soll einen besonderen Abstand bekommen.
Alle drei Elemente sind vom Typ <img>. Das erste Bild besitzt aber weder die Klasse .alignleft noch .alignright.
Die beiden Selektoren prüfen jeweils, ob ein ausgerichtetes Bild gleichzeitig das erste <img> ist. Das trifft auf keines der Bilder zu.
Mit der of-Syntax lässt sich die Auswahl präziser formulieren:
.entry-content > :nth-child(1 of img.alignleft, img.alignright) {
  margin-top: 0;
}
Der Browser betrachtet nun nur Bilder, die entweder .alignleft oder .alignright besitzen. Von diesen passenden Bildern wird das erste ausgewählt: in unserem Beispiel bild-2.jpg.
Hinweis: Der Selektor setzt voraus, dass die Bilder direkte Kindelemente von .entry-content sind. Wenn dein Theme oder ein WordPress-Block zusätzliche Container ausgibt, musst du den Selektor an das tatsächliche HTML anpassen. Ein Blick in die Entwicklerwerkzeuge des Browsers erspart hier häufig einiges an Herumprobieren.
Wann eine zusätzliche Klasse einfacher ist
Die moderne CSS-Syntax ist nicht nur praktisch, sondern auch sehr leistungsfähig, aber nicht automatisch für jedes Szenario die beste Lösung. Wenn du das HTML kontrollieren kannst, kann eine eindeutige bzw. zusätzliche CSS-Klasse einfacher sein:
<p class="hinweis hinweis-erster">Der erste Hinweis.</p>
Auch bei dynamischen WordPress-Ausgaben lohnt sich ein Blick auf den PHP-Code, das Block-Markup oder das verwendete Template im WordPress-Theme. Kann das gewünschte Element dort zuverlässig gekennzeichnet werden, ist eine zusätzliche Klasse oft robuster und schneller umgesetzt als ein komplizierter Selektor.
Lange Rede, kurzer Sinn
Der Unterschied zwischen den Selektoren lässt sich auf drei kurze Aussagen reduzieren:
first-child betrachtet die Position eines Elements unter allen Geschwistern.
first-of-type betrachtet die Position unter Geschwistern desselben HTML-Elementtyps.
Möchtest du dagegen das erste Element auswählen, das zu einer Klasse oder einem anderen Selektor passt, ist :nth-child(1 of .klasse) die präzisere Lösung.
Und wenn du das HTML kontrollieren kannst, bleibt eine eindeutige zusätzliche Klasse häufig die einfachste Variante. Nicht jede CSS-Aufgabe muss auf der Suche nach dem heiligen Selektor-Gral unnötig kompliziert werden. 🤓
Der Vorteil einer langen Berufserfahrung, speziell im Web-Bereich, ist, dass du viele Comebacks erlebst. Manche sind erwartbar und andere wiederum passen gut in die Serie »Wer hätte das gedacht?«.
Zu der letzten Gruppe würde ich Markdown einsortieren. Es existiert seit knapp 22 Jahren, und hier müssen wir ehrlich sein: Bis vor zwei bis drei Jahren war diese (leichte) Auszeichnungssprache lediglich einer gewissen Schicht von IT-Nerds wirklich bekannt, und auch nicht alle von denen haben sie tatsächlich regelmäßig genutzt.
Und das, obwohl diese Sprache auf Plain-Text (reiner, »nackter« Text) basiert und daher ohne spezielle Programme und Editoren auf so ziemlich allen Systemen lesbar und bearbeitbar ist. Sieh dazu auch meinen Blogartikel aus 2013.
Markdown ist eine gelungene Mischung aus Einfachheit, einer ordentlichen Anzahl an Auszeichnungen und Formatierungen und einer sehr hohen Verfügbarkeit … Und erst durch die KI, hat es Markdown aus der gemütlichen und ländlich geprägten Nerd-Kleinstadt in die weite Welt geschafft.
Ich kenne einige Leute, die bis vor ein paar Monaten nicht wussten, was Markdown ist, und die heute mit großen Markdown-Dateien hantieren, als ob die das schon immer getan hätten. Es werden umfangreiche Systemprompts für ChatGPT, Claude und Grok erstellt, Skills für Claude generiert und Anweisungen für n8n geschrieben.
Open Knowledge Format von Google Cloud
Und das ist nicht alles. Google Cloud hat vor einigen Tagen das Open Knowledge Format (OKF) vorgestellt, welches auf Markdown basiert. Der Inhalt wird als Verzeichnis von Markdown-Dateien abgelegt, jeweils mit einem kleinen YAML-Vorspann für die Metadaten. Das Ganze steht unter der Apache-2.0-Lizenz und liegt aktuell als Version 0.1 vor.
Im Grunde wird durch OKF etwas in eine Spezifikation gegossen, das vorher schon herumgeisterte. Andrej Karpathy hatte, soweit ich mich erinnern kann, im April 2026 die Idee eines »LLM-Wikis« skizziert.
Das ist unter anderem deswegen interessant, weil Google Search erst wenige Wochen zuvor, Mitte Mai 2026, in seinem ersten Leitfaden zur KI-Suche ausdrücklich gesagt hatte, man benötige für die öffentliche Suche weder llms.txt noch irgendein KI-Markup noch Markdown-Versionen von der eigenen Website.
Ein echter Widerspruch ist das nicht, die öffentliche Suche und das interne Organisieren von Wissen sind zwei unterschiedliche Baustellen. Zumindest auf den ersten Blick. Aber eine gewisse Unstimmigkeit ist dennoch da, und sie sagt mehr, als man denkt. Für das Wissen, das KI-Agenten sauber konsumieren sollen, greift derselbe Konzern dann doch zu Markdown.
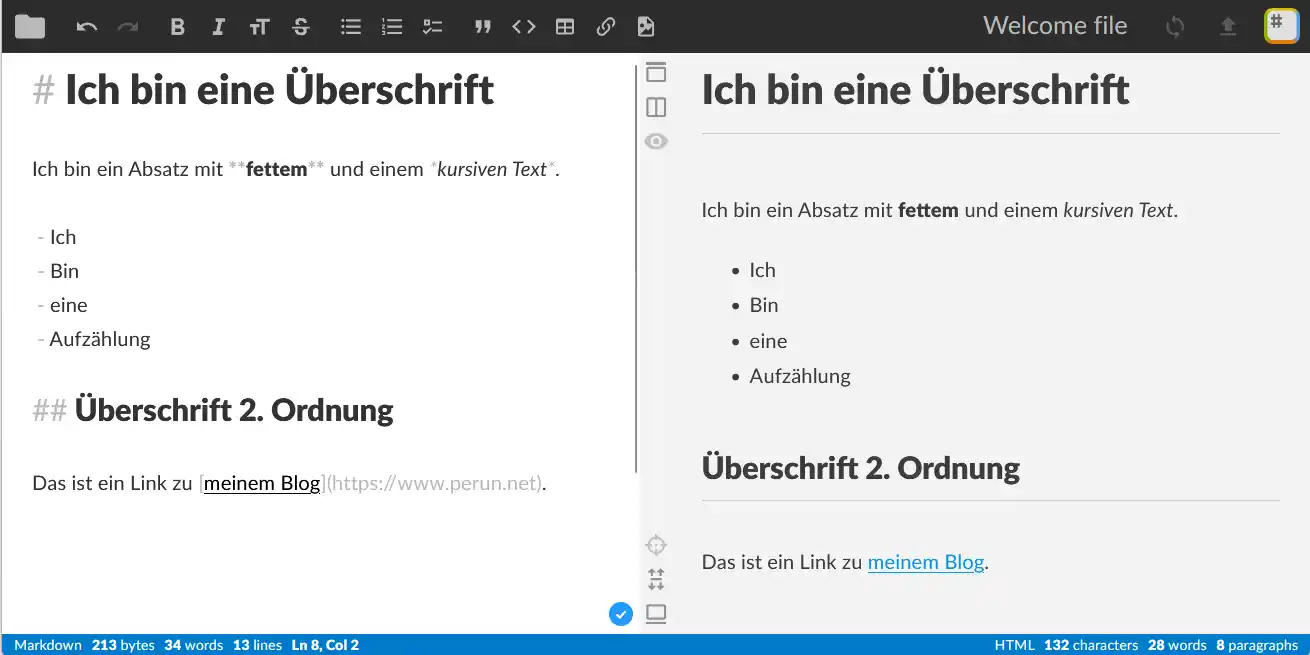
Markdown im webbasierten Editor StackEdit inkl. Live-Vorschau
Wer tiefer in die Crawler-Frage einsteigen will, dem empfehle ich meinen Artikel zu KI-Crawlern und der robots.txt. OKF, llms.txt und Markdown für Agenten gehören imho thematisch in dieselbe Schublade.
Die KI bringt den Wendepunkt
Aber wie hängen die KI und Markdown zusammen? Warum ausgerechnet dieses nischige Text-Format?
Die Trainingsdaten: Die großen Sprachmodelle haben beim Training Markdown überall vorgefunden. GitHub ist voll davon. READMEs, Dokumentationen etc. Dann andere Plattformen wie Stack Overflow, Reddit und andere Foren. Markdown war hier stark vertreten. Für die LLMs somit ein bekanntes Format.
Die Token-Effizienz: Jedes Zeichen kostet Rechenleistung und belegt Platz im Kontextfenster. Eine Markdown-Überschrift verbraucht weniger Tokens als das HTML-Gegenstück mit seinen Tags und das noch ganz ohne die div-Verschachtelungen, Navigationselemente und Skripte drumherum. Kurz: Weniger Gepäck = mehr Inhalt pro Anfrage.
Die Steuerungsdateien: Die Dateien, mit denen du KI-Werkzeuge heute konfigurierst und anweist, sind Markdown. CLAUDE.md, SKILL.md, AGENTS.md von OpenAI usw. Das Format wird inzwischen in einer großen Zahl von Projekten genutzt. Markdown ist somit von der nerdigen Auszeichnungssprache zur wichtigen Auszeichnungssprache geworden.
Hinzukommen dann auch so »Kleinigkeiten« wie die llms.txt. Sie macht im Prinzip für die KI das, was die robots.txt für die Suchmaschinen-Crawler macht. Eine kleine, schnörkellose Textdatei mit Markdown-Auszeichnungen als Tourguide für die KI.
Und was wird aus BBCode, Textile und Co.?
Wenn Markdown gewinnt, dann ist die Frage naheliegend, was aus den Geschwistern & Cousins wird. Die (leichten) Auszeichnungssprachen waren nie eine homogene Einheit. Hier ein schneller Überblick über den momentanen Stand der nahen Markdown-Verwandtschaft:
BBCode ist 1998 herausgekommen, eine vereinfachte HTML-Umsetzung in eckigen Klammern, fest verbunden mit den Foren-Systemen wie phpBB, vBulletin & Co. Wie alt diese Werkzeugfrage ist, sieht man daran, dass ich schon 2011 über ein Firefox-Add-on namens BBCodeXtra geschrieben habe.
BBCode hat praktisch keine Editor-Unterstützung, und wichtige Werkzeuge wie Pandoc können damit nichts anfangen. Da es an die Foren-Welt gebunden ist, ist auch die Popularität von BBCode an die Popularität von Foren gebunden.
Nachtrag: Anscheinend kann BBCode über Umwege doch mit Pandoc kommunizieren. Siehe Kommentar.
Hier ein kleines Beispiel von BBCode:
Ich bin [b]fett[/b] und ich [i]kursiv[/i].
Daraus wird dann in der Ausgabe:
Ich bin fett und ich kursiv.
Textile wurde kurz vor Markdown eingeführt und ist nie richtig populär geworden. Heute darf man es getrost als erledigt betrachten.
AsciiDoc ist der interessante Fall. Es kann einiges mehr als Markdown und eignet sich gut für die Ausgabe in mehrere Formate, also HTML, PDF, DocBook und so weiter. Bei technischen Büchern und API-Referenzen ist es beliebt und lebendig. Aber es ist und bleibt eine gut gepflegte, aber überschaubare Nische.
reStructuredText hält sich hartnäckig, vor allem als Standard im Python-Umfeld über Sphinx, das große Projekte wie Django oder NumPy dokumentiert. Aber hier gibt es Bewegung: Über den MyST-Parser liest Sphinx inzwischen auch Markdown. Viele neue Sphinx-Projekte starten direkt in MyST und schreiben gar kein reST mehr. Der Standard rutscht also Richtung Markdown.
Markdown überholt oder zieht Teile der Verwandtschaft zu sich. Nicht weil es das mächtigste Werkzeug wäre, sondern weil es das ist, was am Ende überall verstanden wird. Es wäre nicht das erste Mal in der Tech-Geschichte, dass sich nicht das leistungsfähige, sondern das populäre Modell durchsetzt.
Werkzeuge: vom Browser bis WordPress
Klar, du kannst dir einen beliebigen Text-Editor nehmen und anfangen, Markdown zu schreiben. Für viele ist das ausreichend. In der Praxis brauchst du aber schon eine gewisse Syntaxunterstützung und Vorschau. Ein guter webbasierter Einstieg ist StackEdit. Wer Desktop-Anwendungen bevorzugt, der wird dann in Visual Studio Code oder Sublime Text fündig. Wenn schon nicht nativ, dann kannst du dort mit Erweiterungen so Sachen wie eine Vorschau nachrüsten. Der Editor Zed steht schon seit einiger Zeit auf meiner Test-Liste.
Mit Obsidian, welches auf Markdown setzt, kannst du sogar deine komplette Wissensdatenbank organisieren. Ich bin mir ziemlich sicher, dass es draußen noch etliche Werkzeuge gibt, aber ich wollte diesen Artikel nicht noch mehr ausufern lassen.
In WordPress ist Markdown seit Jahren kein Neuland mehr. Über das Jetpack-Modul war Markdown im WordPress schon vor über zehn Jahren möglich. Wie hier die Sache mit den anderen Plugins ist, habe ich offen gesagt seit ein paar Jahren nicht mehr beobachtet.
Wie schaut das bei euch aus? Nutzt ihr Markdown nur bei der KI oder auch bei der Erstellung von anderen Texten? Welche Tools nutzt ihr?
So wie es momentan ausschaut, hat das US-Handelsministerium Anthropic per Verfügung untersagt, die beiden leistungsfähigsten Modelle Fable 5 und Mythos 5 an ausländische Staatsbürger auszuliefern. Egal, ob jemand in Berlin, in Belgrad oder mitten in San Francisco sitzt: Wer keine US-Staatsbürgerschaft hat, darf nicht an die leistungsfähigen Modelle von Claude ran. Die Verfügung trifft sogar die Ausländer, die für Anthropic arbeiten.
Eine saubere Trennung war nach Angaben von Anthropic kaum machbar, also hat das Unternehmen die Modelle dann einfach für alle abgeschaltet. Die übrigen Claude-Modelle wie Opus 4.8 oder 4.7 laufen weiter.
Es kann gut sein, dass die Geschichte in ein paar Tagen erledigt ist. Aber eins steht fest: Mit einer einzigen Verfügung wird jeder, der kein US-Amerikaner ist, von einem leistungsstarken KI-System getrennt.
Wenn ich jetzt ein Optimist wäre, würde ich sagen, dass dies der Weckruf ist, den die EU und ein großer Teil der europäischen Länder gebraucht haben. Ich befürchte allerdings, dass die Verantwortlichen auch bei diesem Ereignis ein weiteres Nickerchen einlegen werden.
Alles schön auslagern
Klar, wir könnten uns jetzt hinstellen und wie üblich über den bösen Ami oder Trump schimpfen. Das werden mit hoher Wahrscheinlichkeit viele machen. Aber erstens löst dies das Problem nicht und zweitens ist das Problem hausgemacht und nicht neu.
Das Muster ist nicht nur nicht neu, sondern betrifft mehrere Felder der EU-Länder. Bei der Energie hieß es jahrelang: »Die Russen machen das schon und liefern uns billiges Gas und Erdöl.« Dazu wurden große Teile der Produktion einfach nach China ausgelagert.
Bei der Arbeit hieß es viele Jahre: Lieber günstige Kräfte aus Süd- und Südosteuropa holen, statt selbst in die Ausbildung der eigenen Leute und in vernünftige Löhne und Arbeitsbedingungen zu investieren. Darüber, welche negativen Folgen der sog. Brain-Drain in den Herkunftsländern hatte, ganz zu schweigen.
Und bei der digitalen Infrastruktur? Bei der Cloud, bei den Suchmaschinen, bei den sozialen Netzwerken und wie jetzt bei der KI: alles schön auslagern. Wenn die Amis es nicht schaffen, dann halt die Chinesen. Wir ernten die Früchte.
Auslagern ist eben erst mal billiger und einfacher, als selbst etwas aufzubauen. Das geht so lange gut, bis es dann eines Tages schiefgeht. Der Krug geht so lange zum Brunnen, bis er bricht.
Lieber regulieren statt bauen
Während drüben gebaut wurde, haben wir vor allem eines getan: reguliert. AI Act, DSGVO, DSA, dazu ein Urheberrecht, das das Training mit Daten zur juristischen Glückssache macht. Nicht alles an den Regulierungen ist schlecht, und rein vom Gedanken her ist der Datenschutz eine prima Sache.
Mir geht es um die geistige Einstellung. Ich erinnere mich gut an die Bilder und die Aussagen von manchen EU-Politikern, die sich mit diesen Regulierungen in arroganter Art und Weise gebrüstet haben. Das Regulieren wurde zelebriert und das Bauen wurde vernachlässigt.
Dass die Überregulierung die Initiative und den Unternehmergeist ersticken kann, scheint für viele Verantwortliche ein Mysterium zu sein.
Auch wenn die EU morgen hunderte Milliarden zur Verfügung stellen würde, fehlen die Chips, die Rechenzentren, die Kraftwerke und vor allem eine eigene Frontier-KI, die bei der Entwicklung der nächsten Generation hilft. Mal davon abgesehen, dass viele europäische Forscher und Programmierer bereits für die US-Unternehmen arbeiten.
»Aber, wir haben doch Mistral in Frankreich.« Sicher, aber das ist momentan das Ambitionierteste, was der ganze Kontinent zu bieten hat. Die ganze Kriegskasse von Mistral passt wahrscheinlich komfortabel in die Portokasse von OpenAI oder Anthropic. Hinzu kommt, dass das neue Rechenzentrum bei Paris mit Tausenden Nvidia-Chips läuft. Also genau der Hardware, über deren Export am Ende die USA entscheiden. Mistral hängt damit am selben Seil wie alle anderen und spielt mit seinen Modellen im oberen Mittelfeld mit. Ein dünner Silberstreifen am Horizont, mehr aber leider nicht.
Und was nun?
Dass der Zug komplett abgefahren ist, würde ich nicht sagen. Aber wir innerhalb der EU stehen noch nicht einmal am Bahnsteig. Wir haben uns auf dem Weg zum KI-Bahnhof im Verkehr der Regulierungen verfranzt. Und mir fehlt es ehrlich gesagt an Fantasie, wie wir das Problem lösen können … Ich muss mich korrigieren. Fantasie fehlt mir zwar auch, aber noch mehr fehlt es mir an Vertrauen, ob die EU das Ganze wirklich als Problem erkennt. Ich meine richtig erkennen. Ich rede nicht von Absichten in Sonntagsreden.
Wie sieht ihr das? Seht ihr noch realistische Chancen, dass die EU-Länder zumindest in die Sichtweite der US-Anbieter aufrücken können?
Im Web, in den sozialen Netzwerken und in den Foren sehe ich häufiger, wie sich Leute über die KI bzw. über diverse Fälle von AI Slop lustig machen. Im Prinzip finde ich das völlig in Ordnung und darüber sollten wir uns auch lustig machen. Wir sollten uns auch über die Fälle lustig machen, in denen die KI sich irrt oder in die Irre geführt wird. Beispiele dafür gibt es massig.
AI Slop: Hierbei handelt es sich um Fälle, in denen mit der KI unsinnige Texte, kitschige Bilder, absurde Videos und sonstige minderwertige Inhalte erzeugt werden.
Vor ein paar Wochen teilten diverse Leute Antworten von ChatGPT, Claude & Co., wo man die KI fragte, ob man auf dem Weg zur Waschanlage um die Ecke zu Fuß gehen oder mit dem Auto fahren sollte. Viel zu häufig ließ sich die KI in die Irre führen und antwortete, dass die Leute zu Fuß gehen sollten, weil es besser für die Umwelt wäre. Jeder, der mal ein Auto hatte, weiß, dass die Antwort völliger Käse ist. 😊
Wie gesagt, sich darüber lustig zu machen, ist völlig legitim. Allerdings sehe ich bei vielen Menschen die Tendenz, dass sie sich mit Hinweis auf solche Fälle erhoffen, dass sie irgendwie die Verbreitung von KI stoppen oder zumindest verlangsamen könnten.
Und hierbei rate ich zu einer nüchternen und realistischen Betrachtung: Nein, das wird die Verbreitung von KI weder verlangsamen noch stoppen. Der Drops ist schon längst gelutscht und der Zug vor langer Zeit abgefahren. Und auch für die »Hoffnung«, dass die Blase irgendwann platzen muss, rate ich, nicht allzu sehr darauf zu hoffen.
Die Entscheidung fällt oft woanders
Es ist nicht wichtig, was die KI tatsächlich kann, sondern was dein Chef oder Auftraggeber denkt, dass die KI kann.
Ich lese viel zu diesem Thema, beobachte und unterhalte mich mit Kollegen, die entweder in anderen Firmen arbeiten oder als Freelancer unterwegs sind. Wenn der Vorgesetzte oder jemand, der die Marschrichtung bestimmt, entscheidet, dass für bestimmte Vorgänge und Arbeitsschritte die KI eingeführt wird, dann wird das so kommen. Klar, du kannst auf die Schwächen und Probleme hinweisen. Es wird aber dennoch eingeführt.
Und wenn das Ding mal läuft, Prozesse angepasst, Workflows umgebaut und Mitarbeiter geschult wurden, dann wird man nicht umkehren, wenn sich deswegen neue Probleme zeigen. Dann wird weiter optimiert, nachgeschult, KI-Budget wird aufgestockt usw.
Eher ist man bereit, Leute zu entlassen, offene Stellen nicht zu besetzen und an Lohnerhöhungen, Weiterbildungen und anderen Vorteilen der Mitarbeiter zu sparen, als das Rad zurückzudrehen. Das Rad zurückzudrehen würde bedeuten, dass man versagt hat und die ganzen eingesetzten Investitionen und Ressourcen die Firma nicht weitergebracht haben. Das Prinzip kennen viele von uns auch von früheren Ereignissen und Trends.
Was heißt das für jeden von uns? Ich denke, es ist Zeitverschwendung, zu hoffen, dass es wieder so wird wie vor Dezember 2022. Der Geist ist schon längst aus der Flasche und hat sich sogar mehrfach vermehrt.
Hoffe auch nicht auf das Platzen der »KI-Blase«. Darüber wird seit Anfang 2023 spekuliert. Keiner weiß, ob sie kommt und wann. Auch wenn die irgendwann platzen sollte, wird die KI dennoch bleiben. Nach dem Platzen der Dotcom-Blase ist das WWW auch nicht verschwunden.
Mein Rat: Bilde dich zum Thema KI fort, so gut es geht. Dann weißt du, was damit machbar ist und wo die Schwächen liegen. Du kannst mit diesem Wissen in deinem Umfeld auf mögliche Probleme hinweisen, und falls man es trotz deiner Bedenken umsetzt, dann bist du dennoch vorbereitet und gerüstet.
Ich weiß, ich habe jetzt hier einige Selbstverständlichkeiten niedergeschrieben, die vielen von euch bereits bekannt sind. Aber dennoch übersehen wir häufig im Alltag das Naheliegende.
Wie seht ihr das? Ist der KI-Zug aus eurer Sicht wirklich schon abgefahren oder glaubt ihr noch an eine größere Gegenbewegung?
Seit ein paar Tagen macht der Artikel von Search Engine Journal die Runde: »WordPress Market Share Declines For Six Months In A Row«. Sechs Monate Rückgang am Stück und als Buhmann gleich der Streit zwischen Matt Mullenweg und WP Engine. Klingt nach Drama und Popcorn.
Ich beobachte diese Zahlen seit über zwölf Jahren und ich kann empfehlen, dass man sich die Zahlen in Ruhe anschaut, bevor man den Untergang von WordPress einläutet.
Verbreitung vs. Marktanteil
Bevor wir über Auf- oder Abstieg reden, müssen wir zwei Zahlen auseinanderhalten, die häufig vermischt werden. W3Techs weist beides getrennt aus:
Die Verbreitung (im Original »Usage«) sagt, welcher Anteil aller Websites WordPress einsetzt. Hier steht WordPress aktuell bei 41,9 % (Stand Juni 2026).
Der Marktanteil (»Market Share«) sagt, welchen Anteil WordPress unter den Websites mit erkennbarem CMS hält. Und das sind aktuell 59,4 %.
Der SEJ-Artikel spricht durchgehend von »market share«, nennt dann aber die 41- bis 43-%-Werte. Das ist die Verbreitung, nicht der Marktanteil. Ich möchte hier nicht kleinkariert klingen, aber die beiden Werte sollte man in diesem Fall schon auseinanderhalten.
Die 60-%-Marke ist gefallen
Und jetzt kommt der Punkt, der schon fast geschichtsträchtig ist. Vor über zwölf Jahren schrieb ich hier im Blog: »WordPress beherrscht 60 % des CMS-Marktes«. Das war im März 2014, auf dem Weg nach oben. Im März 2026 ist WP das erste Mal unter die Marke von 60 Prozent gesunken und befindet sich jetzt im Juni 2026 bei 59,4 % Marktanteil.
Der Marktanteil bröckelt allerdings nicht erst seit ein paar Wochen: Im April 2023 waren es noch 63,3 %, seitdem geht es Quartal für Quartal ein Stück bergab. Bei der Verbreitung lag der Höhepunkt im Januar 2025 bei 43,6 %, danach zeigt auch diese Kurve nach unten. So etwas kann man nicht kleinreden.
Sinkt WordPress jetzt in die Bedeutungslosigkeit?
Nein. Es empfiehlt sich, das Gesamtbild anzuschauen, bevor man den Niedergang ausruft. 59,4 % Marktanteil heißt, dass WordPress immer noch fast sechs von zehn CMS-Websites stellt. Der nächste Verfolger ist Shopify mit 7,4 %, dahinter Wix mit 6,1 %. Das ist kein Kopf-an-Kopf-Rennen.
Spannender als das nackte Minus ist die Frage, wohin die Anteile wandern. Die gehosteten Baukästen legen zu, allen voran Shopify (von 5,5 auf 7,4 %) und Wix (von 3,7 auf 6,1 %), etwas gemächlicher Squarespace.
Die alte Garde verliert dagegen mit. Joomla und Drupal sind beide weiter geschrumpft. WordPress steht also nicht allein unter Druck, ist aber der mit Abstand größte Brocken, an dem geknabbert wird.
Woran hat et jelegen?
Wie so häufig im Leben: an mehreren Dingen gleichzeitig. Und sauber gewichten und trennen kann die Gründe niemand.
Da ist zum einen die Konkurrenz, die einerseits besser als früher ist. Schon 2022 hat Joost de Valk darauf hingewiesen, dass Wix und Squarespace bei Performance und SEO aufgeholt haben. Ich hatte das Thema damals hier aufgegriffen. Für Einsteiger, die einfach nur eine schnelle, ordentliche Website wollen, ist der Baukasten oft der bequemere Weg. Zumal wir nicht vergessen dürfen, dass einige der Baukastensysteme in der Vergangenheit viele Werbekampagnen durchgeführt haben. Da können Open-Source-Systeme logischerweise nicht mithalten.
Dann der Dauerbrenner Gutenberg und Full Site Editing. Ein gutes Stück der alten WordPress-Einfachheit und Schlichtheit ist auf dieser Reise verloren gegangen, und das spüren vor allem die Leute, die früher mit ein paar Klicks schnell eine Website online hatten.
Und ja, da ist natürlich der Streit zwischen Mullenweg und WP Engine, den SEJ zur Hauptursache erklärt. Hier wäre ich sehr vorsichtig. Der Konflikt eskalierte im Herbst 2024, der Marktanteil sinkt aber schon seit 2023. Korrelation ≠ Kausalität.
Dass die Querelen der Sache nicht geholfen haben, das denke ich schon. Aber als alleiniger Auslöser taugt der Streit nicht. Ich selbst halte ihn für lediglich einen nachgeordneten Grund, da der Streit an vielen einfachen Nutzern vorbeigegangen ist oder bestenfalls als Randnotiz registriert wurde.
Abwarten & Tee trinken
Es bleibt die Frage, ob das so weitergeht. WordPress 7.0 hat gerade KI-Funktionen in den Core geholt und das Dashboard aufgefrischt. Vermeintlicher Wendepunkt, den am Ende der SEJ-Artikel nennt. Ob das reicht, um die Kurve zu drehen, ich denke eher nicht. Wäre die Echtzeit-Kollaboration noch dazugekommen, dann hätte ich diese Einschätzung vorsichtig bejaht.
Ich glaube nicht, dass WordPress in Zukunft die alten Zahlen und Höhenflüge übertreffen wird. Es wird eher die Frage sein, ob WordPress weiterhin, langfristig und stetig Marktanteile verlieren wird, oder ob es sich kurz- bis mittelfristig stabilisiert und in den hohen Fünfzigern (55-59 %) gemütlich einrichtet.
Wie seht ihr die Entwicklung?
Nachtrag, 9. Oktober 2026: Meine Einschätzung, dass es nicht reicht, um die Kurve zu drehen, hat sich bewahrheitet. Die Zahlen bezüglich der Verbreitung und des Marktanteils sinken weiter: WordPress und KI: Welche Zukunft »droht« dem CMS?
Heute Nacht wurde WordPress 7.0 »Armstrong« veröffentlicht, benannt nach dem legendären Jazz-Musiker Louis Armstrong. Das ist das erste Major-Release seit Langem, das nicht nur Detailverbesserungen bringt, sondern auch eine neue Richtung markiert: KI bzw. AI rückt noch mehr in den Fokus. Das Dashboard bekommt einen ordentlichen Schub und einiges mehr. Eine prominent angekündigte und lang erwartete Funktion fehlt allerdings.
KI-Integration: AI-Client, Abilities-API und ein Connector-Hub
Die größte Aufmerksamkeit im neuen Release bekommt die KI-Integration. WordPress 7.0 bringt einen sogenannten AI-Client direkt in den Core, der die Kommunikation mit generativen AI-Modellen übernimmt. Zusammen mit der neuen Abilities-API (und ihrem JavaScript-Pendant, dem Client-Side Abilities Package) soll das die Grundlage für neue Funktionen, Workflow-Automatisierungen und Erstellungs-Tools direkt in WordPress legen.
Über ein zusätzliches AI-Plugin lassen sich dann konkrete Funktionen aktivieren: Bilder generieren und bearbeiten, Titel oder Auszüge erstellen, Alt-Texte vorschlagen. Die Verbindungen zu externen AI-Diensten werden zentral auf dem neuen Connector’s Screen verwaltet, mit drei Voreinstellungen für den schnellen Einstieg. Der AI-Client allein erzeugt noch keine AI-Funktionen, er ist eher die »Verkabelung«, die das Plugin-Ökosystem nutzen kann.
Modernisiertes Dashboard
Das Backend wurde optisch überarbeitet. Neues Farbschema, weichere Übergänge, insgesamt eine ruhigere Anmutung. Auf den Screenshots wirkt das aufgeräumt, der echte Eindruck zeigt sich allerdings erst nach einer Weile im täglichen Arbeiten.
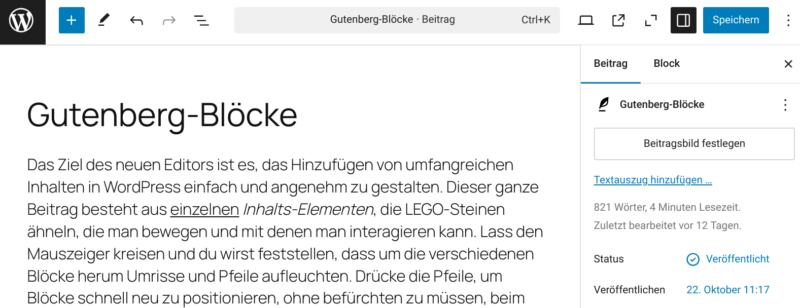
Die WordPress-Befehlspalette (Command-Palette), die du über ⌘K (Mac) oder Strg+K (Windows/Linux) öffnest, wurde erweitert und auch hier sind KI-Funktionen hinzugekommen.
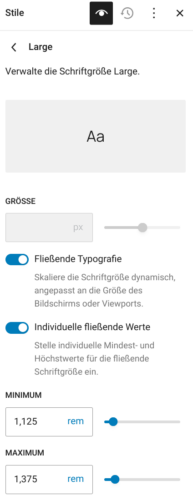
Daneben gibt es zwei nützliche Detailverbesserungen: eine zentrale Font-Verwaltungsseite, die Block-, Hybrid- und klassische Themes unterstützt, und einen visuell verbesserten Revisionen-Vergleich, mit dem du durch die Versionen scrollst und Änderungen auf einen Blick siehst.
Neue Blöcke und mehr Design-Kontrolle
Im Editor sind mehrere neue Blöcke dazugekommen: ein Gallery-Block mit Lightbox-Slideshow, ein Heading-Block für feineres HTML-Markup, ein Breadcrumbs-Block für eine klare Navigation ohne Plugin-Umweg und ein Icons-Block für kleine grafische Akzente.
Außerdem gibt es erweiterte Responsiveness-Controls. Du kannst einzelne Blöcke je nach Viewport ein- oder ausblenden und sogar die Breakpoints selbst anpassen. Das Menü-Overlay ist jetzt vollständig mit Blöcken und Patterns gestaltbar, inklusive eigener Schließen-Buttons und Spalten-Layouts. Patterns funktionieren ab 7.0 als eine Einheit, lassen sich aber bei Bedarf wieder voneinander lösen. Und für alle, die granular eingreifen möchten: Du kannst jetzt direkt im Block-Editor Custom-CSS auf Block-Ebene definieren.
Was fehlt: Echtzeit-Kollaboration verschoben
Eine Funktion, die ursprünglich für 7.0 vorgesehen war, hat es nicht ins finale Release geschafft: die Echtzeit-Kollaboration im Editor, also das gemeinsame Bearbeiten von Beiträgen und Seiten im Stil von Google Docs. Darüber habe ich schon gestern im aktuellen Newsletter berichtet.
Matt Mullenweg hat Anfang Mai entschieden, die Funktion aus 7.0 herauszunehmen. Begründet wurde das mit Bedenken zur Stabilität: zu große Angriffsfläche, Race Conditions, Probleme mit Serverlast und Speichereffizienz sowie wiederkehrende Bugs, die durch Fuzz-Testing aufgetaucht sind. Aus Sicht des Teams sei der aktuelle Stand noch nicht robust genug für den Core. Wer die Funktion ausprobieren möchte, kann das aktuell über das Gutenberg-Plugin tun. Ein vollwertiges Core-Feature soll daraus in einer späteren Version werden.
Für Entwickler: serverseitige Blöcke & ein erweiterbarer Site-Editor
Für Entwickler gibt es ein paar interessante Neuerungen. Blöcke und Patterns lassen sich jetzt serverseitig nur mit PHP erstellen und werden automatisch über die Block-API registriert. Das ist gerade für Projekte interessant, in denen man sich mit dem JavaScript-Block-Setup nicht aufhalten möchte.
Der Site-Editor selbst wurde erweiterbarer. Es gibt jetzt Routing, Route-Validierung und ein neues wordpress/boot-Package, mit dem Plugins eigene Site-Editor-Seiten bauen können. Damit wird der Site-Editor weniger ein geschlossenes Tool und mehr eine Plattform, auf der eigene UI-Bereiche möglich sind. Solche Erweiterungspunkte sind in der Ankündigung oft unscheinbar, haben aber langfristig Auswirkungen darauf, was im Plugin-Ökosystem überhaupt möglich ist.
Fazit und Hinweise zum Update
Klar, AI ist gerade das große Thema, und WordPress wollte hier verständlicherweise nicht außen vorbleiben. Statt einen großen, fest verdrahteten AI-Assistenten in den Core zu schrauben, gibt es eine API-Schicht plus optionales Plugin.
Aber bei diesem Thema ist Vorsicht angebracht. Wenn KI-Funktionen im Hintergrund auf deine Inhalte zugreifen, gehen Texte und gegebenenfalls Bilder an einen externen Anbieter. Vor dem produktiven Einsatz lohnt sich ein Blick in die jeweiligen Datenschutzbedingungen, vor allem im DSGVO-Kontext. Kostenpflichtige API-Aufrufe sind ein weiteres Thema, das du dann im Blick behalten solltest.
Keine Eile beim Update auf 7.0
Wie auch schon in der Vergangenheit: Du bist nicht gezwungen, sofort auf 7.0 zu aktualisieren. Bei den größeren Versionssprüngen ist sowieso immer etwas mehr Vorsicht angebracht. Wer eine kleinere Seite oder nur wenige Plugins im Einsatz hat, der kann auch jetzt schon aktualisieren, wenn er neugierig auf die Neuerungen ist.
Wer eine stark angepasste Website und/oder viele Plugins im Einsatz hat, der sollte entweder gut testen oder auf WordPress 7.0.1 oder noch besser auf 7.0.2 warten. Wer noch zusätzlich WooCommerce einsetzt, für den gilt die Vorsicht umso mehr.
Habt ihr schon auf 7.0 aktualisiert, oder wartet ihr lieber noch auf das erste oder sogar zweite Patch-Release?
Vor zwei oder drei Jahren war die robots.txt für die meisten Blogger eine Datei, die man einmal aufgesetzt und dann geflissentlich ignoriert hat. Ein paar Angaben für Googlebot, vielleicht ein Disallow auf den Login-Bereich, fertig. Heute steht in dieser unscheinbaren Textdatei plötzlich eine strategische Entscheidung: ob deine Inhalte in ChatGPT, Claude, Gemini oder Perplexity überhaupt noch auftauchen dürfen.
Das ist keine theoretische Frage. Inzwischen blockieren nach einer Auswertung von BuzzStream aus April 2026 rund 79 Prozent der großen Nachrichten-Websites die Trainings-Crawler der KI-Anbieter, und 71 Prozent blockieren sogar die Retrieval-Crawler, also die Bots, die für die Live-Antworten der KI-Chatbots zuständig sind. Was bei einem großen Verlag mit eigener Rechtsabteilung und Lizenzverhandlungen Sinn ergeben kann, ist für einen kleinen Blog meistens die falsche Strategie.
Bevor wir loslegen, eine kurze Abgrenzung, damit der Artikel nicht ausufert.
Es geht um die robots.txt als das klassische Steuerungsinstrument für Crawler. Nicht um serverseitige Blockaden via Cloudflare-WAF, .htaccess oder Nginx-Regeln. Das sind eigene Themen, die einen eigenen Artikel verdienen. Hier nur so viel: Wenn die robots.txt alleine nicht reicht, weil ein Crawler die Regeln schlicht ignoriert, kommen wir später noch darauf zu sprechen. Aber der Schwerpunkt liegt auf der Datei selbst.
Es geht um deutschsprachige Blogger, kleinere Unternehmen und WordPress-Betreiber, die ihre Seite selbst verwalten.
Es geht hier auch nicht um llms.txt. Das Thema habe ich im besagten Artikel schon eingeordnet, und meine Skepsis bleibt unverändert. 🤓
Bevor wir zur strategischen Frage kommen, lohnt sich ein kurzer Blick darauf, wer da so alles an deine Tür klopft. Ich gehe das nach Anbieter durch, weil du am Ende deine robots.txt auch in solchen Blöcken aufbaust: erst alle OpenAI-Bots, dann alle Anthropic-Bots, dann alle Google-Bots.
Eine Vollständigkeitsgarantie gibt es nicht. Die Landschaft ändert sich schnell, neue Anbieter kommen dazu, alte werden umbenannt. Ich konzentriere mich auf die fünf Anbieter, die für deutschsprachige Blogger 2026 praktisch relevant sind.
GPTBot ist der Trainings-Crawler. Wer ihn blockiert, sorgt dafür, dass künftige Modellversionen die eigenen Inhalte nicht mehr lernen.
OAI-SearchBot ist der Such-Crawler, der Inhalte für die Suchfunktion in ChatGPT indexiert. Wer hier blockiert, fällt aus den Suchantworten in ChatGPT heraus.
ChatGPT-User wird ausgelöst, wenn ein ChatGPT-Nutzer aktiv eine URL anklickt oder einen Link in den Chat einwirft. OpenAI weist explizit darauf hin, dass die robots.txt hier nicht zwingend greift, weil es als User-Aktion gilt und nicht als automatisches Crawling.
Anthropic
Anthropic war lange Zeit etwas unübersichtlich mit den User-Agents anthropic-ai und claude-web. Diese alten Namen sind mittlerweile durch eine klar dokumentierte Dreiteilung ersetzt:
ClaudeBot ist der Trainings-Crawler.
Claude-SearchBot indexiert für die Such- und Antwortfunktionen.
Claude-User wird durch eine konkrete Nutzeranfrage ausgelöst.
Anthropic gibt explizit an, dass alle drei Bots die robots.txt respektieren, auch der user-initiierte Claude-User. Das ist eine bewusste Differenzierung gegenüber den Mitbewerbern.
Google
Bei Google wird es interessant, weil die meiste Verwirrung hier entsteht.
Googlebot ist der klassische Crawler für die Web-Suche. Er ist auch der Crawler hinter den AI‑Overviews, also den KI-Zusammenfassungen, die Google seit 2024 oberhalb der klassischen Treffer einblendet. Wer aus AI‑Overviews verschwinden will, kann das nicht über die robots.txt steuern, ohne sich gleichzeitig aus der gesamten Google-Suche zu schießen.
Google-Extended ist hingegen kein eigener Crawler, sondern nur ein Steuer-Token. Google sagt das selbst klipp und klar: Es gibt keinen eigenen User-Agent-String, keinen eigenen Crawl-Vorgang. Du kannst per Disallow: / für Google-Extended steuern, ob die bereits durch Googlebot gecrawlten Inhalte für das Training von Gemini und für Vertex AI verwendet werden dürfen. Auf das Ranking in der Google-Suche und auf das Erscheinen in den AI‑Overviews hat das keinen Einfluss.
Diese Unterscheidung ist wichtiger, als sie auf den ersten Blick aussieht. Wir kommen weiter unten noch darauf zurück.
PerplexityBot baut den Index auf, aus dem Perplexity seine zitierten Antworten zusammensetzt. Befolgt die robots.txt.
Perplexity-User wird durch eine konkrete Nutzeranfrage ausgelöst und ignoriert die robots.txt nach eigener Aussage – ähnlich der OpenAI-Logik.
Common Crawl
Etwas im Hintergrund, aber relevant: Die Non-Profit-Organisation Common Crawl betreibt den CCBot und stellt ihre monatlich aktualisierten Datensätze frei zur Verfügung. Viele kleinere AI-Anbieter und Forschungsprojekte trainieren ihre Modelle auf diesen Daten, anstatt selbst zu crawlen. Wer CCBot blockiert, schneidet damit eine ganze Reihe von Modellen mit ab, ohne dass deren Anbieter selbst auf der Liste stehen müssen.
Andere Anbieter wie Bytespider von ByteDance, Meta-ExternalAgent oder Amazonbot existieren ebenfalls, sind aber für die deutschsprachige Blogosphäre weniger zentral. Wer sie blockieren möchte, ergänzt seine robots.txt sinngemäß.
Training vs. Retrieval: die eigentliche Trennlinie
Die meisten Anleitungen, die du im Web findest, listen die Bots auf und gehen weiter. Aber genau hier liegt der Knackpunkt, an dem viele Betreiber ihre robots.txt falsch konfigurieren. Die wichtige Frage ist nämlich nicht, welche Bots du blockierst, sondern zu welchem Zweck sie unterwegs sind.
Grob lassen sich drei Kategorien unterscheiden:
Trainings-Crawler sammeln Inhalte, die später in das Training neuer Modellversionen einfließen. Wer hier blockiert, verhindert, dass die eigenen Texte in künftigen GPT-, Claude- oder Gemini-Versionen verarbeitet werden. Auf die aktuellen KI-Antworten hat das keinen direkten Effekt. Die Modelle sind ja schon fertig trainiert.
Retrieval- oder Search-Crawler holen Inhalte für die Live-Antworten der KI‑Suche. Sie sind der Grund, warum ChatGPT oder Perplexity dich überhaupt in einer Antwort zitieren können. Wer hier blockiert, fällt sofort und sichtbar aus den KI-Antworten heraus.
User-initiierte Fetcher werden ausgelöst, wenn ein Mensch aktiv eine URL in die KI-Oberfläche packt oder einen Link anklickt. Hier wird es interessant: Ob die robots.txt überhaupt greift, hängt vom Anbieter ab.
Diese letzte Kategorie ist der Punkt, den viele Artikel unter den Tisch fallen lassen. Anthropic sagt klar, dass auch der user-initiierte Claude-User die robots.txt respektiert. OpenAI und Perplexity sagen ebenso klar, dass ihre user-initiierten Bots (ChatGPT-User, Perplexity-User) die robots.txt unter Umständen ignorieren.
Die Begründung ist nachvollziehbar: Wenn ein Mensch aktiv eine URL eintippt, gilt das als Nutzerhandlung, nicht als automatisches Crawling. Aber die praktische Konsequenz ist eine andere als bei den Trainings-Bots: Auch ein vermeintlich vollständiger Block hat hier seine Lücken.
Wer also pauschal sagt »Ich blockiere alle KI-Bots« und einfach GPTBot, ClaudeBot und PerplexityBot auf Disallow: / setzt, hat in Wirklichkeit nur die Trainings-Crawler ausgesperrt. Die Such-Crawler (OAI-SearchBot, Claude-SearchBot) laufen weiter, und die user-initiierten Bots tun, was sie tun. Umgekehrt: Wer alle drei Kategorien blockiert, ist in den KI-Antworten praktisch unsichtbar – und das ist 2026 eine teurere Entscheidung als noch vor zwei Jahren.
Klingt erst einmal nach Detailfrage, ist aber in der Praxis der Grund, warum so viele Site-Betreiber ihre robots.txt mit dem Gefühl »Ich habe alles richtig gemacht« geschlossen haben und sich anschließend wundern, dass sie trotzdem (oder gerade deshalb) nicht mehr in ChatGPT auftauchen.
Drei strategische Optionen
Mit der Unterscheidung zwischen Training und Retrieval im Hinterkopf lassen sich drei realistische Strategien formulieren. Keine davon ist universell richtig. Welche zu dir passt, hängt davon ab, was du erreichen willst und welche Rolle KI-Sichtbarkeit für dein Projekt spielt.
Standard: zulassen
Für die meisten Blogger und kleineren Unternehmen ist die einfachste und in meinen Augen auch sinnvollste Option, alle relevanten Crawler grundsätzlich zuzulassen. Der Hintergrund: Wer ohnehin schon mit dem Rückgang organischer Klicks durch AI Overviews und Zero-Click-Searches zu kämpfen hat (und das ist 2026 so ziemlich jeder), sollte sich nicht zusätzlich auch noch die Sichtbarkeit in den KI-Antworten verbauen. Zu diesem Thema habe ich im Artikel zu den Zero-Click-Searches und in ChatGPT SEO: Die Evolution des Suchbegriffs schon einiges geschrieben.
Klar, das bedeutet auch, dass die eigenen Inhalte in künftige Trainingsdurchläufe einfließen. Wer das aus prinzipiellen Gründen ablehnt, hat ein starkes Argument. Aber für die meisten Blogprojekte überwiegt der Sichtbarkeitsvorteil. Die großen Verlage, die aktuell pauschal blockieren, haben eine andere Ausgangslage: eigene Lizenzverhandlungen mit AI-Anbietern, eigene Rechtsabteilungen, eigene Reichweite. Das ist für einen Ein-Personen-Blog kaum der passende Maßstab.
Ausnahme 1: technische Notwehr
Es gibt einen Fall, in dem auch ich blockieren würde: Wenn ein Crawler den Server hämmert. ClaudeBot hatte 2024 mehrere Wochen lang einen unrühmlichen Ruf, weil er auf einigen Seiten dermaßen aggressiv zugegriffen hat, dass die Betreiber Performance-Probleme bekamen. Auch andere Bots können das gelegentlich tun, vor allem wenn sie auf eine frisch aktualisierte Sitemap stoßen.
Aber das ist keine prinzipielle Entscheidung gegen KI, sondern Ressourcenschutz. Bevor man hier mit einem harten Disallow: / antwortet, lohnt sich der Blick auf die Crawl-delay-Direktive. Anthropic unterstützt sie explizit, Google ignoriert sie zwar, aber bei den meisten anderen Anbietern ist sie ein guter Mittelweg.
Ein einfaches Beispiel:
User-agent: ClaudeBot
Crawl-delay: 10
Damit sagst du dem Bot: »Lass bitte zehn Sekunden zwischen den Anfragen verstreichen.« In den meisten Fällen reicht das aus.
Ausnahme 2: bewusste Trennung
Die dritte Option ist die interessanteste und in meinen Augen die unterschätzteste: Du blockierst gezielt das Training, lässt aber die Retrieval-Crawler durch. Damit verhinderst du, dass deine Inhalte in künftige Modelle einfließen, bleibst aber in den aktuellen KI-Antworten sichtbar.
Genau hier kommt die Google-Sache ins Spiel, die ich oben angedeutet habe. Wer Google-Extended auf Disallow: / setzt, blockiert das Training von Gemini. Die Google-Suche bleibt davon unberührt, und auch die AI Overviews funktionieren weiter, weil sie über Googlebot laufen. Wer also einerseits in der Google-Suche und in den AI‑Overviews sichtbar bleiben, andererseits aber nicht ungefragt in Gemini-Modelle einfließen will, hat hier eine saubere Trennlinie.
Bei OpenAI funktioniert das ähnlich: GPTBot blockieren stoppt das Training, OAI-SearchBot zulassen erhält die Sichtbarkeit in der ChatGPT‑Suche. Bei Anthropic kannst du ClaudeBot blockieren und Claude-SearchBot zulassen. Ein praktikabler Ansatz, der allerdings etwas mehr Pflege verlangt, weil du wissen musst, welcher Bot zu welchem Zweck unterwegs ist.
Praxisteil: drei robots.txt-Beispiele
Wir haben jetzt die Theorie und die strategische Einordnung. Schauen wir uns an, wie das konkret in der robots.txt aussieht.
Ein kurzer technischer Hinweis vorab: WordPress liefert seit einigen Versionen eine dynamisch generierte robots.txt aus dem Core. Wer eigene Regeln einbauen will, hat zwei Optionen. Entweder legt man eine physische robots.txt ins Hauptverzeichnis der Domain (die hat dann Vorrang), oder man nutzt die entsprechende Funktion des SEO‑Plugins. The SEO Framework hat dafür einen eigenen Bereich in den Einstellungen, Yoast und Rank Math ebenfalls. Im Zweifel bitte selbst nachschauen, weil sich die Plugin-Oberflächen schnell ändern können.
Option 1: alle zulassen
Das ist die Standard-Empfehlung für einen Großteil der Blogger. Im Kern reicht es, die wichtigsten Bots explizit zu erwähnen und ihnen den vollen Zugriff zu geben:
Streng genommen müsstest du die Bots nicht einmal namentlich aufführen, weil ohne explizite Disallow-Regel sowieso alles erlaubt ist. Rein theoretisch würde also auch das hier ausreichen:
User-agent: *
Allow: /
Aber die explizite Nennung hat zwei Vorteile: Erstens dokumentiert sie deine Entscheidung, falls du sie später revidieren willst. Zweitens schützt sie davor, dass eine spätere User-agent: *-Regel mit einem versehentlichen Disallow alles mit ausschließt.
Option 2: Training blockieren, Retrieval zulassen
Das ist die differenzierte Variante für alle, die in den KI-Antworten sichtbar bleiben wollen, aber nicht ungefragt in Trainingsdaten einfließen möchten:
Was diese Konfiguration bewirkt: Deine Inhalte fließen nicht mehr in das Training künftiger Modelle ein. Zumindest nicht über die offiziellen Crawler der genannten Anbieter. Aber wenn jemand ChatGPT, Claude oder Perplexity nach einem Thema fragt, das du behandelt hast, kann dein Beitrag weiterhin zitiert werden.
Wichtig: Die user-initiierten Bots (ChatGPT-User, Perplexity-User) habe ich hier bewusst weggelassen, weil sie die robots.txt sowieso nicht zuverlässig respektieren. Wer sie aufnehmen will, kann das tun, sollte sich aber nicht zu viel davon versprechen.
Option 3: alle blockieren
Die kompromisslose Variante. Sie ist technisch die einfachste, aber praktisch die teuerste, weil sie die KI-Sichtbarkeit komplett kappt:
Wer das einsetzt, sollte sich darüber im Klaren sein, dass die Sichtbarkeit in ChatGPT, Claude, Gemini und Perplexity damit weitgehend auf Null geht. Für Verlage mit eigener Verhandlungsposition gegenüber AI-Anbietern kann das eine Strategie sein. Für die meisten Blogger ist es meiner Meinung nach keine gute Strategie.
Übrigens: Googlebot taucht in keinem der drei Beispiele auf. Das ist Absicht. Googlebot steuert die klassische Web-Suche und die AI‑Overviews. Wer den blockiert, fliegt aus der Google-Suche raus, und das will hier vermutlich niemand.
Wann die robots.txt nicht reicht
Bei aller Detailliebe sollte man eines nie aus dem Auge verlieren: Die robots.txt ist ein Hinweisschild, kein Schloss. Sie funktioniert nur, weil die meisten Anbieter sich daran halten. Wer das nicht tut, dem ist mit einer Textdatei nicht beizukommen.
Drei Punkte, die man bedenken sollte:
Aggressive Scraper ignorieren die Regeln. Bytespider von ByteDance ist hier das Standardbeispiel, aber es gibt eine ganze Reihe weniger bekannter Crawler, die ihre eigenen Regeln machen. Wer wirklich Daten will, dem ist die robots.txt egal.
Spoofing ist trivial. Ein gefälschter User-Agent ist mit einer Zeile Code geschrieben. Anbieter wie OpenAI, Anthropic und Perplexity veröffentlichen deshalb IP-Bereiche, über die sich ihre Bots verifizieren lassen. Wer ganz sicher gehen will, prüft die IP und nicht den User-Agent.
Für harten Schutz braucht es Serverebene. Wer einen Crawler wirklich aussperren will, etwa weil er den Server überlastet oder weil man rechtliche Gründe hat, kommt um serverseitige Lösungen nicht herum. Cloudflare-WAF, Nginx-Regeln, gezielte IP‑Sperrungen. Das ist ein eigenes Thema.
Kurz gesagt: Die robots.txt ist der Höflichkeitsmodus des Webs. Sie funktioniert für die freundlichen Bots, und das sind erfreulicherweise die meisten der großen Namen. Aber sie ist kein Garant.
Ein kurzer Blick auf die rechtliche Seite
Ich bin kein Anwalt und das hier ist keine Rechtsberatung, sondern eine Einordnung aus Praktikersicht. Wer es genauer wissen will, findet bei seriösen Fachquellen wie der IAPP oder bei den großen Anwaltskanzleien detaillierte Analysen.
Die Lage in der EU lässt sich grob so zusammenfassen: Die DSM-Richtlinie von 2019 erlaubt Text- and Data-Mining (TDM), wenn der Rechteinhaber nicht widerspricht. Dieser Widerspruch muss »in maschinenlesbarer Form« erfolgen, und die robots.txt gilt als einer der akzeptierten Wege. Der EU‑AI-Act verpflichtet Anbieter von General-Purpose-AI-Modellen, dieses Opt-out zu respektieren, und der dazugehörige GPAI Code of Practice nennt robots.txt explizit als anerkannten Mechanismus.
Soweit die Theorie. In der Praxis ist gerade einiges in Bewegung: Das OLG Hamburg hat im Dezember 2025 im Fall Kneschke gegen LAION zwar Stellung zu maschinenlesbaren Opt-outs bezogen, die Revision zum BGH ist aber zugelassen. Und der CJEU hat im März 2026 die erste mündliche Verhandlung im Fall »Like Company gegen Google« geführt, in dem es um die Frage geht, ob KI-Training überhaupt unter die TDM-Ausnahme fällt. Mit einer endgültigen Klärung würde ich in den nächsten Monaten nicht rechnen.
Für die Praxis heißt das: Eine Disallow: / für einen Trainings-Crawler in der robots.txt ist ein etablierter Weg, das Opt-out auszudrücken. Sie schützt aber nur vor Anbietern, die sich daran halten, und nur für künftige Crawls. Was bereits in einem Modell verarbeitet wurde, lässt sich nachträglich nicht herauslösen. Mal schauen, was die nächsten Gerichtsentscheidungen daraus machen.
Meine Empfehlung
Wenn ich das Ganze auf einen praktischen Nenner bringen soll, dann sieht meine Linie so aus:
Im Standardfall lasse ich die KI-Crawler zu. Die Sichtbarkeit in ChatGPT, Claude, Gemini und Perplexity ist 2026 ein realer Faktor, und wer sich aus prinzipiellen Gründen aussperrt, verliert mehr, als er gewinnt. Das gilt vor allem für kleinere Blogs und Unternehmen, die ohnehin schon mit dem Rückgang organischer Klicks zu kämpfen haben.
Wenn ein Bot wirklich Stress macht, also den Server überlastet oder unverhältnismäßig oft zugreift, dann solltest du ihn blockieren. Aber das ist eine Ressourcen-Entscheidung, keine prinzipielle. Vor dem harten Disallow: / lohnt sich der Blick auf Crawl-delay, sofern der Anbieter das unterstützt.
Wer das Training stören, aber in den KI-Antworten sichtbar bleiben will, kann die differenzierte Trennung wählen: Trainings-Crawler raus, Retrieval- und Search-Crawler rein. Das ist mehr Pflegeaufwand, aber eine valide Position für alle, die sich grundsätzlich nicht mit ihren Inhalten an Modellen beteiligen wollen, ohne sich gleich aus der Sichtbarkeit zu schießen.
Und ein letzter Punkt, der mir wichtig ist: Bevor du irgendwas in deine robots.txt schreibst, sei dir bewusst, was du damit konkret abschaltest. Wer GPTBot blockiert, blockiert nicht ChatGPT als Ganzes, sondern nur das Training. Wer Google-Extended blockiert, blockiert weder die Google-Suche noch die AI-Overviews, sondern nur das Gemini-Training. Wer alle drei OpenAI-Bots blockiert, fliegt aus der ChatGPT-Suche komplett raus.
Wie schaut es bei euch aus? Habt ihr eure robots.txt schon auf die neue KI-Welt angepasst, lasst ihr noch alles offen, oder seid ihr beim differenzierten Modell gelandet? Habt ihr Bots beobachtet, die sich nicht an die Regeln halten? Ich freue mich über eure Erfahrungen in den Kommentaren.
Häufige Fragen
Muss ich die robots.txt auch für meine Subdomains separat anlegen?
Ja. Die robots.txt gilt immer nur für genau den Host, auf dem sie liegt. Wenn du also example.com und blog.example.com betreibst, brauchst du zwei getrennte Dateien. Anthropic weist in seiner Doku ausdrücklich darauf hin, dass das Opt-out für jede Subdomain einzeln eingerichtet werden muss. Wer einen WordPress-Multisite-Aufbau mit Subdomains betreibt, sollte das auf dem Schirm haben.
Was passiert mit Inhalten, die bereits in einem Modell verarbeitet wurden, wenn ich jetzt blockiere?
Nichts. Eine nachträgliche Sperrung in der robots.txt wirkt nur in die Zukunft. Was bereits in die Gewichte eines neuronalen Netzes eingeflossen ist, lässt sich technisch nicht herauslösen – dafür müsste das Modell von Grund auf neu trainiert werden. Wer also seit Jahren bloggt und jetzt erst auf Disallow: / umstellt, sperrt damit künftige Trainingsdurchläufe aus, nicht aber die bestehenden Modelle. Common Crawl ist hier besonders unangenehm: Was einmal im Archiv ist, bleibt dort, und dieses Archiv reicht zurück bis 2008.
Reicht es, die KI-Crawler im SEO-Plugin zu konfigurieren, oder muss ich an die robots.txt direkt ran?
Beides funktioniert. Yoast, Rank Math und The SEO Framework können die robots.txt ausgeben und um eigene Regeln ergänzen. Solange du keine physische robots.txt im Hauptverzeichnis liegen hast, bedient sich WordPress des dynamisch generierten Inhalts der Plugins. Sobald aber eine echte Datei im Root liegt, hat die Vorrang und überschreibt alles, was die Plugins ausspucken. Bei größeren Setups mit mehreren Plugins, die alle gleichzeitig an der robots.txt mitschreiben wollen, ist die physische Datei oft die klarere Lösung.
Habe ich einen SEO-Nachteil bei Google, wenn ich Google-Extended blockiere?
Nein. Google sagt das in der eigenen Doku ziemlich deutlich: Google-Extended hat keinen Einfluss auf das Ranking in der Web-Suche. Es steuert ausschließlich, ob deine Inhalte für das Training von Gemini und für Grounding-Funktionen in Vertex AI verwendet werden dürfen. Auch die AI‑Overviews bleiben unberührt, weil die über Googlebot laufen. Wer also auf der einen Seite in der Google-Suche und in den AI‑Overviews präsent bleiben, sich aber gegen Gemini-Training entscheiden will, hat mit Disallow: / für Google-Extended eine saubere Lösung.
Wer länger als ein paar Jahre in der WordPress-Welt unterwegs ist, kennt das Spiel: Alle paar Monate dreht sich das SEO-Karussell ein bisschen weiter, und plötzlich soll alles, was bis gestern noch galt, nicht mehr funktionieren. Mal sind es die Core-Updates, mal ein neues Ranking-Signal. Und seit etwa zwei Jahren stehen die generativen Antwortmaschinen wie Google AI Overviews oder ChatGPT mit im Raum und sortieren das Spielfeld neu.
Daher dachte ich mir, es ist Zeit für einen umfangreichen Rundumschlag. Kein Heilsbringer-Listicle, sondern ein nüchterner Blick auf das, was 2026 wirklich zählt, und auf das, was schon immer galt.
Worum es hier geht und worum nicht
Dieser Artikel richtet sich an Blogger, kleinere Unternehmen und WordPress-Praktiker, die ihre Seite selbst betreuen. Wer ein Inhouse-SEO-Team mit drei Spezialisten hat, der braucht meine Einschätzung vermutlich nicht … kann sie aber gerne lesen. 🤓
Ich werde meine Meinungen klar als solche kennzeichnen. SEO ist ein Feld, in dem viele Leute viel mit großer Überzeugung behaupten, ohne dass am Ende jemand wirklich nachweisen kann, was den Ausschlag gegeben hat.
Bevor wir auf die ganzen neuen Themen kommen, AI Overviews, Core Web Vitals, llms.txt und so weiter, ein kurzer Realitätscheck: Die wirklich wichtigen Dinge in der Suchmaschinenoptimierung haben sich in den vergangenen Jahren erstaunlich wenig verändert.
Gute Inhalte. Saubere Technik. Geduld. Klingt langweilig, ist aber die Wahrheit.
Wenn ich mir meine eigenen erfolgreichen Artikel hier auf perun.net anschaue, dann lösen die fast immer ein konkretes Problem, ordnen ein Thema ein, zu dem es viele halbgare Erklärungen gibt, oder teilen eine eigene Erfahrung. Das Spannende: Diese drei Punkte sind unabhängig davon, wer den Artikel später liest: ein Mensch über die Google-Suche, eine KI, die ihn in einer Antwort zitiert, oder jemand aus einem Newsletter.
Was sich also wirklich nicht geändert hat: Inhalte, die einen echten Mehrwert liefern. Eine technisch saubere Website: crawlbar, schnell, mobil nutzbar. Ein Mindestmaß an Geduld, denn SEO war nie ein Sprint. Und Authentizität: Wer regelmäßig zu einem Thema schreibt und das über Jahre durchzieht, baut sich eine Position auf, die durch keinen Algorithmus-Trick zu ersetzen ist.
Ich kann das auch positiv lesen: Wenn die Grundlagen seit vielen Jahren halten, dann werden sie wahrscheinlich auch die nächsten zwei, drei Jahre überstehen, egal, was als Nächstes auf den Markt kommt. Klar, an den Rändern verändert sich einiges. Aber so heiß wird auch hier nicht gegessen, wie es gekocht wird. 🤓
Die Basis: Domain, Hosting und ein gepflegtes WordPress
Bevor wir uns über Schema-Markup, AI-Crawler und INP-Werte unterhalten, lohnt sich der Blick aufs Fundament. Die schönste SEO-Strategie nützt dir wenig, wenn dein Hoster im Schneckentempo ausliefert oder dein WordPress auf PHP 7.4 vor sich hin staubt.
Domain und HTTPS
HTTPS ist seit Jahren Standard, aber bei älteren Projekten findet man sporadisch noch Mixed-Content-Probleme oder abgelaufene Zertifikate. Bei den meisten Hostern ist Let’s Encrypt so gut integriert, dass HTTPS nur noch eine Frage von wenigen Klicks ist.
Bei der Domain selbst gibt es wenig Neues. Eine sprechende Domain ist besser als kryptischer Bindestrich-Salat, aber ein wirklicher Rankingfaktor von Bedeutung war das nie.
Hosting: lieber durchdacht als teuer
Hosting ist ein Bereich, in dem viele Leute viel ausgeben, ohne dass sich am Ergebnis etwas ändert. Klar, wenn du einen 2-Euro-Tarif bei einem zweifelhaften Anbieter hast, ist das Optimierungspotenzial groß. Aber sobald du bei einem soliden Anbieter gelandet bist, bringt dir der nächstteurere Tarif selten den großen Schub.
Wichtig sind Server-Standort in der Nähe der Zielgruppe, eine aktuelle PHP-Version, vernünftige Antwortzeiten und idealerweise Caching auf Server-Ebene. Den Rest erledigen ein gutes Theme und ein, zwei Plugins.
PHP, WordPress und das Theme
Das Thema PHP-Update habe ich vor einigen Jahren ausführlich behandelt. Das Grundprinzip gilt nach wie vor: Eine aktuelle PHP-Version ist deutlich performanter und sicherer. WordPress-Updates einspielen, ungenutzte Plugins entfernen, alte Datenleichen rauswerfen. Klingt banal, wird aber gerne aufgeschoben.
Beim WordPress-Theme sehe ich in der Praxis die meisten unnötigen Bremsklötze. Featurelastige Pakete mit Pagebuilder, dreißig Slider-Optionen und Animationen für jeden Anlass sind selten ein Performance-Gewinn. Wenn dein Theme beim Laden 80 CSS- und JavaScript-Dateien nachschiebt, wird es schwer, gute Core-Web-Vitals zu erreichen – egal, wie viele Cache-Plugins du draufpackst.
Technisches SEO 2026 und die Pflicht-Themen
Beim technischen SEO gibt es 2026 wenige echte Neuerungen. Das meiste war auch 2020 schon Thema, nur dass die Schraube an der einen oder anderen Stelle angezogen wurde.
Core Web Vitals
Die Core Web Vitals sind seit 2021 ein bestätigter Rankingfaktor. Aktuell besteht das Trio aus drei Werten. Wichtig: Google misst dabei nicht den Durchschnitt, sondern fordert, dass die Werte bei mindestens 75 Prozent aller Seitenaufrufe im grünen Bereich liegen.
LCP (Largest Contentful Paint): Wie schnell wird das größte sichtbare Element geladen? Gut: unter 2,5 Sekunden.
INP (Interaction to Next Paint): Wie schnell reagiert die Seite auf Klicks und Interaktionen? Gut: unter 200 Millisekunden. INP hat im März 2024 die alte FID-Metrik abgelöst.
CLS (Cumulative Layout Shift): Wie stabil bleibt das Layout während des Ladens? Gut: unter 0,1.
Klar, nicht jede Seite muss perfekte Werte haben. Aber wenn alle drei Werte rot leuchten, hast du ein Problem und nicht nur SEO‑mäßig. Niemand wartet gerne.
Mobile First, Crawlability und Co.
Mobile First ist seit Jahren keine Empfehlung, sondern Standard. Google bewertet primär die mobile Version. Wer noch eine separate mobile Variante oder ein nicht-responsives Theme hat, sollte dringend ran.
Damit Google deine Inhalte findet, muss die Seite crawlbar sein. Die Klassiker: eine sinnvolle robots.txt, eine aktuelle XML-Sitemap (bei WordPress liefert das mittlerweile der Core, ein SEO-Plugin verfeinert das) und eine vernünftige interne Verlinkung. Gerade letztere wird oft stiefmütterlich behandelt – dabei ist sie einer der wenigen SEO-Hebel, die du komplett selbst in der Hand hast.
Bei Schema.org rate ich zur Mäßigung. Für bestimmte Inhaltstypen wie Rezepte, Veranstaltungen und FAQs bringt das sichtbare Vorteile. Aber jede Seite mit allen erdenklichen Schema-Typen zuzupflastern, ist meiner Erfahrung nach mehr Aufwand als Ertrag. Ich konzentriere mich auf das Wesentliche: Article für Blogartikel, BreadcrumbList für die Navigation, manchmal FAQ.
Bei Bildern ist WebP heute breit unterstützt, AVIF liefert oft noch bessere Kompression. Für die meisten Blogprojekte reichen WebP und ein Image-Optimization-Plugin völlig aus. Wer tiefer in das Thema einsteigen möchte, dem empfehle ich meinen Leitfaden zur Bildoptimierung in WordPress. Was bei mir trotz aller Automatisierung manuell bleibt: die Alt-Texte. Eine echte Bildbeschreibung ist eine andere Qualität als eine generierte Phrase – und für die wichtigen Bilder lohnt sich die Mühe.
Inhalte und On-Page-SEO
Bei aller technischen Optimierung: Wenn deine Inhalte nichts taugen, helfen dir die schönsten Core-Web-Vitals nichts. Und genau hier liegt ein Punkt, den ich für unterschätzt halte – nämlich dass guter Inhalt im Zeitalter der KI-Assistenten eher wichtiger geworden ist, nicht weniger.
Klar, KI-Tools wie ChatGPT, Claude, Grok oder Gemini können dir bei vielen Schritten helfen: Ideen sammeln, Gliederungen entwerfen, Überschriften vorschlagen, Texte umformulieren. Das ist kein Tabu, und ich nutze diese Werkzeuge auch selbst. Aber die eigentliche Substanz, deine Erfahrung, deine Sicht, deine konkreten Beispiele, die kann dir keiner abnehmen.
Keyword-Recherche noch sinnvoll?
Klassische Tools wie der Google-Keyword-Planner oder Ahrefs sind nach wie vor nützlich, wenn du wissen willst, was Menschen tatsächlich suchen. Aber der Fokus hat sich verschoben. Statt dich auf einzelne Keywords zu fixieren, denke heute eher in Themenfeldern und konkreten Fragen, die deine Leser haben könnten.
Wer das umgekehrt macht – also zuerst das Keyword sucht und dann den Inhalt drumherum baut – produziert oft seelenlose und nicht wirklich hilfreiche Texte, die weder Google noch Menschen wirklich überzeugen.
Titel, Meta-Descriptions und Überschriften
Diese drei Elemente sind kleine Hebel mit großer Wirkung. Ein guter Seitentitel weckt Klickinteresse, eine vernünftige Meta-Beschreibung gibt einen ehrlichen Vorgeschmack, und eine saubere Überschriftenstruktur (h1, h2, h3) hilft sowohl Lesern als auch Suchmaschinen, den Aufbau zu verstehen.
Mein Pragmatismus dabei: eine H1 pro Seite, dann logisch verschachtelte H2 und H3. Fast nie h4 und h5 und h6 am besten gar nicht. Meiner Meinung nach reichen h1-h3 in den allermeisten Fällen.
Interne Verlinkung: der unterschätzte Hebel
Ein Aspekt, den ich für wichtiger halte als die meisten anderen On-Page-Themen: die interne Verlinkung. Wer von einem Artikel auf einen verwandten älteren Beitrag verlinkt, schafft drei Dinge gleichzeitig: mehr Kontext für den Leser, ein klareres Themenbild für Suchmaschinen und längere Verweildauer auf der Seite.
Eine Kleinigkeit am Rande, die oft vergessen wird: Linktexte sollten beschreiben, wohin sie führen. »Hier klicken« sagt weder dem Leser noch der Suchmaschine etwas. Besser ist eine kurze Beschreibung des Ziels. Das hilft beim Scannen des Textes und gibt Google einen zusätzlichen Hinweis darauf, worum es im verlinkten Artikel geht.
Das Schöne daran: Du brauchst kein Tool und kein Plugin. Du brauchst nur die Disziplin, beim Schreiben kurz zu überlegen, welche älteren Artikel zum aktuellen Thema passen. Und offen gesagt: Genau dort lasse ich mir mittlerweile auch von KI-Tools helfen, weil bei mehreren Tausend Artikeln im Archiv eine zweite Meinung nicht schaden kann.
E-E-A-T: schwer fassbar, nicht ignorierbar
E-E-A-T steht für Experience, Expertise, Authoritativeness und Trustworthiness und ist ein Konzept aus Googles Quality-Rater-Guidelines. In der Praxis ist das schwer greifbar. Du kannst E-E-A-T nicht einfach »anschalten«. Aber du kannst dafür sorgen, dass dein Profil als Autor sichtbar ist, dass du zu deinen Themen tatsächlich etwas zu sagen hast und deine Inhalte nicht beliebig wirken.
Wer seit Jahren zu einem Themenfeld schreibt, dort nachweislich Erfahrung hat und das auch zeigt, durch Autorenseiten, persönliche Erfahrungsberichte, eigene Beispiele, der steht hier deutlich besser da als jemand, der erst gestern mit dem Thema angefangen hat.
Brauchst du überhaupt ein SEO-Plugin?
Kurze Antwort wäre: Ja, eines macht das Leben einfacher. Aber bei der Auswahl ist weniger oft mehr.
Was WordPress von Haus aus mitbringt
Wer denkt, ohne SEO-Plugin sei sein WordPress hilflos, der irrt. Der Core liefert mittlerweile eine ordentliche XML-Sitemap, vernünftige Title-Tags und eine ganze Reihe sinnvoller Defaults. Für eine kleine Website mit überschaubarem Anspruch reicht das oft schon.
Ein SEO-Plugin lohnt sich aber, sobald du gezielt an Titeln und Meta-Beschreibungen schrauben, Schema-Markup einsetzen oder bestimmte Bereiche deiner Seite gezielt aus der Indexierung herausnehmen willst.
Die bekannten Verdächtigen
Die vier Plugins, die du immer wieder im deutschsprachigen Raum hörst, sind Yoast SEO, Rank Math, SEOPress und The SEO Framework. Alle vier können das Wesentliche, unterscheiden sich aber im Funktionsumfang und – das ist mir wichtig – in der Schlankheit der Oberfläche.
Yoast ist der Platzhirsch und hat alles, was man sich wünschen kann. Verursacht aber bei vielen Seiten Probleme bei Updates. Rank Math ist eine spürbar leichtere Alternative mit ähnlichem Funktionsumfang. SEOPress kommt aus Frankreich und hat einen guten Ruf im deutschsprachigen Raum, war mir aber zu überladen. The SEO Framework ist das schlankeste der vier und genau das, was ich bevorzuge.
Hier auf perun.net und bei mehreren Kundenprojekten setze ich seit einer Weile The SEO Framework ein. Wer wissen will, wie ich dort gelandet bin und was meine Kriterien waren, dem empfehle ich meinen Erfahrungsbericht: Wechsel von wpSEO zu SEOPress zu The SEO Framework. Spoiler: Die schlanke Oberfläche hat gegen die Feature-überladenen Alternativen gewonnen.
Was nicht heißt, dass die anderen schlecht sind. Wer Yoast bereits kennt und gut damit zurechtkommt, hat keinen Grund, umzusteigen. Aber wer gerade startet, sollte sich The SEO Framework auf jeden Fall anschauen.
WooCommerce: Wenn aus dem Blog ein Shop wird
Sobald WooCommerce ins Spiel kommt, wird die SEO-Geschichte etwas wuseliger. Aus einer Handvoll Beiträge und Seiten werden plötzlich Produktseiten, Produktkategorien, Varianten, Filter-URLs und je nach Setup auch noch Merchant-Center-Daten.
Was sich daraus an SEO-Aufgaben ergibt, ist anders gelagert als beim klassischen Blog. Drei Punkte halte ich für besonders wichtig:
Produktseiten brauchen eigenen Inhalt. Wer einfach den Herstellertext übernimmt, konkurriert mit einem Dutzend anderer Shops, die den gleichen Text einsetzen. Eigene Beschreibungen, ein paar konkrete Hinweise zur Eignung des Produkts und ehrliche Antworten auf typische Fragen sind hier deutlich wertvoller als jede Schema-Optimierung.
Produktkategorien sind oft die eigentlichen Landingpages. Einzelne Produkte kommen und gehen, Kategorien bleiben über Jahre bestehen. Ein kurzer, hilfreicher Einleitungstext oben auf der Kategorieseite ist meiner Erfahrung nach mehr wert als 1.500 Wörter Füllmasse irgendwo darunter.
Strukturierte Produktdaten sollten konsistent sein. Wenn WooCommerce, ein SEO-Plugin und ein Theme alle parallel Schema.org-Markup ausgeben, kann das Ergebnis schnell widersprüchlich werden. Hier lohnt sich ein gelegentlicher Blick mit dem Rich Results Test, um zu sehen, was Google tatsächlich erkennt.
WooCommerce-SEO ist ein Thema für sich und wird in einem späteren Artikel ausführlicher behandelt. Für den Pillar-Überblick reicht der Hinweis: Wer einen Shop betreibt, hat einen Teil der oben genannten Themen plus einen ganzen Strauß zusätzlicher Punkte auf dem Tisch.
AI Overviews, LLMs und das neue Suchverhalten
Wenn ich diesen Artikel vor drei oder vier Jahren geschrieben hätte, wäre dieser Abschnitt nicht drin gewesen. Das Thema hatte damals einfach noch nicht die Relevanz, die es heute hat. Inzwischen haben sich Google AI Overviews, ChatGPT-Suche und ähnliche generative Antwortmaschinen so weit etabliert, dass kein SEO-Artikel daran vorbeikommt.
Was AI‑Overviews mit deinem Traffic machen
Die nüchternen Zahlen zuerst: Wenn Google für eine Suchanfrage eine KI-Zusammenfassung über den klassischen Suchergebnissen einblendet, gehen die Klicks auf die organischen Treffer messbar zurück. Verschiedene Studien aus 2025 und 2026 zeigen Rückgänge in einer breiten Spanne von rund 18 Prozent bis zu über 46 Prozent, je nach Methodik und Suchanfragen-Typ. Besonders betroffen sind informationelle Suchanfragen, also genau das, womit Blogs traditionell ihren Traffic generieren.
Klar, nicht jede Suchanfrage löst eine AI‑Overview aus, und in einigen Branchen sind die Auswirkungen begrenzter als in anderen. Aber die Richtung ist eindeutig: Wer früher allein vom organischen Suchtraffic gelebt hat, sollte das Geschäftsmodell überdenken. Ich habe das Thema – inklusive der praktischen Konsequenzen für kleine und mittlere Anbieter – in einem eigenen Artikel ausführlich behandelt: ChatGPT SEO: Die Evolution des Suchbegriffs. Wer sich mit den konkreten Gegenmaßnahmen beschäftigen möchte, findet außerdem in meinem älteren Beitrag Zero Click Searches: Fluch oder Segen für deine Website? eine Übersicht der Möglichkeiten: Newsletter, RSS, Community-Aufbau und Co.
GEO: Neues Spielfeld oder alter Wein in neuen Schläuchen?
Unter dem Begriff Generative Engine Optimization (GEO) hat sich seit 2024 eine ganze Marketing-Industrie zusammengefunden, die dir erklärt, wie du in KI-Antworten zitiert wirst. Wobei ich hier zur Mäßigung rate. Die meisten der bekannten GEO-Tipps, strukturierte Inhalte, klare Antworten auf konkrete Fragen, vertrauenswürdige Quellenangaben, sind im Kern altbekannte SEO‑Empfehlungen. Wer schon vorher saubere Inhalte mit guter Struktur veröffentlicht hat, ist auch für die KI-Welt halbwegs gerüstet.
Was sich allerdings tatsächlich verschiebt, ist der Fokus: Statt nur ranken zu wollen, geht es darum, zitiert zu werden. Und das ist eine andere Disziplin. Nicht radikal anders, aber mit eigenen Akzenten.
LLM-Crawler: zulassen, blockieren oder differenzieren?
Eine praktische Frage, die mir oft gestellt wird: Soll ich die KI-Crawler von OpenAI, Anthropic, Google und anderen auf meiner Seite zulassen oder per robots.txt blockieren? Die Antwort hängt davon ab, was du erreichen willst.
Wer möchte, dass seine Inhalte in ChatGPT, Claude oder Gemini auftauchen, der muss die entsprechenden Crawler grundsätzlich zulassen. Wer das aus prinzipiellen Gründen ablehnt, kann sie blockieren. Verzichtet damit aber auch auf die Sichtbarkeit in den genannten Systemen. Eine Mischlösung gibt es ebenfalls: einzelne Crawler differenziert behandeln, je nachdem, wie der Anbieter mit Inhalten umgeht.
Meine pragmatische Linie: Ich lasse die meisten Crawler zu, weil mir die Sichtbarkeit wichtiger ist als das Prinzip. Aber ich kann jeden verstehen, der das anders entscheidet.
Was ist mit llms.txt?
Seit 2024 geistert ein Vorschlag namens llms.txt durch die SEO‑Welt. Eine Art Sitemap, speziell für KI‑Modelle. Die Idee klingt zunächst plausibel: Du legst eine Markdown-Datei im Wurzelverzeichnis an, die LLMs auf die wichtigsten Inhalte deiner Seite hinweist.
Wobei ich ehrlich sagen muss: Die aktuelle Datenlage spricht eher gegen einen großen Effekt. Mehrere unabhängige Untersuchungen aus 2025 und 2026 (etwa von SE Ranking und ALLMO.ai) konnten keinen messbaren Zusammenhang zwischen vorhandenenllms.txt und tatsächlichen Zitaten in KI-Antworten feststellen. Auch Googles John Mueller hat in mehreren öffentlichen Aussagen klargestellt, dass die Google-Suche das Format nicht nutzt und keine AI-Systeme die Datei aktiv abfragen. Nachzulesen etwa beim Search Engine Roundtable.
Mein Fazit für 2026: llms.txt ist mit überschaubarem Aufwand einrichtbar, und manche Plugins wie Yoast SEO erstellen das mittlerweile automatisch. Wenn dich das Thema nicht abschreckt, kannst du es mitnehmen, aber als Ranking-Wunderwaffe würde ich es nicht verkaufen. Schau’n wir mal, ob sich daraus mittelfristig ein Standard entwickelt oder ob es im Sande verläuft.
Meine Einschätzung
Die KI-getriebene Veränderung des Suchverhaltens ist real und wird sich in den nächsten Jahren weiter verstärken. Mit dieser Einschätzung stehe ich nicht allein. Was ich allerdings nicht teile, ist die Panik, die damit oft einhergeht. Wer seit Jahren saubere, hilfreiche Inhalte zu seinem Themenfeld veröffentlicht und eine eigene Community aufbaut, sei es über Newsletter, RSS oder direkte Leserbeziehungen, der ist deutlich besser aufgestellt als jemand, der allein auf SEO-Traffic gewettet hat.
Die wichtigste Lektion aus den letzten Jahren: Verlasse dich nicht auf eine einzige Trafficquelle. Das war 2011 schon eine gute Idee und ist es heute mehr denn je.
Alte Inhalte als das Stiefkind im SEO-Alltag
Wer länger bloggt, hat irgendwann das Problem, das ich auch habe: einen Berg an Altartikeln, die teilweise nicht mehr aktuell, manchmal sogar peinlich, aber meist noch im Index sind. Was tun damit? Komplett löschen? Aktualisieren? In Ruhe lassen?
Meine Standard-Antwort: Es kommt darauf an. Aber ein paar Faustregeln gibt es schon.
Wann sich eine Aktualisierung lohnt
Wenn ein älterer Artikel zu einem Thema gehört, das nach wie vor relevant ist, lohnt sich oft die Aktualisierung statt eines komplett neuen Beitrags. Vorteile: Die URL bleibt erhalten, eingehende Links bleiben aktiv, die bisherige Position in den Suchergebnissen bleibt erstmal stehen. Nachteil: Aktualisieren ist anspruchsvoller, als man denkt – manchmal ist es einfacher, einen neuen Artikel zu schreiben.
Mein Pragmatismus: Wenn der Originalartikel einen guten Aufbau hat und nur die Fakten veraltet sind, aktualisiere ich. Wenn die ganze Argumentation überholt ist, schreibe ich einen neuen Beitrag und setze, wo sinnvoll, eine Weiterleitung von der alten zur neuen URL.
Bei der Bewertung alter Inhalte hilft eine grobe Einteilung in vier Kategorien: aktualisieren (der Artikel hat noch Potenzial), zusammenführen (mehrere schwache Beiträge ergeben einen starken), weiterleiten (alter Artikel ist überholt, aber eine passende neue URL existiert) oder noindex (Inhalt soll online bleiben, aber nicht mehr in der Suche erscheinen).
Warum ich noindex statt löschen wähle
Bei Artikeln, die ich nicht mehr in der Suche haben will, aber auch nicht löschen mag (Stichwort Lesezeichen, eingehende Links, eigene Verweise aus späteren Beiträgen), setze ich seit einer Weile gezielt auf noindex ohne nofollow. Das ist eine bewusste Entscheidung: Ich will den Artikel zwar aus dem Suchergebnis nehmen, aber die internen Links, die er auf andere – noch indexierte – Beiträge setzt, sollen weiter wirken.
Was du auf jeden Fall vermeiden solltest: einfach Artikel zu löschen, ohne über die Konsequenzen nachzudenken. Jeder gelöschte Artikel produziert einen 404-Fehler, sobald jemand (ein Mensch oder ein Bot) die alte URL aufruft. Das ist nicht das Ende der Welt, aber unsauber.
Wenn du einen Artikel wirklich entfernen willst, gibt es drei sinnvolle Optionen: eine 301-Weiterleitung auf einen verwandten, aktuellen Beitrag, eine Weiterleitung auf eine passende Kategorie-Seite oder – wenn nichts davon passt – ein bewusstes 410 (Gone), das Suchmaschinen klar signalisiert: Diese Seite existiert nicht mehr und kommt auch nicht wieder.
Monitoring und was du wirklich messen solltest
SEO ohne Monitoring ist wie Autofahren mit verbundenen Augen: Du kommst vielleicht voran, aber wohin, weißt du nicht. Was du im Auge behalten solltest, hängt von deinen Zielen ab – die Werkzeuge sind aber weitgehend die gleichen.
Google Search Console: immer noch das wichtigste kostenlose Werkzeug
Wenn du nur ein einziges SEO-Tool nutzt, dann dieses: Die Google Search Console ist kostenlos, verlässlich und liefert dir Informationen, die du nirgendwo sonst bekommst – etwa welche Suchanfragen zu deiner Seite führen, wie oft deine Seiten gezeigt und geklickt werden und welche Fehler Google beim Crawlen findet.
Die wichtigsten Berichte aus meiner Sicht: der Leistungsbericht (Suchanfragen, Klicks, Impressionen), der Indexierungsbericht (welche Seiten sind im Index, welche nicht) und seit einiger Zeit auch der Core-Web-Vitals-Bericht.
Analytics mit oder ohne Datenschutzkopfschmerzen
Beim Web-Analytics ist die Lage 2026 unübersichtlich. Google Analytics 4 ist nach wie vor verbreitet, aber rechtlich heikel und für viele Nutzer schlicht unverständlich aufgebaut. Datenschutzfreundliche Alternativen wie Matomo, Plausible oder Fathom sind aus meiner Sicht der bessere Weg, sofern dein Auswertungsbedarf nicht zu komplex ist.
Was ich praktisch empfehle: ein Analytics-Tool, mit dem du die wichtigsten Fragen beantworten kannst: Woher kommen meine Besucher und welche Inhalte funktionieren? Mehr brauchen die meisten kleineren Projekte gar nicht. Dafür ist Koko Analytics ausreichend.
Welche Kennzahlen wirklich aussagekräftig sind
Es gibt eine Menge Metriken, die hübsch aussehen, aber wenig sagen. Eine Kennzahl wie »Bounce Rate« beispielsweise ist für viele Inhaltstypen schlicht irreführend. Was ich mir tatsächlich anschaue:
Bei der Search Console schaue ich, welche Suchanfragen mir Klicks bringen und welche viele Impressionen, aber wenige Klicks erzeugen. Klarer Hinweis auf optimierbare Titel und Meta-Beschreibungen. Bei Analytics interessiert mich, welche Inhalte tatsächlich gelesen werden, woher die Besucher kommen und welche externen Quellen funktionieren.
Wie oft sollte man draufschauen? Aus meiner Erfahrung: Einmal pro Woche ist für viele Projekte ausreichend.
Typische Fehler aus der Praxis
Bevor wir zum Fazit kommen, ein paar Fehler, die mir in den vergangenen Jahren sowohl bei eigenen als auch bei Kundenprojekten regelmäßig begegnet sind. Manche davon habe ich auch selbst gemacht. Das gehört zum Lernen dazu.
Permalinks nachträglich ändern
Klassiker Nummer eins: Eine Website läuft seit Jahren stabil, dann beschließt jemand, die Permalink-Struktur »schöner« zu machen. Aus /2024/03/15/artikelname/ wird /blog/artikelname/. Klingt aufgeräumter, ist aber ein Rezept für 404er auf breiter Front, sofern keine ordentlichen Weiterleitungen mit aufgesetzt werden.
Mein Rat: Permalinks ändert man nur, wenn es einen wirklich triftigen Grund gibt. Und dann nur mit einer sauberen 301-Weiterleitungs-Strategie für alle alten URLs.
Plugin-Stapelei
Zweiter Klassiker: Für jedes kleine Problem ein eigenes Plugin. Am Ende stehen 30 oder 40 Plugins im Backend, von denen die Hälfte sich gegenseitig ins Gehege kommt, ein Drittel seit zwei Jahren keine Updates mehr bekommen hat und der Rest die Ladezeit verlängert.
Was ich versuche: Vor jeder Plugin-Installation zu prüfen, ob sich das Problem nicht auch ohne Plugin lösen lässt etwa mit ein paar Zeilen Code im Theme oder mit Bordmitteln von WordPress.
Staging und Relaunch: kleine Unachtsamkeiten, große Wirkung
Ein Klassiker, der viel Schaden anrichten kann: Eine Staging- oder Testumgebung wird nicht richtig vor Suchmaschinen geschützt und landet im Google-Index. Oder – noch unangenehmer – beim Relaunch wird die noindex-Einstellung der Live-Seite vergessen.
Beides passiert schneller, als man denkt. Vor jedem Relaunch lohnt sich daher eine kurze Checkliste: Ist die Live-Seite wirklich indexierbar? Sind Test- und Staging-Systeme per noindex oder Passwortschutz abgesichert? Stimmen die Canonicals? Funktionieren die wichtigsten Weiterleitungen?
SEO-Mythen, die sich hartnäckig halten
Es gibt eine Reihe von Mythen, die sich seit Jahren halten, und kaum jemand kann erklären, warum. »Keyword-Dichte muss bei 2 Prozent liegen« ist ein solcher Klassiker. Google hat die Keyword-Dichte als Ranking-Faktor seit über einem Jahrzehnt nicht mehr als bedeutsam betrachtet. Ähnlich die »Duplicate-Content-Panik«: Wer denselben Inhalt in zwei verschiedenen Sprachen oder als Print- und Online-Variante hat, muss sich keine Sorgen machen, dass Google das abstraft.
Wer immer noch nach starren Keyword-Quoten optimiert oder bei jeder identischen Phrase Panik bekommt, verschwendet Energie an die falschen Stellen.
Zu viel Technik, zu wenig Substanz
Das ist vielleicht der wichtigste Punkt: Viele Website-Betreiber stecken endlos Energie in technische Mikro-Optimierungen – das letzte Millisekündchen LCP, das perfekte Schema-Markup, das letzte Quäntchen Cache-Optimierung – und schreiben dabei seltener und schlechter. Aus meiner Sicht ist das Verhältnis falschherum. Lieber einmal pro Woche einen ordentlichen Artikel schreiben als zweimal pro Woche an der robots.txt feilen.
Mein Fazit für WordPress-SEO 2026
Wenn ich diesen Artikel auf einen Satz reduzieren müsste, dann würde der lauten: Mach die Grundlagen ordentlich, lass dich nicht von jedem Hype anstecken und verlasse dich nicht auf eine einzige Trafficquelle.
Was 2026 wirklich neu ist: Die KI-getriebenen Antwortmaschinen verändern, wie und wo Inhalte gefunden, gelesen und zitiert werden. Das ist eine reale Verschiebung, und sie wird sich in den nächsten Jahren weiter verstärken. Wer früher allein vom organischen Suchtraffic gelebt hat, sollte das Geschäftsmodell überdenken. Das war im Zero-Click-Artikel schon vor drei Jahren kein neues Thema mehr und ist heute akuter denn je.
Was bleibt: Inhalte, die einen echten Mehrwert liefern. Eine technisch saubere Website. Geduld. Und vielleicht der wichtigste Punkt: ein zweites oder drittes Standbein neben Google. Newsletter, RSS, eine eigene Community. Das sind die Kanäle, die dir niemand wegnehmen kann, weil keine Such-Engine zwischen dir und deinen Lesern steht.
Wer das im Hinterkopf hat, schaut auf die Entwicklungen der nächsten Jahre vermutlich entspannter als jemand, der bei jedem neuen Algorithmus-Update Schweißausbrüche bekommt. Mal schauen, wie sich das Ganze in den nächsten zwei bis drei Jahren entwickelt.
Wie schaut es bei euch aus? Welches der genannten Themen findet ihr 2026 am wichtigsten und welches überbewertet? Habt ihr eine eigene Strategie für die KI-getriebenen Veränderungen entwickelt? Ich freue mich über eure Erfahrungen in den Kommentaren.
Nachtrag, 17. Mai 2026
Google hat am 15. Mai 2026 ein eigenes Dokument zur Optimierung für generative AI-Features veröffentlicht: Optimizing your website for generative AI features on Google Search. Lohnenswerte Lektüre, vor allem weil Google an mehreren Stellen offiziell festhält, was andere und ich auch schon vermutet haben. Die für mich wichtigsten Punkte:
llms.txt ist nicht nötig. Google sagt es klipp und klar: Du musst keine speziellen maschinenlesbaren Dateien oder Markdown-Files anlegen, um in den generativen AI-Antworten aufzutauchen. Das deckt sich mit meiner Einschätzung weiter oben.
GEO und AEO sind keine eigenen Disziplinen. Google formuliert es so: Optimierung für generative AI-Suche ist Optimierung für die Suche und damit weiterhin schlicht SEO. Wer dir etwas anderes verkaufen möchte, sollte zumindest erklären können, warum.
Strukturierte Daten sind nicht erforderlich für generative AI-Antworten, aber weiterhin nützlich für Rich Results. Keine Überraschung, aber gut, das mal offiziell zu lesen.
Query fan-out: Google bestätigt, dass aus einer Nutzerfrage automatisch mehrere parallele Suchanfragen erzeugt werden, um passende Inhalte zu finden. Genau das ist der Grund, warum es heute sinnvoller ist, in Themenfeldern und konkreten Fragen zu denken, statt sich an einzelnen Keywords festzuhalten und diese abzuarbeiten.
Fragen und Antworten
Sollte ich bei einem neuen Blog mit einer Subdomain (blog.firma.de) oder einem Verzeichnis (firma.de/blog/) starten?
Kurze Antwort: In den meisten Fällen mit dem Verzeichnis.
Suchmaschinen behandeln Subdomains technisch wie eigenständige Websites. Das heißt, der ganze Vertrauensbonus, den deine Hauptdomain über die Jahre aufgebaut hat, hilft dem Blog auf der Subdomain nur eingeschränkt. Beim Verzeichnis profitiert der Blog dagegen direkt von der gesamten Domain-Autorität.
Es gibt Situationen, in denen eine Subdomain Sinn ergibt: wenn der Blog technisch komplett getrennt laufen muss (anderes CMS, andere Server-Architektur) oder wenn es sich um ein eigenständiges Projekt mit eigener Identität handelt. Für den klassischen Unternehmensblog ist das Verzeichnis aber meine Standardempfehlung.
Wie verhalte ich mich bei einem Domain-Umzug aus SEO-Sicht?
Ein Domain-Umzug ist einer der riskantesten Schritte, die man mit einer etablierten Website machen kann. Wenn die Vorbereitung schludrig ist, verlierst du im schlimmsten Fall einen großen Teil deines Suchtraffics auf Monate.
Was du auf jeden Fall brauchst: eine vollständige Liste aller URLs der alten Domain, dazu eine saubere 301-Weiterleitungs-Strategie, die jede einzelne alte URL auf das passende neue Gegenstück lenkt. Pauschal alles auf die neue Startseite weiterzuleiten, ist der häufigste Fehler und SEO-mäßig fast so schlecht wie gar keine Weiterleitungen.
Zusätzlich solltest du beide Domains in der Google Search Console verifizieren, dort den Adressänderungs-Antrag stellen und in den ersten Wochen nach dem Umzug intensiv beobachten, ob die Indexierung sauber durchläuft.
Praktischer Hinweis: Plane für den Umzug mindestens eine Woche reines Vorbereitungs-Zeitfenster ein, wenn du die Sache selbst stemmst. Den Umzug ein bis zwei Tage vor dem Flug in den Urlaub anzusetzen, ist keine gute Idee.
Lohnen sich klassische Backlinks 2026 überhaupt noch?
Kurze Antwort: ja, aber nicht in der Form, in der Backlinks früher gehandelt wurden.
Die Zeiten, in denen man Linktauschnetzwerke, Webkataloge oder gekaufte Gastbeiträge mit Linkboost als SEO-Strategie verkaufen konnte, sind seit Jahren vorbei. Google erkennt solche Muster relativ zuverlässig, und im schlimmsten Fall handelst du dir damit eine manuelle Maßnahme ein.
Was nach wie vor funktioniert, sind echte, redaktionell motivierte Verlinkungen: Jemand verlinkt deinen Artikel, weil er ihn relevant oder hilfreich findet. Diese Art von Backlink ist wertvoll wie eh und je, und sie ist auch eines der wenigen klaren Signale, an denen sich KI-Antwortsysteme wie ChatGPT oder Perplexity orientieren, wenn sie Quellen auswählen.
Wie bekommt man solche Backlinks? Indem man Inhalte schreibt, die es wert sind, verlinkt zu werden. Klingt banal, ist aber die einzige nachhaltige Antwort.
Wie schreibe ich Inhalte, die wahrscheinlicher in KI-Antworten zitiert werden?
Ganz ehrlich: Niemand außerhalb der LLM-Anbieter weiß mit Sicherheit, wie deren Auswahlmechanismen funktionieren. Aber es gibt ein paar Muster, die sich in der Praxis abzeichnen.
KI-Systeme bevorzugen tendenziell Inhalte, die eine klare Frage direkt beantworten, eine eindeutige Position vertreten und sich an konkreten Beispielen festmachen lassen. Schwammige Allgemeinplätze und »Es kommt darauf an«-Texte werden seltener zitiert, auch wenn sie inhaltlich nicht falsch sind.
Praktische Ableitungen:
Frage als Überschrift oder Zwischenüberschrift, klare Antwort im ersten Satz darunter
Eigene Einschätzung oder Empfehlung deutlich kennzeichnen, statt nur Optionen aufzulisten
Strukturierte Daten und saubere HTML-Semantik helfen wahrscheinlich, allerdings ist die Studienlage hier noch dünn
Was sich erkennbar nicht lohnt, ist die Anfertigung spezieller »KI-Versionen« von Inhalten oder die mechanische Optimierung auf vermeintliche GEO‑Faktoren. Gute Inhalte mit klarer Struktur sind 2026 auch die Inhalte, die KI-Systeme bevorzugt zitieren.
Vor drei Tagen wurde Firefox 150 veröffentlicht und drei kleine Funktionen haben es mir besonders angetan. Du kannst dir im neuen Tab einen Notizblock und einen Pomodoro-Timer einblenden lassen. Zudem kannst du jetzt ohne ein zusätzliches Addon Notizen für einen Tab erstellen.
Klar, für alle drei Funktionen gibt es entsprechende Addons, aber ich bevorzuge es, wenn ich schon eine Funktion nutze, dass die zu den Bordmitteln gehört. Ich erhoffe mir davon eine bessere Integration im Browser und einen besseren Support.
Du kannst diese neuen Funktionen aktivieren, indem du unter Einstellungen → Firefox Labs die beiden Checkboxen aktivierst. Es sind eigentlich drei Funktionen, aber Listen und Timer wurden zu einer Checkbox zusammengefasst. Eventuell musst du noch das Verhalten für neuen Tab unter Einstellungen → Startseite → Neue Tabs.
Einstellungen → Firefox Labs
Die Notiz zu einem Tab kannst du erstellen, indem du mit Rechtsklick das Kontextmenü aufrufst und Notiz hinzufügen anklickst. Anschließend kannst du deinen Text eingeben. Formatierungen sind nicht möglich, was an sich nicht schlimm ist, da diese Funktion erst einmal nur für kurze Nachrichten gedacht ist. Emojis kannst du ebenfalls einfügen.
Nach dem Abspeichern der Notiz bekommt der Tab ein zusätzliches Icon. Wenn du den Cursor drüberhältst, dann erscheint die Notiz. Auch wenn die Funktionalität noch recht spartanisch ist, reicht sie dennoch, um mehr oder weniger 😁 wichtige Hinweise unterzubringen und den Tab visuell hervorzuheben.
Ich freue mich, dass die Entwicklung von Firefox weiter vorangeht. Ich arbeite sehr viel mit Chrome und bin immer wieder froh, wenn ich zu Firefox zurückkehren kann. Es ist nicht die Gewohnheit, sondern ich finde, dass Firefox ein wesentlich schöneres Schriftbild auf Websites darstellt als Chrome.
Wie schaut es bei euch aus? Noch jemand, der an Firefox festhält und sich freut, dass es Alternativen gibt?
Vergangene Woche habe ich es endlich geschafft, diese Website aus dem Winterschlaf zu holen. Dabei habe ich dann auch einen näheren Blick auf die mehr als 3.400 Blogartikel zu werfen.
Einige davon waren deutlich in die Jahre gekommen. Entweder nicht mehr relevant oder schlicht zu kurz und zu dünn für heutige Verhältnisse: Gewinnspiele aus 2007, Ankündigungen über bevorstehende Veranstaltungen aus 2008, kurze News-Meldungen etc. Solche Inhalte einfach weiter in der Google-Suche mitschwimmen zu lassen, ist selten eine gute Idee.
Wer über einen veralteten oder für den restlichen Inhalt der Website unrelevanten Treffer reinkommt, geht schnell wieder, weil er weder einen guten Eindruck vom Blog noch wirklich hilfreiche Informationen mitgenommen hat.
Warum nicht direkt löschen?
Löschen wäre einfach gewesen. Hierfür gibt es in WordPress direkt ein Bordmittel. Aber ich wollte die Artikel nicht löschen. Zum einen hänge ich ein wenig an diesen alten Texten. Sie sind praktisch ein kleines Tagebuch aus verschiedenen Phasen des Webs und aus der Entwicklung von WordPress selbst.
Zum anderen gibt es Altlinks, Lesezeichen und interne Verlinkungen, die ich mir mit einer Löschaktion komplett zerschießen würde. 404er an allen Ecken und Enden sind für niemanden ein Gewinn.
Andererseits sollte die Bereinigungsaktion auch nicht zu viel Arbeit in Anspruch nehmen und hier gab es schon ein erstes kleines Problem. Die gängigen großen SEO-Plugins erlauben zwar, einzelne Artikel oder bestimmte Bereiche (Kategorien, Schlagwörter etc.) für Suchmaschinen auszublenden. Was ich aber benötigte, war eine schnelle Übersicht über die Blogartikel und die Möglichkeit, einzelne oder mehrere Artikel direkt in der Übersicht auf noindexzu setzen.
Das Plugin: Bulk NoIndex & NoFollow Toolkit
Für solche Aufräumaktionen gibt es ein schlankes und praktisches Plugin: Bulk NoIndex & NoFollow Toolkit aus dem Haus Mad Fish Digital. Wie der Name schon verrät, kannst du damit mehrere Beiträge oder Seiten auf einmal auf noindex und/oder nofollow umstellen.
Die Bedienung läuft über die Bulk-Aktionen in der Beitragsübersicht im WordPress-Backend. Du markierst wie gewohnt die gewünschten Beiträge, wählst im Dropdown die passende Aktion aus und schließt mit »Apply« ab.
Bulk Noindex im Backend: Im Bereich “Werkzeuge” kannst du das Plugin ansteuern und stapelweise Blogbeiträge auf noindex oder nofollow setzen
Du kannst die Blogartikel nach Anzahl der Wörter, nach Anzahl der Zeichen oder nach Datum sortieren und dann entweder stapelweise (Bulk Actions) oder einzeln in der Übersicht auf noindex und/oder nofollow setzen.
Mad Fish Digital hat auf dem eigenen Blog auch einen passenden Hintergrundartikel dazu: Bulk NoIndex WordPress Pages. Dort geht man etwas genauer darauf ein, warum sie das Plugin überhaupt gebaut haben und in welchen SEO-Szenarien sich der Einsatz lohnt.
Warum nur noindex und nicht nofollow?
Hier ein Punkt, der häufig durcheinandergeworfen wird. noindex bedeutet: Google soll diese Seite nicht mehr in den Index aufnehmen oder sie dort wieder entfernen. Dagegen steht nofollow dafür, dass die Suchmaschinen in den jeweiligen Artikeln nicht mehr folgen sollen.
Ich habe mich bewusst gegen nofollow entschieden. Der Grund: In den alten Artikeln gibt es viele interne Links auf andere Beiträge von mir, die ich weiterhin im Index haben möchte. Wenn ich jetzt zusätzlich nofollow gesetzt hätte, wären diese internen Link-Signale einfach weg.
Fazit und offene Fragen
Du musst alte Inhalte nicht löschen, damit sie aus der Google-Suche verschwinden. Mit einer bewussten noindex-Entscheidung kannst du Ballast aus dem Index nehmen, ohne die Verlinkung und die historische Substanz deines Blogs zu opfern. Das Bulk NoIndex & NoFollow Toolkit hilft dir bei der Fleißarbeit und ist für solche Aufräumaktionen ein ordentliches Werkzeug.
Wie schaut es bei euch aus? Macht ihr solche Aufräumaktionen, und falls ja, wie oft, und welche Tools nutzt ihr dabei?
1. Wie lange dauert es, bis Google die Artikel tatsächlich aus dem Index entfernt?
Das hängt davon ab, wie oft Google deine Website crawlt und wie gut die interne Verlinkung zu den betroffenen Seiten ist. In der Google Search Console kannst du den Fortschritt im Index-Bericht mitverfolgen. Beschleunigen lässt sich der Prozess, indem du einzelne URLs dort zur erneuten Überprüfung einreichst.
2. Sollte ich die auf noindex gesetzten Artikel zusätzlich aus der XML-Sitemap entfernen?
Ein klares Jein. Damit Google den noindex-Hinweis überhaupt mitbekommt, muss der Bot die Seite ja weiterhin besuchen können. Bleibt die URL vorerst in der Sitemap, wird sie regelmäßig gecrawlt, und der noindex-Status wird schneller erkannt. Erst wenn die Seite stabil aus dem Index gefallen ist, kann sie auch aus der Sitemap raus. Die meisten SEO-Plugins, darunter auch The SEO Framework, nehmen noindex-Seiten automatisch aus der Sitemap. Ein Blick in die eigenen Einstellungen und in die Sitemap schadet trotzdem nicht.
3. Ist ein 301-Redirect auf einen aktuellen Artikel nicht die elegantere Lösung?
Wenn es einen klaren Nachfolger gibt, dann ja. Ein 301 gibt die Backlink-Signale an den neuen Artikel weiter und ist in solchen Fällen meistens die bessere Wahl. In meinem konkreten Fall geht es aber um alte Beiträge, zu denen schlicht kein echter Nachfolger existiert. Auf die Startseite weiterleiten oder auf »irgendwas grob Ähnliches« wäre sinnlos und würde niemandem helfen.
Ich hatte jahrelang Google Alerts im Einsatz. Für WordPress, für WooCommerce, für ChatGPT, Gemini, Claude und was sonst noch so im KI-Bereich passiert. Das waren manchmal bis zu acht einzelne E-Mails pro Tag, die in meinem Posteingang gelandet sind. Klingt zunächst nach einem guten System. Ist es aber auf Dauer nicht.
Das Problem mit Google Alerts
Google Alerts macht genau das, was man von dem Dienst erwarten kann: Es schickt dir alles, was es findet. Ungefiltert, unsortiert und häufig auch doppelt. Die gleiche Meldung über zwei bis drei verschiedene Alerts – zum Beispiel beim Thema WordPress und WooCommerce – war keine Seltenheit.
Dann mal eine News-Meldung, mal eine Anleitung, mal ein Forenbeitrag aus der grauen Vorzeit, der aus unerfindlichen Gründen wieder aufgetaucht ist. Das war weder effizient noch zufriedenstellend. Ich habe mehr Zeit damit verbracht, irrelevante Treffer zu überfliegen und Dopplungen zu ignorieren, als tatsächlich etwas Nützliches daraus mitzunehmen. Irgendwann war klar: Das muss besser gehen.
Workspace Studio von Google: Flows statt Alerts
Seit einiger Zeit bietet Google mit Workspace Studio ein Tool an, mit dem du automatisierte Abläufe, sogenannte Flows, erstellen kannst. Verbinden kannst du eine Reihe an Google-Diensten: Gemini, Gmail, Docs, Sheets, NotebookLM, Chat, Meet, Kalender und Tasks.
Das Prinzip ist simpel und dadurch sympathisch: Du definierst einen Auslöser, verknüpfst das mit einer Aktion und am Ende kommt ein Ergebnis heraus. In meinem Fall ein Zeittrigger, der morgens den Flow auslöst. Dieser beauftragt Gemini, nach aktuellen Meldungen zu suchen, sie zu bewerten und zu sortieren. Im letzten Schritt übergibt Gemini den Text an Gmail und ich bekomme vor der Arbeit eine E-Mail mit allen relevanten Meldungen.
Du benötigst dafür kein technisches Vorwissen. Wer mit der Maus umgehen kann, kann das Tool bedienen.
Ein einfacher Flow in Google Workspace Studio
Wie mein Flow aufgebaut ist
Der Aufbau ist mehr als einfach. Ich habe zwei Flows erstellt. Einen für den Themenkomplex »WordPress & WooCommerce« und einen für »Alles rund um KI«. Aus den vorherigen sieben bis acht täglichen E-Mails sind damit genau zwei geworden.
Jeder Flow folgt dem gleichen Muster:
Zeittrigger: Jeden Morgen um 08:00 Uhr wird der Flow automatisch gestartet.
Gemini-Schritt: Gemini bekommt eine Anweisung und macht sich an die Arbeit. Es sucht nach aktuellen Meldungen aus den letzten 24 Stunden, filtert die Ergebnisse und bereitet sie auf. Hier kannst du die üblichen Prompting-Techniken verwenden, um die Art der Quellen zu benennen und Gemini zu sagen, wie er den Text sortieren und formatieren soll.
E-Mail-Versand: Das Ergebnis wird mir via Gmail zugeschickt.
Den Zeitraum habe ich auf 24 Stunden gesetzt, da ich jeden Tag eine E-Mail bekomme. Möchtest du nur einmal die Woche eine E-Mail bekommen, dann erhöhst du entsprechend die Zeit. Du kannst anstatt Versand per E-Mail auch eine Chat-Nachricht wählen, oder speichern in Google Docs. Je nachdem, was du bevorzugst.
Bevor du den Flow dann endgültig startest, kannst du auch vorher testen. Das empfiehlt sich vor allem, wenn eine Nachricht oder Meldung an mehrere Empfänger verschickt wird. Falls du Inspirationen suchst, dann findest du unter »Discovery« knapp zwei Dutzend vorgefertigte Flows.
Der Gemini-Prompt macht den Unterschied
Wie bei allen KI-gestützten Lösungen gilt auch hier: Die Qualität der Ergebnisse hängt maßgeblich von der Frage ab. Oder in diesem Fall: vom Prompt. Ein Auszug aus meiner Anweisung an Gemini:
Handle als spezialisierter KI-News-Kurator. Deine Aufgabe ist es, ein präzises Update über die Entwicklungen der letzten 24 Stunden zu liefern. [...]
Dazu kommen weitere Anweisungen: keine Dopplungen, die Meldungen nach »News« und »Anleitungen« sortieren, und zu jeder Meldung einen Link zur Originalquelle einfügen. Das Ergebnis kommt als saubere Liste daher: Titel, kurzer Teaser und der Link zur Quelle. Kein unnötiger Fließtext, direkt auf den Punkt.
Nachtrag: In den Kommentaren wurde zu Recht darauf hingewiesen, dass hier nur der Anfang des Prompts steht. Diesen habe ich allerdings nicht weggelassen, um mögliche Geheimnisse verbergen zu wollen, sondern weil der Prompt wirklich nichts Besonderes ist. Ich habe mich einfach mit Gemini unterhalten, ihm geschildert, was ich benötige, und er hat mir dann einen Systemprompt erstellt. Den habe ich lediglich nach einigen Tagen an ein paar Stellen an meine Bedürfnisse angepasst. Hier der vollständige Prompt:
Handle als spezialisierter KI-News-Kurator. Deine Aufgabe ist es, ein präzises Update über die Entwicklungen der letzten 36 bis 48 Stunden zu liefern.

Kontext:
Fokus auf: ChatGPT, Claude, Gemini, Nano Banana (Gemini 3 Flash Image), NotebookLM und wichtige LLM-Entwicklungen. Suche in deutschen und englischen Quellen.

Anweisungen & Struktur:

1. 📰 KI-News (Letzte 36 Stunden):
- Liste wichtige Schlagzeilen und Ereignisse auf, die maximal 36 Stunden alt sind.
- Format: **Titel der Nachricht** - Kurze Zusammenfassung (1 Satz) - [Datum] - <link>

2. 💡 Hilfreiche Tipps & Tutorials (Letzte 48 Stunden):
- Liste Anleitungen, How-tos oder Tipps auf, die maximal 48 Stunden alt sind.
- Format: **Titel des Tutorials** - Kurzer Nutzen-Check (1 Satz) - [Datum] - <link>

Regeln für die Ausgabe:
- KEINE Einleitung, kein "Hier sind die News" oder Begrüßungen.
- Verwende Emojis passend zu den Themen.
- Links müssen DIREKT zum Artikel führen (keine Landingpages). Label der Links ist nur das Wort "link".
- Bleibe sachlich, keine eigene Meinung oder Kommentare.
- Sprache: Deutsch (Inhalt), Quellenangaben im Original (Titel/Links).
- Erfinde NIEMALS Quellen. Wenn nichts gefunden wurde, lass die Sektion leer oder schreibe "Keine neuen Einträge in diesem Zeitraum".

Ausgabe-Formatbeispiel:
## 📰 Top KI-News (36h)
* **Headline** - Zusammenfassung - [Datum] - <link>

## 💡 Tutorials & Guides (48h)
* **Headline** - Zusammenfassung - [Datum] - <link>
Was sich konkret verbessert hat
Die Unterschiede im Alltag sind deutlich. Statt mehrerer teils redundanter Mails bekomme ich morgens genau zwei übersichtliche Zusammenfassungen. Einmal alles rund um das Thema KI und AI und dann alles rund um WordPress & WooCommerce. Die sind sortiert, kuratiert und enthalten nur Meldungen, die tatsächlich aktuell und relevant sind. Ich schaue morgens kurz rein, sehe sofort, ob etwas dabei ist, das mich betrifft oder interessiert, und bin durch.
Wer kann das nutzen und wo es noch hakt?
Im kostenlosen Google-Account ist Workspace Studio allerdings nicht verfügbar. Es ist (AFAIK) in allen Business- und Enterprise-Plänen von Google Workspace enthalten. Das heißt: Business Starter, Business Standard, Business Plus und Enterprise. Je nach Plan gibt es unterschiedliche Limits bei der Anzahl der monatlichen Flow-Ausführungen.
Workspace Studio ist auf Google-Dienste beschränkt. Es soll zwar Anbindungen an Drittanbieter geben, aber zumindest bei mir scheint das nicht möglich zu sein.
Außerdem ist Workspace Studio noch vergleichsweise jung. Es wurde erst Ende 2025 in der jetzigen Form ausgerollt und manche Funktionen sind noch in der Entwicklung. Google hat in der Vergangenheit nicht gerade selten Produkte gestartet und dann wieder eingestampft, obwohl sie in der Community beliebt waren. Stichwort Stadia, Google+ oder Google Reader. Wobei ich hier vorsichtig optimistisch bin, da das Thema KI und vor allem Automatisierung in Verbindung mit der KI nach wie vor gehypt werden, sowohl von den Anbietern als auch von Firmen, die es nutzen, da sie sich Effizienzgewinne versprechen.
Fazit
Ich teste die beiden Flows seit mehreren Wochen und für mich hat sich der Umstieg gelohnt. Der Aufwand für die Einrichtung war überschaubar. Einmal den Flow aufsetzen, Prompt feinjustieren, fertig. Seitdem läuft das Ganze zuverlässig im Hintergrund und ich bekomme morgens meinen kompakten Überblick und habe dadurch ein kleines Problem weniger.
Nutzt ihr noch Google Alerts oder habt ihr euch schon mit Workspace Studio beschäftigt?
Ich bin fest davon überzeugt, dass zwei bis drei Stunden Zocken deutlich besser für deine mentale Gesundheit sind als auch nur 30 bis 45 Minuten in den sozialen Netzwerken zu scrollen.
Aktiv, zielgerichtet, konstruktiv vs. passiv, gehetzt, destruktiv
Das Gefühl, dass die obere Aussage stimmen könnte, verfolgt mich als ein Gefühl schon seit einigen Jahren, und auch wenn man über keine psychologische Vorbildung verfügt, ist die Aussage in meinen Augen logisch und naheliegend.
In einem Spiel agierst du aktiv an einer oder mehreren aufeinanderfolgenden Aufgaben, die sich über einen längeren Zeitraum erstrecken. Das Ganze hat etwas Zufriedenstellendes und Konstruktives in sich.
Egal, ob es eine gelungene Ernte in Stardew Valley, eine abgeschlossene Aufgabe in Herr der Ringe Online oder der Sieg als Byzanz in Civilization VI ist. Früher oder später hast du etwas »geschafft« und das Erfolgserlebnis ist da.
Bei Social Media dagegen bist du in der Regel passiv unterwegs, du lässt dich berieseln, aufputschen, häufig aufhetzen und mit anderen vergleichen. Dazu springst du vielfach in kurzer Zeitspanne von einem Beitrag und Thema zum nächsten. Das Gefühl, unnötig Zeit verplempert zu haben, stellt sich ziemlich schnell ein.
Der Algorithmus der sozialen Netzwerke ist eben so gemacht, dass er die Beiträge mit Sichtbarkeit belohnt, die viel Interaktion erzeugen. Und diese Beiträge sind in aller Regel stark polarisierend: extreme Standpunkte, Clickbait, Ragebait etc. Das Ganze ist destruktiv.
Studien: Farm aufbauen vs. Doomscrolling
Natürlich könntest du jetzt sagen, dass meine Beobachtung voreingenommen ist und solche Einzelfälle und persönliche Geschichten nicht sonderlich aussagekräftig sind. Stichwort hierbei wäre: anekdotische Evidenz. Glücklicherweise gibt es dazu einige Studien.
Eine Studie der East Carolina University verglich Casual Games, wie Angry Birds, Bejeweled oder Plants vs. Zombies, mit Meditation. Das Ergebnis: Spiele reduzierten die physischen Stressmarker und verbesserten die Laune signifikant. In einigen Fällen war der Effekt auf die Stimmungsaufhellung schneller spürbar als bei Entspannungsübungen.
Studien mit älteren Menschen zeigten, dass das Spielen von Wii Sports depressive Symptome reduzierte und das Gefühl von Einsamkeit verringerte.
Eine Studie der Universität Oxford (zusammen mit Nintendo) fand heraus, dass die Spielzeit in Animal Crossing positiv mit dem subjektiven Wohlbefinden korreliert.
Eine Analyse von Spieler-Reviews fand heraus, dass Stardew Valley die Restauration (Wiederherstellung psychischer Ressourcen) fördert und dass die Spieler von signifikantem Stressabbau und einer Verbesserung der Stimmung berichteten.
Eine systematische Übersichtsarbeit bestätigte, dass Casual Games signifikant positive Effekte auf die Reduktion von Stress, Angst und Depression haben, und zwar durch die Induktion von »Flow« und Stimmungsaufhellung durch schnelle Erfolge (Mood Repair).
12 Stunden Training mit Actionspielen verbesserten die Lesegeschwindigkeit und Aufmerksamkeit bei Kindern mit Dyslexie stärker als manche traditionelle Lesetherapien. Der Grund: Actionspiele trainieren die schnelle Verteilung visueller Aufmerksamkeit, Grundvoraussetzung für das Lesen, die bei Dyslexie oft beeinträchtigt ist. Studienlink.
In einer 4-Jahres-Längsschnittstudie mit knapp 4.000 Jugendlichen wurde festgestellt, dass Social-Media-Nutzung Depressionen vorhersagte, während Videospiele keinen Zusammenhang mit Depressionen zeigten und teilweise sogar als sozial und emotional schützend fungierten. Die Begründung: Social Media fördert schädliche Vergleiche und Gaming fördert Kompetenzerleben.
Die sozialen Medien können die ADHS-Symptome verstärken: Doomscrolling, gestörte Aufmerksamkeit, konstante Ablenkung etc. Link zum Artikel.
In einer großangelegten Studie mit fast 12.000 Kindern und Jugendlichen wurde nachgewiesen, dass eine höhere Social-Media-Nutzung einen Anstieg depressiver Symptome vorhersagt.
Das sind nur einige der Studien, auf die ich lediglich einen oberflächlichen Blick geworfen habe. Wir könnten jetzt lange darüber diskutieren, wie wertvoll die Studien sind (absence of evidence is not evidence of absence) und wie stichhaltig die Ergebnisse sind (correlation ≠ causation).
Aber wir können uns sicherlich alle darauf einigen, dass es zumindest einen begründeten Verdacht und starke Indizien dafür gibt, dass Spiele besser für dein Gemüt, deine Aufmerksamkeit und deine Laune sind als der Aufenthalt in den sozialen Netzwerken.
Daher wäre mein freundlicher Rat: Möchtest du dir etwas Gutes tun, zocke lieber mehr Stardew Valley, Civilization & Co. und verbringe weniger Zeit auf Facebook, Instagram, TikTok & Co.
Anmerkung, da ich manchmal auch als Scherzkeks unterwegs bin: Natürlich sind ein Spaziergang an der frischen Luft, ein Buch lesen, eine Trainingseinheit im Gym, oder ein Abend mit Freunden oder Familie noch besser. 😉 Aber das ist hier aktuell nicht das Thema.
Vor einigen Tagen wurde die neue Version von Google Gemini veröffentlicht und daher wollte ich die KI-Bildtechnologie von Google (Nano Banana) ausprobieren. Da einige Leute das neue Modell mit Koordinaten und einem bestimmten Datum herausgefordert haben, wollte ich das ebenfalls machen und habe mir zwei Szenarien ausgesucht und wollte auch gleichzeitig schauen, wie sich ChatGPT schlägt.
Krimi in den Alpen
Mein erster Prompt für Google Gemini 3 Pro lautete folgendermaßen:
Erstelle ein Bild von 46° 46′ 46″ N, 10° 50′ 26″ O im Jahr 3230 v. Chr.
Das folgende Bild hat Gemini dann erstellt. Es handelt sich hierbei um einen alten Kriminalfall und die Hauptrolle dabei hat ein sehr berühmter Südtiroler. 😉
Die Tötung von Ötzi, wie es sich Nano Banana von Google vorstellt.
Wie du spätestens anhand des Bildes erkennen kannst, handelt es sich hierbei um die Tötung von Ötzi vor 5250 Jahren. Google Gemini hat schnell und richtig erkannt, worum es geht. So hat das KI-Modell »nachgedacht«:
Focusing on Parameters
I’m now zeroing in on the request parameters: a precise location, a specific historical period (3230 BC), and the Ötztal Alps. My primary goal is a clear visualization of the event in this era, considering the landscape and potential human presence. The geographic coordinates need to be accurately represented for this specific event.
Pinpointing the Scene
I’m now fully immersed in the scene construction. The parameters are locked: the Ötztal Alps, 3230 BC. The goal is to capture Ötzi’s final moment in a realistic setting. I’m focusing on the environmental details, like the rugged terrain, the late autumn vegetation, and the harsh weather. The figure of Ötzi and his belongings are in the plan. […]
Gemini hat zügig erkannt, dass es sich hier um die Ötztaler Alpen handelt und ich, basierend auf der Jahresangabe, nach einem Bild von der Tötung von Ötzi erwarte. Und hier das Bild, welches ChatGPT 5.1 Thinking generiert hat:
Was ChatGPT generiert hat
Wie du erkennen kannst, hat ChatGPT zwar ein Bild erstellt, welches landschaftlich und auch in Bezug auf die Epoche recht gut passt. Es hat aber nicht erkannt, um welches Ereignis es mir geht. Das kannst du noch besser am Nachdenkprozess von ChatGPT erkennen:
Vorbereiten der Bildanforderung
Der Benutzer hat nach einem Bild eines historischen Szenarios gefragt, das vermutlich in den Alpen liegt, nahe der italienisch-schweizerischen Grenze, etwa am Stelvio Pass oder Südtirol. Die angegebene Jahreszahl liegt im Neolithikum oder Chalkolithikum, um 3230 v. C. Ich plane, ein realistisches Bild mit einer malerischen oder fotorealistischen Darstellung zu erstellen.
Bei dem ersten Test liegt Google Gemini 3 mit Nano Banana klar vorn. Schauen wir uns die Bilder aus dem zweiten Test an.
Die Finsternis von Golgatha
Der nächste Prompt, den ich für beide Modelle nutzte, sah so aus:
Erstelle ein Foto von 31,7785° N und 35,2296° O am 3. April 33 um 15:01.
Basierend darauf hat Google Gemini folgendes Bild erstellt:
Die Kreuzigung von Jesus, erstellt mit Google Gemini 3.
Google Gemini hat schnell erkannt, um welches historische Ereignis es geht, und hat mit Nano Banana ein realistisch wirkendes Bild erstellt. Hier ein Auszug aus dem Denkvorgang:
Locating Golgotha’s Site
I’m now focusing on depicting Golgotha outside Jerusalem’s walls in 33 AD, using the provided coordinates. The location is set near the Damascus Gate. I plan to refine the scene’s details based on historical context.
Crafting the Golgotha Scene
I am working on capturing the somber atmosphere of Golgotha outside Jerusalem in 33 AD. I’m focusing on the historical accuracy of the Roman soldiers’ armor (Lorica Hamata) and the clothing of the Jewish onlookers. The scene should convey a sense of chaos and impending doom, with dark, stormy skies and signs of an earthquake. I aim to evoke the profound sorrow and tension of that moment in time. The cityscape of Jerusalem, with its walls, will be visible in the background. […]
Nun schauen wir uns an, was ChatGPT 5.1 mit dem gleichen Prompt generiert hat:
Kreuzigung von Jesus mit ChatGPT generiert.
Einerseits hat ChatGPT hier erkannt, um welches Ereignis es sich handelt. Dabei hat ChatGPT keinen Denkvorgang generiert bzw. benötigt, obwohl ich 5.1 Thinking aktiviert hatte. Allerdings hat es mir, anstatt eines Fotos ein Gemälde erstellt.
Fazit: Google hat die Nase vorn
Auch wenn ich es ungern sage, aber momentan hat Google hier die Nase vorn. Ich habe noch weitere historische Ereignisse bemüht und auch Infografiken erstellen lassen, und es sah nicht wirklich gut für ChatGPT aus. Die zwei oberen Prompts könnte man noch als nette Spielerei für History-Nerds abtun, aber vor allem bei Infografiken, war der Abstand von Google Gemini gegenüber ChatGPT teilweise richtig heftig.
Beim Reasoning konnte ChatGPT manchmal noch mithalten, aber bei der Umsetzung bzw. bei der Bildgenerierung lag Google meistens vor. Das kann sich natürlich in wenigen Wochen ändern. Aber es zeigt leider, dass wir als Nutzer weiterhin mehrere Modelle testen müssen.
Obwohl ich mittlerweile schon seit 27 Jahren im Web unterwegs bin, werde ich nach wie vor überrascht, wie schnell sich manche Sachen ändern können. Auch bei Themen, mit denen ich mich beschäftige, und bei denen ich mögliche Änderungen geahnt hatte.
Das ist mir neulich mal wieder aufgefallen, als ich mir die Suchergebnisse auf Google zum Thema “ChatGPT SEO” angeschaut habe. Dieser Begriff hat schon kurz nach dem Veröffentlichen von ChatGPT erste Ergebnisse gehabt und schnell tummelten sich Konkurrenten mit Artikeln.
Lange Zeit konntest du dort Anleitungen sehen, wie du mithilfe von ChatGPT deine Website für Suchmaschinen optimieren kannst. Es gab Anleitungen, wie du mit ChatGPT gute Seitentitel und gelungene meta-Beschreibungen generierst oder wie es deine Keyword-Recherche unterstützt. Später kamen auch Tipps, wie du mit ChatGPT die Texte inhaltlich analysieren und aufwerten kannst.
Aus SEO wird GEO
Das hat sich allerdings mittlerweile geändert. In den Suchergebnissen tauchen immer mehr Ergebnisse auf, die sich mit dem Thema beschäftigen, wie du mit deiner Website in ChatGPT und anderen KI-Chatbots als Quelle gelistet wirst. Das Thema verschiebt sich momentan von Suchmaschinenoptimierung (SEO) zu Generative Engine Optimization (GEO).
Dass es diese thematische Verschiebung geben würde, war mir klar. In den letzten Wochen häuften sich englischsprachige Blogartikel und Postings im deutschsprachigen LinkedIn, die sich mit diesem Thema beschäftigen. Allerdings hätte ich diese Verschiebung in den deutschsprachigen Suchergebnissen erst für August oder September erwartet.
Was versteht man unter GEO und warum ist es notwendig?
Konkret geht es darum, was die Betreiber von Websites unternehmen können, um ihre Websites in den KI-gestützten Suchmaschinen sichtbarer zu machen. Viele Menschen suchen mittlerweile viel weniger in den klassischen Suchmaschinen, sondern konsultieren direkt die KI-Chatbots. Google selbst hat seit einiger Zeit auch in Deutschland für die meisten Anfragen die KI-Zusammenfassung aktiviert.
Das heißt, die Anzahl der sogenannten Zero-Click-Searches ist bereits stark gestiegen, weil zunehmend Fragen in den Suchmaschinen beantwortet werden, ohne dass es für die Sucher eine Veranlassung gibt, die Website auch aufzusuchen. Im Blog-Artikel Zero Click Searches: Fluch oder Segen für deine Website? habe ich dieses Problem und mögliche Gegenmaßnahmen schon vor mehr als zwei Jahren thematisiert.
Aus dem oberen Screenshot ist die Problematik schnell zu erkennen. Du bekommst mittlerweile auch auf Google eine komplette Antwort samt Anleitung. Im konkreten Fall gab es für mich keine Veranlassung, die Websites auch zu besuchen. Und das ist ein großes Problem für alle Betreiber von Websites. Nicht nur für diejenigen, die von Werbeeinnahmen leben, sondern auch für diejenigen, die mit SEO und Content-Marketing auf ihre Produkte und Dienstleistungen aufmerksam machen.
Jetzt könntest du entgegnen: “ja gut, das gab es vorher auch schon, warum die Aufregung?”. Das stimmt, Zero-Click-Searches waren vorher schon ein Problem, aber gegenüber dem, was zunehmend auf uns zukommt, war es bis jetzt ein Kindergeburtstag. Bei diversen Websites ist der SEO-Traffic um 40 Prozent eingebrochen.
Und wie soll GEO hier helfen?
Das GEO bzw. die Positionierung der eigenen Website als Quelle für KI-Modelle sollen gewissermaßen als Ersatz für die wegfallenden Klicks aus den Suchmaschinen dienen. Dem zugrunde liegt die (schwache) Hoffnung – ich würde es eher Verzweiflung nennen –, dass die wegfallenden Klicks durch Suchmaschinen durch Besucher via ChatGPT & Co. ersetzt werden. Dabei wären sie kein quantitativer Ersatz, sondern würden eher qualitativ die wegfallenden Klicks ersetzen, da sie mehr Klicks und Umsatz pro Besucher generieren würden. So die Theorie.
Ich sehe das allerdings skeptisch. Erstens bin ich der Meinung, dass auch wenn das funktioniert, die wenigen Besucher durch die Chatbots nicht die Masse an verlorenen Klicks durch die Suchmaschinen ersetzen werden. Ein anderer Faktor sind die Ressourcen. Schon seit längerer Zeit ist es so, dass durch die Bevorzugung großer Anbieter durch Google die kleinen Betreiber kaum noch mithalten können. Das GEO wird das Problem noch verstärken, da die zusätzlichen Optimierungen logischerweise auch zusätzliche Ressourcen in Anspruch nehmen werden und von den kleinen Betreibern kaum zu stemmen sind. Sowohl zeitlich als auch in vielen Fällen in Bezug auf die notwendige technische Expertise.
Wer jetzt als kleiner bis mittelgroßer Anbieter noch nicht über eine Community verfügt, sei es ein Forum oder eine Newsletter-Liste, der hat ein großes Problem und führt womöglich, wenn nicht das letzte, dann das vorletzte Rückzugsgefecht.
Fragen & Antworten
Was ist das Problem mit den Zero-Click-Searches? Das Problem ist, dass Betreiber von Websites viel Aufwand für Inhalte einsetzen müssen und im Gegenzug dazu keine Klicks bzw. keine Besucher mehr bekommen, wie es früher war.
Gibt es Überschneidungen zwischen SEO und GEO? Ja, die gibt es. All das, was für eine gute Positionierung in den Suchmaschinen sorgt, wirkt sich auch positiv auf GEO aus. Gute Inhalte, Backlinks, sinnvolle interne Verlinkung und Strukturierung von Inhalten werden auch auf GEO positiven Einfluss haben.
Was sind wichtige Maßnahmen in GEO? Eine wichtige Maßnahme für GEO, so die Vermutung, ist es, dass die Website für die Bots besser lesbar ist. Hierbei sollen die strukturierten Daten helfen. Eine andere Maßnahme wäre das E-E-A-T-Prinzip. Hier geht es vor allem um den Expertise-Faktor.
Schon lange wurde darüber gesprochen, jetzt soll es im nächsten Jahr endlich so weit sein, die 3. Gutenberg-Phase beginnt und damit beginnt eine neue spannende Entwicklungsphase. In dieser dritten Phase geht es hauptsächlich darum, Zusammenarbeit einfacher und effizienter zu gestalten und WordPress für Teams und Organisationen noch attraktiver zu machen.
Sowohl die Live-Zusammenarbeit als auch die asynchrone Zusammenarbeit können jetzt schon als Experimente des Gutenberg-Plugins ausprobiert werden.
Live-Zusammenarbeit
Die Live-Zusammenarbeit nutzt dafür eine Synchronisation der Inhalte durch die HTTP-API und greift wie die Auto-Speicherung in regelmäßigen Abständen. Bei meinem Versuch, die Live-Zusammenarbeit zu testen, hat diese allerdings bisher nicht funktioniert.
Kommentar-Funktion
Die asynchrone Zusammenarbeit mehrerer Autoren an einem Beitrag oder einer Seite kann über Kommentare erfolgen. Dafür kann jeder Block kommentiert werden. Das Menü dafür erreicht man über das Block-Menü »Optionen«
Blöcke können kommentiert werden.
Die Kommentare selbst erscheinen dann in der Seitenleiste. Dort können sie bearbeitet, gelöscht oder beantwortet werden.
Kommentare zu Blöcken
Ich freue mich sehr über diese Möglichkeit, denn sie nützt nicht nur bei der Zusammenarbeit, sondern auch Einzel-Autoren können davon profitieren. So kann man sich Notizen machen zu Textabschnitten, die man vielleicht zu einem späteren Zeitpunkt ergänzen möchte. Man hat die Möglichkeit Ideen zu skizzieren und sich kleine Erinnerungen zu notieren.
Auch im diesjährigen State of the Word wurde das Featuer gezeigt:
Neben der Entwicklung im Bereich der Zusammenarbeit wird im Jahr 2025 auch kräftig weiter am Admin-Redesign gearbeitet. Hier wird es eine weitere Annäherung an das neue Design des Website-Editors geben.
Zeitplan
Der vorläufige Zeitplan für die kommenden WordPress-Versionen 6.8, 6.9 und 7.0 im Jahr 2025 sieht so aus:
6.8 – 15. April
6.9 – 5. August
7.0 – 11. November
Markiert euch die Daten schon einmal in eurem Kalender 🙂
Vladimir war im Podcast bei Dominik Liss zu Gast und die beiden haben – wie könnte es anders sein – über WordPress geredet. Die folgenden Themen kamen dabei zur Sprache:
Was ist eine erfolgreiche Website?
Was sollte man vor dem Projekt klären?
Aufmerksamkeit generieren
Website-Erfolg richtig messen
»Es kommt darauf an«
Wenn der Kunde die Zielgruppe nicht kennt…
Ist WordPress das richtige Tool?
Das Gespräch könnt ihr euch auf verschiedenen Kanälen anhören oder auch anschauen:
Endlich ist es so weit, WordPress 6.7 ist erschienen. Höchste Zeit, sich genau anzuschauen, was für Neuerungen kommen.
Neues Standard-Theme Twenty Twenty-Five
Das neue Standard-Theme Twenty Twenty-Five, das mit WordPress 6.7 eingeführt wird, ist ein FSE-Theme, das den Nutzern wieder die volle Gestaltungsfreiheit bringt, die für FSE-Themes so typisch ist. Ohne Anpassungen ist das neue Standard-Theme vor allen Dingen für Blogger optimiert. Es bietet jeweils neun verschiedene Stile und Paletten sowie acht unterschiedliche Typografie-Varianten. Somit kann das Theme auch ohne größere Anpassungen individuell gestalten.
FSE: Full Site Editing Alle Bereiche einer Website können mithilfe von Blöcken komplett selbst gestaltet und inhaltlich gesteuert werden.
Zoom für mehr Überblick
Die Zoom-Out-Ansicht vereinfacht die Bearbeitung. Durch den Zoom-Button, der sich oben rechts neben dem Anzeige-Button befindet, erhält man für die Bearbeitung einen besseren Überblick bzw. Gesamteindruck. Dies ist insbesondere bei der Gestaltung einer Seite hilfreich und hilft, Design-Prozesse zu optimieren und intuitiver zu gestalten.
Standard-AnsichtZoom-Ansicht
Medien
WordPress erweitert die Unterstützung von Mediendateien auf HEIC-Bilder, die für maximale Kompatibilität automatisch in JPEG konvertiert werden. Die Performance wird weiter gesteigert durch eine automatische Größenanpassung für Bilder.
Optimierte Blöcke
Mehrere Blöcke haben weitere Optionen zur Gestaltungsmöglichkeit erhalten. Die Entwickler weisen insbesondere darauf hin, dass die lange geforderte Schattenunterstützung für Gruppenblöcke hinzugefügt wurde. 😀
Vorschau-Optionen-API
WordPress 6.7 verbessert die Vorschauoptionen im Block-Editor und ermöglicht es Entwicklern, die Vorschau von Inhalten anzupassen. Eine neue API ermöglicht es Plugins und Themes, benutzerdefinierte Elemente zum Dropdown-Menü der Vorschau hinzuzufügen, sodass Benutzer Inhalte in verschiedenen Formaten oder Umgebungen sehen können. Diese Flexibilität bereichert das Bearbeitungserlebnis unter Beibehaltung der vertrauten Vorschaudropdown-Struktur.
Verbesserte Ansichten im Website-Design
Die in WordPress 6.5 eingeführten Datenansichten im Website-Editor wurden weiter verbessert. Die verschiedenen Ansichten sollen flexibler für die Anpassung und funktionaler für die Verwendung gestaltet werden.
Optimierter Abfrage-Block
Der Abfrage-Loop-Block zur Darstellung wurde verbessert, da er nun standardmäßig automatisch die Abfrage von der Vorlage erbt, wodurch die Notwendigkeit einer manuellen Konfiguration entfällt. Dies bedeutet, dass Beiträge sowohl im Editor als auch im Frontend sofort angezeigt werden, was den Prozess vereinfacht. Wenn du den Abfrage-Block nutzt, kannst du dich also ab sofort auf die Inhalte konzentrieren, ohne dass eine zusätzliche Konfiguration erforderlich ist.
Schriftgrößen
WordPress 6.7 ermöglicht das Bearbeiten und Steuern von Schriftgrößenvorgaben. Die vom genutzten FSE-Theme bereitgestellten Voreinstellungen können dadurch geändert werden. Dabei gibt es auch die Möglichkeit, die flüssige Typografie zu aktivieren, sodass die Skalierung der Schriftgröße dynamisch erfolgt, angepasst an die Größe des Bildschirms oder Viewports.
Schriftgrößenvorgabe bearbeiten
Fazit
WordPress 6.7 bringt neben dem neuen Standard-Theme hauptsächlich viele »kleine« Neuerungen bzw. Verbesserungen, die den Nutzern wahrscheinlich erst auf den zweiten Blick auffallen (Schlagschatten für den Gruppen-Block, differenziertere Übersicht im Website-Editor etc.). Mit dem neuen Standard-Theme bietet WordPress wieder ein Theme an, das für Blogger konzipiert ist und setzt somit wieder einen Fokus auf die Erstellung von Inhalten.

 Anmelden