Große Sprachmodelle, die sogenannten Large Language Models (LLMs), sind durch Anwendungen wie ChatGPT, Claude und Gemini in kurzer Zeit bekannt geworden. Die genannten Modelle sind kommerziell und bergen sowohl ethische als auch rechtliche Probleme, insbesondere bei Fragen des Datenschutzes und des Urheberrechts. Eine Anwendung dieser Modelle im schulischen Kontext kann daher herausfordernd sein. Eine Alternative sind so genannte offene LLMs. Die Offenheit der einzelnen Modelle unterscheidet sich jedoch deutlich.
Open Source Fuck Yeah. Bild: Kirsten Comandich via flickr.com , CC BY-SA 2.0; Sternchen hinzugefügt von Angela Karnoll
Ein Beitrag von Jens Crueger
Was bedeutet Offenheit bei LLMs?
LLMs bestehen aus drei Kernbestandteilen, die für eine Freigabe unter offener Lizenz infrage kommen:
Der Code, der die Modellarchitektur und den Code für Training, Konfiguration und Inferenz enthält,
die Trainingsdaten, die dem Modell Wissen über die Welt vermitteln,
die Modellgewichte (Weights), dies sind die im Training erlernten Parameter der Informationsverarbeitung, also der Gewichtung und Verknüpfung von Informationen.
Hinsichtlich der Offenheit von LLMs ist daher die entscheidende Frage, welche dieser Elemente frei zugänglich und nutzbar sind, und welche verwehrt bleiben. Grundsätzlich lassen sich zwei Typen von offenen LLMs unterscheiden: Open Weight LLMs und Open Source LLMs.
Nur begrenzte Offenheit bei Open Weight LLMs
Bei Open Weight Modellen sind die im Training erarbeiteten Modellgewichte und damit ihre erlernte Gewichtung und Verknüpfung von Informationen öffentlich zugänglich. Dadurch wird es für Dritte möglich, das Modell auf ihrem Rechner auszuführen, seine Funktionsweise zu untersuchen, und es für eigene Bedarfe anzupassen.
Allerdings werden bei Open Weight Modellen nicht sämtliche Elemente öffentlich gemacht. Insbesondere der für das Training verwendete Code und der Korpus an Trainingsdaten bleiben dem freien Zugriff und der Einsicht verwehrt.
Der fehlende Zugriff auf die Trainingsdaten bedeutet urheberrechtliche und ethische Risiken sowie Sicherheitsgefahren, beispielsweise im Hinblick auf technische Hintertüren der Systeme. Open Weight LLMs sind daher bei der Suche nach offenen LLMs für den Bildungsbereich nicht zu empfehlen.
Komplette Offenheit bei Open Source LLMs?
Open Source LLMs stellen neben ihren Modellgewichten sowohl ihren Code als auch die Trainingsdaten öffentlich. Die Open Source Initiative hat 2024 die Open Source AI Definition 1.0 veröffentlicht, in der die Voraussetzungen einer Open Source LLM weiter aufgeschlüsselt werden.
Unter den aktuell verfügbaren weit über 100 Open Source LLMs gibt es im Detail weitere Abstufungen der Offenheit. Die Linux Foundation hat deshalb mit dem Model Openness Framework (MOF) eine Einteilung in die drei Stufen Open Model, Open Tooling Model und Open Science Model vorgeschlagen. Auf Basis dieses Framework ordnet die Website isitopen.ai rund 80 Modelle ein.
Anwendungen im Bildungskontext
Die Ständige Wissenschaftliche Kommission der Kultusministerkonferenz (SWK) hat 2024 in einem Impulspapier zu Large Language Models und ihren Potenzialen im Bildungssystem dafür plädiert, die LLMs „in geeignete Lernplattformen zu integrieren oder Commons-Alternativen zu entwickeln“ (S.21).
Im Rahmen des bundesländerübergreifenden Projektes AIS (Adaptives Intelligentes System) wird seit November 2024 ein Open Source LLM für den Einsatz im Unterricht entwickelt. Der Chatbot dieses LLMs nennt sich „AIS.chat“. Dieses Angebot ist kostenfrei und soll alle rechtlichen Anforderungen, insbesondere im Hinblick auf den Datenschutz, erfüllen.
Manche Lehrkräfte und Schulen hegen jedoch den Wunsch nach einem LLM, das ohne einen externen Anbieter (sei es ein kommerzieller oder ein staatlicher) auskommt. Open Source-Modelle, die als lokale Systeme auf einem schuleigenen Rechner laufen, können eine Alternative sein (vgl. dazu https://linux-bildung.at/2025/05/lokale-ki-auf-eigenem-server/) und benötigen noch nicht mal eine stehende Internetverbindung. Initiativen zu eigenen Open Source-KI-Umgebungen sind an Hochschulen bereits öfter zu finden, beispielsweise an der Universität Paderborn.
Offenheit und Lokalität als Themen der Zukunft
Sowohl die Entwicklung von KI-Modellen als auch die Implementierung von KI in den Unterricht bewegen sich derzeit rasant voran. Die Relevanz, die Open Source-Anwendungen dabei entfalten können, ist aufgrund der rechtlichen und ethischen Probleme großer Tech-Konzerne und ihrer kommerziellen Modelle hoch. Lokale Open Source-Modelle kommen dem Ideal von Souveränität über Technologie und Daten sehr nahe. Initiativen wie OSOS (Open Source Open Schools) können für Lehrkräfte ein Anlaufpunkt sein, die sich für lokale KI-Modelle an Schulen interessieren.
Deutschland forscht seit Jahren an Künstlicher Intelligenz, bei der wirtschaftlichen Nutzung und dem Aufbau eigener KI-Technologien spielen jedoch vor allem Unternehmen aus den USA und China die führende Rolle. Das will Bundeskanzler Friedrich Merz ändern. Auf dem Digitalgipfel der Bundesregierung…
Ausführen lassen ja, urteilen lassen nein? Eine Einzel- und eine Doppelstunde ab Klasse 8 zeigen, wo beim Delegieren an KI die Grenze verläuft.
„Schreib mir eine Entschuldigung an Mira, ich hab ihren Geburtstag vergessen.“ Sätze wie diesen tippen Jugendliche heute ganz selbstverständlich in ein Chatfenster, und die Antwort kommt in Sekunden, sauber formuliert, freundlich, ohne einen einzigen Fehler. Ob das ein Problem ist, lässt sich mit Ja oder Nein kaum beantworten. Spannender ist eine andere Frage, und um die geht es in diesem Beitrag: Was gebe ich eigentlich ab, wenn ich etwas an KI delegiere – nur die Arbeit oder auch mein Urteil?
Kurz vorweg, worauf das hinausläuft. Ich stelle euch eine Einzelstunde ab Klasse 8 und eine darauf aufbauende Doppelstunde für die Klassen 9 und 10 vor. Beide kommen ohne Tablets, Konten und Datenschutzfragen aus, weil die Lernenden die Delegation an eine KI selbst durchspielen. Am Ende haben eure Schülerinnen und Schüler drei Prüffragen in der Hand, mit denen sie unterscheiden können, wann sie eine Aufgabe guten Gewissens abgeben dürfen und wann sie selbst urteilen müssen.
Ausführen, entscheiden, verantworten: worum es beim Delegieren an KI geht
Im Ethikunterricht behandeln wir KI häufig als Gegenstand, über den wir urteilen. Wir fragen, ob ein Algorithmus gerecht entscheidet oder ob ein autonomes Fahrzeug Leben gegeneinander abwägen darf (hier im Blog findet ihr einen Unterrichtsvorschlag dazu für die Oberstufe). Für Jugendliche in der Mittelstufe liegt die Frage meist sehr viel näher am eigenen Alltag. Sie wollen wissen, ob sie die Gliederung fürs Referat, die Bewerbung fürs Praktikum oder die Nachricht an die Freundin, mit der sie sich gestritten haben, einer KI überlassen dürfen.
Hilfreich ist dabei eine Unterscheidung, die sich im Unterricht gut einführen lässt. Wer eine Aufgabe delegiert, kann damit drei ganz verschiedene Dinge abgeben. Da ist zum einen die Ausführung, also das bloße Tun. Sie abzugeben ist meist unproblematisch, solange ich das Ergebnis prüfen kann.
Dann gibt es Entscheidungen, die in der Ausführung stecken und die eine KI oft stillschweigend trifft, ohne dass ich es bemerke. Schwierig wird es dort, wo eine solche Entscheidung eigentlich ein Urteil über Werte oder über andere Menschen ist.
Und schließlich die Verantwortung, die sich überhaupt nicht abgeben lässt. Unter einer Entschuldigung, einer Stellungnahme oder einer Bewertung steht am Ende mein Name und nicht der eines Programms.
Daraus ergeben sich drei Prüffragen, die eure Lernenden auf jede Delegation anwenden können:
Kann ich das Ergebnis selbst prüfen?
Trifft die KI dabei eine Entscheidung über Werte oder über andere Menschen?
Kann ich für das Ergebnis geradestehen, auch wenn ich nicht weiß, wie es zustande kam?
Lautet die Antwort auf die erste und die dritte Frage Ja und auf die zweite Nein, spricht wenig dagegen, die Aufgabe abzugeben. Bei jeder anderen Kombination lohnt es sich, genauer hinzusehen und den Auftrag so umzuformulieren, dass das Urteil bei mir bleibt.
Woher die Idee kommt: Delegieren lernen bei den Future Makers
An meiner Schule entwickeln Schülerinnen und Schüler in den Future Makers Lösungen für reale Probleme, von der ersten Idee bis zum funktionierenden Prototyp.
Generative KI ist dabei ein wichtiges Werkzeug, eigene Konten haben die Lernenden aber nicht. Sie formulieren jeden Auftrag selbst, ich führe ihn über meinen Zugang aus, und danach entscheidet die Gruppe, was sie übernimmt, verändert oder verwirft. Das löst nebenbei die Datenschutzfrage.
Im ersten Durchlauf mit 28 Jugendlichen über sechs Doppelstunden hat sich aber gezeigt, dass gerade dieser Umweg das eigentlich Lehrreiche ist. Wer einen Auftrag laut formulieren und vor der Gruppe begründen muss, merkt schnell, dass schon die Formulierung eine Entscheidung ist. Und wer sieht, was zurückkommt, fragt fast von selbst, wer hier gerade eigentlich entschieden hat.
Genau diese Erfahrung holen die beiden Stunden in den Ethik- und Religionsunterricht, und ihr braucht dafür keinerlei Technik. Die benötigten Kopiervorlagen findet ihr am Ende des Beitrags zum kostenlosen Download.
Einzelstunde ab Klasse 8: Die wörtliche Maschine
Einstieg (ca. 5 Minuten)
Kündigt an, dass ihr für fünf Minuten eine Maschine seid, die jeden Auftrag sofort und wörtlich ausführt, und lasst euch von der Klasse etwas auftragen. Schon bei „Schreiben Sie das Datum an die Tafel“ müsst ihr euch entscheiden, ob ihr „1.10.“, „Donnerstag, 1. Oktober 2026“ oder etwas ganz anderes schreibt. Die Lernenden sehen sofort, dass eine Maschine jede Lücke im Auftrag mit einer eigenen Entscheidung füllt. Hier ist das harmlos, aber es bereitet die Frage der Stunde vor.
Erarbeitung (ca. 20 Minuten)
Die Lernenden arbeiten zu zweit mit KV 1. Eine Person erhält Teil A und ist Auftraggeberin oder Auftraggeber, die andere erhält Teil B und spielt die KI. Die Maschine darf nur mit den vorbereiteten Antworten reagieren, nichts erklären und nicht nachfragen. Die drei Aufträge sind so gebaut, dass der Anteil an Urteil Schritt für Schritt wächst. Beim ersten Auftrag sortiert die Maschine fünf Wörter alphabetisch, was sich sofort überprüfen lässt. Beim zweiten schreibt sie eine Entschuldigung an die Freundin Mira, die schöner klingt als vieles, was Jugendliche selbst schreiben würden, aber eben nicht von ihnen ist. Beim dritten vergibt sie einen freien Platz in der Theater-AG und begründet ihre Wahl damit, dass Elifs Bewerbung fast doppelt so viele Wörter hat wie die von Jonas. Dieses Kriterium bemerken viele erst, wenn sie die Begründung ein zweites Mal hören, und genau darin liegt der Lerneffekt. Anschließend halten beide in einer Tabelle fest, was die Maschine getan und was sie dabei für sie entschieden hat, und ob sie das Ergebnis mit ihrem Namen unterschreiben würden.
Auswertung (ca. 20 Minuten)
Zeichnet an der Tafel eine Linie von „kann ich abgeben“ bis „muss ich selbst entscheiden“. Die Paare ordnen die drei Aufträge darauf ein und begründen ihre Position. Zu erwarten sind Sätze wie „Die Entschuldigung klang schöner als meine eigene, aber Mira hätte gemerkt, dass das nicht ich bin, und dann ist es keine Entschuldigung mehr“ oder „Die Maschine hat Elif genommen, weil ihr Text länger war. Das hätte ich nie als Grund genommen.“ Solche Äußerungen sammelt ihr im Tafelbild (KV 2) unter den Begriffen Ausführen, Entscheiden und Verantworten. Als Hausaufgabe notieren die Lernenden eine Situation aus ihrer Woche, in der sie etwas abgegeben haben, an einen Menschen oder an eine App, und was sie dabei eigentlich mit abgegeben haben.
Doppelstunde für Klasse 9 und 10: Delegieren mit drei Prüffragen
Einstieg (ca. 10 Minuten)
Einige Lernende stellen ihre Situation aus der Hausaufgabe vor (siehe Vorschlag für eine Einzelstunde). Daran knüpft der kurze Informationstext auf KV 2 an, der die Unterscheidung von Ausführen, Entscheiden und Verantworten einführt und die drei Prüffragen bündelt. Wenn ihr ohne die Einzelstunde startet, könnt ihr den Einstieg mit der wörtlichen Maschine auch hier verwenden.
Erarbeitung I (ca. 30 Minuten)
KV 3 enthält sechs Fälle aus dem Alltag Jugendlicher. Noah lässt sich eine Referatsgliederung vorschlagen, Lea bittet um eine Beileidsnachricht für ihre Freundin, Amira will einen Streit im Klassenchat von einer KI entscheiden lassen, Ben stellt als Co-Trainer die Fußballmannschaft nach Statistik auf, Mia lässt ihren Mathe-Lösungsweg prüfen, und eine Lehrkraft überlegt, Aufsätze von einer KI benoten zu lassen. Die Lernenden prüfen jeden Fall mit den drei Fragen. Der wichtigere Teil folgt danach: Für zwei Fälle, bei denen sie Bedenken haben, formulieren sie den Auftrag an die KI so um, dass das Urteil bei der Person bleibt. Aus „Schreib eine Beileidsnachricht an meine Freundin“ wird dann etwa „Ich möchte Sophie schreiben, dass ich an sie denke. An ihren Opa erinnere ich mich so: Er hat uns nach dem Training immer Kakao gemacht. Hilf mir, das in zwei, drei Sätze zu bringen.“ Hier zeigt sich, dass KI-Kompetenz weniger mit geschickten Prompts zu tun hat als mit der Frage, was ich gar nicht erst aus der Hand gebe. Der Fall der Lehrkraft dürfte für die lebhafteste Diskussion sorgen, weil die Lernenden hier selbst diejenigen sind, über die geurteilt wird. Eine Lösung mit möglichen Antworten liegt bei.
Erarbeitung II (ca. 30 Minuten)
Mit KV 4 wird die Klasse selbst zur Auftraggeberin, so wie die Gruppen bei den Future Makers. Die SMV (=Schülermitverantwortung) möchte eine neue Regel zur Handynutzung in den Pausen vorschlagen, und die Klasse soll dafür eine KI nutzen. Die Lernenden formulieren gemeinsam einen Auftrag und untersuchen dann drei vorbereitete Vorschläge der Maschine, ein striktes Verbot, eine völlige Freigabe und eine differenzierte Lösung. In jedem Vorschlag steckt eine Abwägung, etwa zwischen Schutz vor Cybermobbing und der Freiheit der Schülerinnen und Schüler, die die KI ungefragt vorgenommen hat. In einem Entscheidungsprotokoll halten die Gruppen fest, was sie übernehmen, verändern oder verwerfen, und warum. Wenn eure Schule ein datenschutzkonformes KI-Werkzeug zur Verfügung stellt, könnt ihr den Auftrag der Klasse auch live über euren eigenen Zugang am Beamer ausführen. Die Lernenden brauchen dafür keine Konten, und ihr arbeitet genau so, wie es bei den Future Makers geschieht.
Sicherung (ca. 20 Minuten)
Zum Abschluss schreiben die Gruppen eine Delegationserklärung. Sie halten darin fest, was sie der KI überlassen haben, was sie selbst entschieden haben und wofür sie mit ihrem Namen einstehen. Unterschreiben darf nur, wer dem Ergebnis zustimmt und es erklären kann. Gerade dieser letzte Schritt wirkt oft stärker als jede Diskussion, denn mit der Unterschrift wird Verantwortung plötzlich greifbar. Im Tafelbild ergänzt ihr den Merksatz: Die Ausführung darf ich abgeben, wenn ich das Ergebnis prüfen kann. Ein Urteil über Werte oder über andere Menschen treffe ich selbst, denn geradestehen muss am Ende ich und nicht die KI.
Die Materialien sind so angelegt, dass ihr sie im Ethik- wie im Religionsunterricht einsetzen könnt. Im Religionsunterricht lässt sich die Frage nach der nicht delegierbaren Verantwortung gut mit dem Gewissen verbinden, das sich gerade nicht vertreten lässt. Auch biblisch ist der Mensch einer, der angesprochen und gefragt wird. Kains ausweichende Antwort auf die Frage nach seinem Bruder, „Soll ich meines Bruders Hüter sein?“ (Gen 4,9, Lutherbibel 2017), ist ein starker Impuls, um mit der Klasse darüber nachzudenken, was es heißt, Verantwortung von sich wegzuschieben. Weitere Ideen, wie ihr KI im Religionsunterricht aufgreifen könnt, findet ihr in diesem Beitrag.
Fazit
Die Frage, ob Jugendliche KI nutzen sollen, hat der Alltag längst beantwortet. Offen ist, ob sie dabei merken, was sie mit abgeben. Wer einmal die wörtliche Maschine gespielt hat, schaut genauer hin, und darum geht es mir. Ich wünsche euch spannende Diskussionen und bin gespannt, welche Fälle eure Lernenden selbst mitbringen.
Arbeitsspeicher ist teuer, die Nachfrage aus der KI-Branche hoch und die Versorgung angespannt. Ausgerechnet OpenAI-Chef Sam Altman hat nun eine bemerkenswerte Vorstellung davon geäußert, wo die knappen DRAM-Ressourcen am besten aufgehoben wären: möglichst nicht ungenutzt in privaten Computern. In einem…
Der Europäische Datenschutzbeauftragte fordert schärfere Grenzen für einen Austausch von heiklen Polizeidaten mit US-Behörden. Die Bundesregierung hält ihre Verhandlungen dazu sogar im Parlament geheim.
Die US-Regierung will vor allem Zugriff auf Daten von Reisenden. (Symbolbild) – Alle Rechte vorbehalten: IMAGO/ Marc Bremer; Bearbeitung: netzpolitik.org
Der Europäische Datenschutzbeauftragte (EDSB) Wojciech Wiewiórowski hat das geplante Rahmenabkommen zwischen der EU und den USA zum lesenden Zugriff auf nationale Polizeidatenbanken scharf kritisiert. In einer am 27. Oktober veröffentlichten Stellungnahme verlangt die Aufsichtsbehörde klare Grenzen für den geplanten Datenaustausch und warnt vor einer massenhaften Übermittlung biometrischer Daten.
Den Abschluss einer solchen „Enhanced Border Security Partnership“ hat die US-Regierung zur neuen Bedingung für das Visa-Waiver-Programm (VWP) gemacht. An diesem Programm nehmen mehr als 40 Länder teil, deren Bürger*innen deshalb bis zu 90 Tage ohne Visum in die USA einreisen dürfen; diese Vereinbarung gilt gegenseitig. Wer sich der neuen „Grenzpartnerschaft“ verweigert, riskiert den Ausschluss aus dem VWP. Die Frist für das Rahmenabkommen läuft bis Ende 2026. Anschließend müssen einzelne Regierungen – auch Deutschlands – ein konkretisierendes Umsetzungsabkommen abschließen.
Ein Entwurf für den heiklen Datendeal wurde inzwischen ausgehandelt. Am 10. September hat die Europäische Kommission einen unterzeichnungsreifen Entwurf veröffentlicht, er liegt inzwischen samt Annex auch auf Deutsch vor. Wegen der von den USA diktierten Frist ist ein zweigleisiges Verfahren vorgesehen: Nachdem das Rahmenabkommen von den EU-Staaten und der US-Regierung unterzeichnet wurde, soll es sofort vorläufig angewendet werden. Die demokratische Legitimation mit Zustimmung des Europäischen Parlaments soll dann nachgeholt werden, dafür gibt es einen inhaltsgleichen Entwurf.
Anlässe für Abfragen sind vage
Gegenüber einem früheren Entwurf enthält die finale Version Änderungen. Eine US-Abfrage in europäischen Datenbanken soll demnach nur mit alphanumerischen Personendaten oder Fingerabdrücken möglich sein, nicht mehr mit einem Gesichtsbild. Die anschließende Antwort an die US-Behörden kann dann auch biometrische Lichtbilder enthalten.
Nach Angaben der US-Seite soll der Datenzugriff vor allem der Identitätsüberprüfung und dem Sicherheitsscreening von Reisenden bei Grenzverfahren und Visaanträgen dienen. Das Abkommen erlaubt Suchläufe, wenn ein „Grund zu der Annahme“ besteht, dass die Einreise oder der Aufenthalt einer Person eine „ernsthafte und tatsächliche Gefahr für die öffentliche Sicherheit oder die öffentliche Ordnung“ darstellt. Wiewiórowski dringt darauf, diesen Begriff eng auszulegen. „Öffentliche Ordnung“ sei im EU-Recht nicht einheitlich definiert und könne sowohl Straftaten als auch Ordnungswidrigkeiten umfassen.
Die weite Fassung der Zwecke im derzeitigen Entwurf gewährt den USA außerdem Zugriff zur Verfolgung schwerer Kriminalität und terroristischer Straftaten. Auch wenn die „Grenzpartnerschaft“ nicht direkt darauf zielt, wäre in diesem Rahmen die Ausforschung linker Bewegungen in Deutschland möglich: der US-Präsident und seine Regierung haben letztes Jahr unter anderem die deutsche „Antifa Ost“ und ihre angeblichen Mitglieder oder Unterstützer*innen als „Foreign Terrorist Organization“ eingestuft und treiben die Verfolgung linker Gruppen seitdem weltweit voran.
Keine unabhängige Aufsicht
Dass die Befürchtung einer politischen Verfolgung mithilfe der „Grenzpartnerschaft“ nicht weit hergeholt ist, zeigt sich auch in der Formulierung von „Trendanalysen“ verdächtiger Aktivitäten, aufgrund derer eine US-Abfrage in deutschen Polizeidaten erfolgen dürfte. Der EDSB sieht darin eine Gefahr von Rasterfahndungen anhand von Verhaltensmustern. Diese könnten zu Profilbildung und einer ungerechtfertigter Ungleichbehandlung führen, so Wiewiórowski.
Für den ersten automatisierten Abgleich, bei dem auch Fingerabdrücke übermittelt werden, verlangt der EDSB mehr Transparenz. Die anfragende Behörde solle zumindest angeben, worauf sich der Verdacht bezieht. Zudem soll der Zugriff ausschließlich auf nationale Datenbanken einzelner Staaten beschränkt bleiben. Darin sind häufig auch Datenbestände aus großen EU-Plattformen wie dem Schengener Informationssystem (SIS), dem Visa-Informationssystem (VIS) oder dem Europäischen Reiseinformations- und ‑genehmigungssystem (ETIAS) übernommen. Eine indirekte Weitergabe dieser Daten aus EU-Systemen an US-Behörden müsse ausgeschlossen werden, fordert Wiewiórowski.
Der EDSB bemängelt zudem eine Schwachstelle, auf die auch schon der Datenschutzaktivist Max Schrems gegenüber netzpolitik.org verwiesen hatte: Zwar sehe der Entwurf des Rahmenabkommens vor, dass die Staaten mit den USA gegenseitig unabhängige Aufsichtsstellen benennen. Für die USA bleibe aber unklar, welche Behörden diese Aufgabe übernehmen sollen. Denn in den USA existieren keine behördenunabhängige Stellen, wie sie in der EU üblich sind. Die EU-Kommission gibt sich in dem Abkommen offenbar mit internen Stellen der US-Einwanderungsbehörden zufrieden.
Bundesregierung schweigt zu Verhandlungen
Wiewiórowski weist außerdem darauf hin, dass allein das Vorhandensein von Daten in irgendeiner europäischen Polizeidatei nicht als Anhaltspunkt für weitere Maßnahmen gelten darf. Denn dort sind häufig nicht nur Beschuldigte, sondern auch Zeug*innen und Opfer gespeichert. So ist es auch beim deutschen Informationssystem der Polizei (INPOL) der Fall. Diese beim Bundeskriminalamt für alle Bundesländer geführte Datei wird vermutlich im deutsch-amerikanischen Umsetzungsabkommen für die „Grenzpartnerschaft“ geöffnet.
–––
Die Arbeit von netzpolitik.org finanziert sich aus den Spenden unserer Leser:innen. Unterstütze auch du unseren gemeinwohlorientierten, werbe- und trackingfreien Journalismus. Spende jetzt..
–––
Für das bilaterale Umsetzungsabkommen ist auf deutscher Seite das Bundesinnenministerium zuständig. Wie es sich angesichts des Zeitdrucks auf die noch dieses Jahr abzuschließenden Verhandlungen vorbereitet, will die von Alexander Dobrindt (CSU) geführte Behörde nicht sagen. Auf eine Presseanfrage antwortete das Ministerium lediglich, die Regierung ergreife derzeit alle erforderlichen Schritte.
Das Auswärtige Amt unter Johann Wadephul (CDU), das spätestens zur Unterzeichnung eines final entworfenen Umsetzungsabkommens eingebunden werden müsste, wollte inhaltlich gar nicht antworten. Auch eine parlamentarische Anfrage der Abgeordneten Clara Bünger (Die Linke) wurde mit Verweis auf den „Kernbereich exekutiver Eigenverantwortung“ nicht beantwortet.
–––
Deine Spende für digitale Freiheitsrechte Wir berichten über aktuelle netzpolitische Entwicklungen, decken Skandale auf und stoßen Debatten an. Dabei sind wir vollkommen unabhängig. Denn unser Kampf für digitale Freiheitsrechte finanziert sich aus den Spenden unserer Leser:innen. Jetzt spenden.
Artificial intelligence can support creators in producing OERs to varying degrees. This often results in what are known as “mixed materials.” These are materials that either consist of a combination of AI-generated and human-created elements or of content created through collaboration between AI and humans. Depending on the nature of the mixed material, there are various aspects to consider regarding licensability and the attribution of the AI service.
What is mixed content?
When it comes to mixed materials, a distinction must be made between content with separable elements and content with a main element created using two methods:
For example, if an author writes text for an online article and adds an AI-generated cover image to it, the combination of text and image constitutes mixed material, with the image and text being two separable elements.
If the author has part of the text generated by AI and writes part of it herself, the text constitutes a primary element created using two different methods.
When does an AI-generated work become subject to copyright?
Since copyright protection – and thus also licensing under CC BY – requires a personal intellectual creation, AI-generated materials are not eligible for protection or licensing due to the absence of human creation. AI output is therefore, by its very nature, in the public domain or “open.”
Prompt versus Personal Intellectual Creation AI outputs are generated by entering a command, known as a prompt. A personal intellectual creation requires that a person shape a work through their own creative, individual decisions. Since a prompt is to be understood as a command for a technical system and is purely instructive, it does not meet the requirement for a personal intellectual creation.
In practice, the output is often refined further after the prompt is issued. In such cases, the prompt may be eligible for copyright protection if the creator’s creative contribution is more prominent than the AI-generated content.
Read more here.
How do I license mixed content?
The rules vary depending on whether the content consists of separable or inseparable elements.
1. Content with separable elements
Since AI-generated content is, by its nature, in the public domain, it should be marked with a Public Domain Mark. The self-created, copyright-protected content can be licensed. To ensure the content can be used as OER, we recommend licensing it under the CC BY 4.0 license. If the mixed material is to be licensed uniformly, the CC0 license is recommended. Since this license releases the licensed content into the public domain, it is also suitable for marking content that is in the public domain from the outset. More details here.
2. Content with a Primary Element
For content consisting of a primary element, created through a combination of AI generation and personal creation, and where the primary focus of creation lies in personal creation, the content as a whole can be licensed under a license such as the CC BY 4.0 license. If the emphasis is on AI generation, the content as a whole must be marked as in the public domain. In both cases, a CC0 license can also be used here.
How do I make AI components transparent?
In the context of the AI Regulation, the European Commission recently published a Code of Conduct for the Labeling of AI Content. This guide also includes proposals for AI labeling symbols, which are described in more detail here. Even those who create individual OER materials can derive guidance for AI labeling from this. In general, when creating OER materials using AI, it is recommended to name the AI service used. In addition, creators should specify exactly what the AI was used for and provide a general description of the prompt. For materials with separable components, the label should be placed as close to the AI-generated content as possible (in the case of a text-image example, directly below the image). For materials with a single main element, the label can be placed below the content.
Note: This post was originally published as part of a collaboration between iRights.info , the German Education Server, and OERinfo. The text was written by Lea Singson, is licensed under CC BY 4.0 , and was originally published on OERinfo.
This text was translated with the help of deepL and reviewed by the author.
Would you like to support iRights.info?
iRights.info provides information and explanations on the subject of “Copyright and creativity in the digital world”. All texts are published free of charge and openly licensed.
If you like, you can support us via the donation platform Betterplace and receive a donation receip. Betterplace accepts PayPal, direct debit, credit card, paydirekt or bank transfer.
We would be particularly pleased to receive a regular contribution, for example as a monthly standing order. The non-profit organization iRights e.V. would like to thank you for your support!
Künstliche Intelligenz verändert unsere Welt rasant – und sorgt zugleich für wachsende Unruhe. Fachleute warnen vor Jobverlust, Kontrollverlust über autonome Systeme und sogar vor einer künftigen „Superintelligenz“. Während die EU mit dem AI Act strengere Regeln einführt, setzen andere Staaten eher auf Selbstverpflichtungen der Konzerne. Doch reicht das aus?
Wie viel Freiheit darf Künstliche Intelligenz haben – und ab wann braucht es strengere Regeln? Die Debatte darum, wie gefährlich KI ist, wird immer intensiver geführt. Selbst führende KI-Unternehmer warnen davor, dass sich KI-Systeme bald verselbstständigen könnten, und fordern eine verlangsamte Weiterentwicklung. Könnte sogar die Menschheit gefährdet sein?
Die Europäische Union reagiert mit der KI-Verordnung, einem umfassenden Gesetzespaket, das die Sicherheit und den verantwortungsvollen Einsatz von KI garantieren soll. Kritiker befürchten jedoch, dass strenge Vorschriften Innovationen ausbremsen und Europa im Wettbewerb mit den USA und China zurückfallen lassen. Dort setzt man stärker auf freiwillige Selbstkontrolle der großen Tech-Konzerne. Doch reicht das aus? Oder braucht es eine internationale Kontrolle – ähnlich wie bei Atomwaffen –, bevor Risiken entstehen, die niemand mehr beherrscht?
Mit der Debatte des Monats und unserem kostenlosen Arbeitsblatt können eure Schülerinnen und Schüler verschiedene Argumente zu diesem topaktuellen Thema gegeneinander abwägen und sich selbst positionieren.
Claude ist ein Sprachmodell des US-Unternehmens Anthropic und kann im Browser, als Desktop-App und am Smartphone genutzt werden. Neben dem klassischen Chat bietet Claude eine Reihe von Funktionen, die ineinandergreifen: Recherchen mit Quellenangaben, die Arbeit mit Dateien auf dem eigenen Computer, interaktive Lernspiele, Präsentationen sowie Aufgaben, die regelmäßig von selbst erledigt werden. Im Screencast begleiten wir die Englischlehrerin Frau Hofer eine Woche lang bei der Vorbereitung einer Unterrichtsreihe zum Thema „Mit KI Englisch-Dialoge üben”.
Recherchieren und Material erstellen
Im Chat stellt man Fragen, lädt Dateien hoch und lässt Texte schreiben oder überarbeiten. Mit der Funktion Recherche durchsucht Claude selbstständig zahlreiche Quellen und fasst die Ergebnisse in einem Bericht mit Quellenangaben zusammen. Die Quellen sollten dennoch immer geprüft werden. In Cowork gibt man Claude einen Ordner auf dem eigenen Computer frei. Claude liest die darin enthaltenen Arbeitsblätter, übernimmt deren Layout und erstellt daraus neue Word-, Excel- oder PowerPoint-Dateien.
Lernspiele, Folien und Ordnung
Ohne Programmierkenntnisse lassen sich im Chat kleine Lernspiele, Quiz oder Webseiten erstellen. Diese sogenannten Artifacts laufen direkt im Browser und können über einen Link mit der Klasse geteilt werden. Für größere Programmierprojekte steht Code zur Verfügung. Mit Design entstehen Präsentationen und Plakate, die sich als PowerPoint oder PDF exportieren lassen. In Projekten werden Chats, Dateien und Anweisungen zu einer Klasse oder Unterrichtsreihe gebündelt.
Claude an die eigene Arbeit anpassen
Mit Skills speichert man Arbeitsanweisungen, etwa wie Lesetexte für eine bestimmte Klasse aufgebaut sein sollen. Claude wendet sie automatisch an, sobald sie zur Aufgabe passen. Unter Geplant richtet man Aufgaben ein, die Claude regelmäßig erledigt, zum Beispiel jeden Montag drei aktuelle Themen als Lesetexte aufzubereiten. Diese Aufgaben laufen auch dann, wenn der eigene Computer ausgeschaltet ist.
Datenschutz und Kosten
Da die Daten in die USA übertragen werden, dürfen keine personenbezogenen Daten von Schüler:innen, Kolleg:innen oder anderen Personen eingegeben werden. In den Einstellungen lässt sich deaktivieren, dass Chats zum Training der KI verwendet werden. Claude darf erst ab 18 Jahren genutzt werden und eignet sich daher ausschließlich für die Unterrichtsvorbereitung durch Lehrpersonen. In der kostenlosen Version stehen Stand Oktober 2026 der Chat, Artifacts und Skills zur Verfügung. Recherche, Cowork, Code, Design und geplante Aufgaben setzen ein Abo voraus. Alle Funktionen teilen sich ein gemeinsames Nutzungskontingent, das bei aufwendigen Aufgaben schnell aufgebraucht ist.
Fazit
Claude kann Lehrpersonen viel Vorbereitungsarbeit abnehmen und verbindet Recherche, Materialerstellung und Organisation in einer Anwendung. Prüfen und entscheiden muss die Lehrperson jedoch selbst. Vor der Nutzung lohnt es sich, zu überlegen, welche Funktionen tatsächlich benötigt werden, da der volle Funktionsumfang schnell kostenpflichtig wird.
Claude + Allrounder + Eignet sich für komplexe und umfangreiche Aufgaben – Viele Funktionen gibt es erst in der bezahlten Variante – Konto notwendig – Erst ab 18 Jahren erlaubt
Creative Commons entwickelt die CC Signals weiter. Statt unverbindlicher KI-Präferenzen soll ein Mechanismus kommen, mit dem KI-Crawlern verbindliche Regeln auferlegt werden können. Was die CC Signals bewirken sollen, wie der neue Mechanismus aussehen könnte und welche Fragen offen sind – ein Update in Fragen und Antworten.
Im vergangenen Jahr berichtete iRights.info über die CC Signals. Die „Anstandsregeln für Maschinen“ („manners for machines“) sollten nach Vorstellung der Organisation Creative Commons einen Beitrag gegen die Verwerfungen durch KI leisten. Gemeint sind fehlende Quellenangaben in KI-Outputs, ein womöglich schwindender Anreiz, zu Wikipedia und anderen Commons-Projekten beizutragen, und die technische Last, die KI-Crawler auf Infrastrukturen legen.
Die Organisation Creative Commons hat kürzlich das Konzept der „CC Signals“ vorgestellt. Damit sollen „data stewards“ neue Regeln für die Nutzung von Inhalten durch KI-Anbieter setzen können. Wir stellen die Signals dar und beleuchten die Hintergründe. » mehr
Was will CC mit den Signals bewirken – und wie?
Von Beginn an waren die CC Signals nicht als Weiterentwicklung der CC-Lizenzen gedacht. Herauskommen sollte vielmehr ein eigenständiger Mechanismus, mit dem sich Präferenzen für den „machine use“ von Inhalten erklären ließen. Dies sollte unabhängig vom Bestehen von Urheberrechten – Voraussetzung jeder CC-Lizenzbindung – möglich sein. Gedacht waren die CC Signals zudem eher für ganze Sammlungen von Inhalten als für einzelne Inhalte.
Der Ansatz richtete sich damit mehr an Infrastrukturen als an einzelne Kreative: Ein Wissenschaftsrepositorium oder eine Institution mit Open-Culture-Inhalten soll die Betreiber von KI-Crawlern per CC Signals zum Beispiel dazu auffordern können, die mit der Sammlung von Forschungsdaten, Open-Access-Aufsätzen oder Gemäldedigitalisaten trainierten Modelle später offen zu teilen (Signal „Open“). Daneben umfasste die erste Fassung der CC Signals die Präferenzen „Credit“ (Namensnennung) sowie „Direct Contribution“ und „Ecosystem Contribution“ (Sach- oder Geldbeiträge an Institutionen oder deren Ökosysteme; hierzu näher unser Beitrag aus dem Jahr 2025).
Warum erst nur Präferenzen – und jetzt doch Verbindlichkeit?
In der ersten Version 0.1 aus dem Sommer 2025 waren die CC Signals – zumindest im isolierten Einsatz – nicht bindend. Zum einen wäre das Setzen der CC Signals mangels ausdrücklicher Erklärung für sich genommen kein KI-Opt-Out.
Was ist ein KI-Opt-Out?
Gemeint ist ein Nutzungsvorbehalt, der die gesetzlichen Erlaubnisse ausschließt, auf die sich insbesondere die kommerzielle KI-Entwicklung stützt.
Zum anderen würde der Einsatz eines der Signals zu keiner vertraglichen Bindung zwischen einer Plattform und einem Crawler führen.
Kombiniert mit einem KI-Opt-Out wäre eine Bindungswirkung dagegen durchaus vorstellbar. Genau so war es im Implementierungsvorschlag auch angelegt: Ein über ein weiteres Protokoll erklärter Vorbehalt („nein“) sollte durch die CC Signals eine bedingte Ausnahme erhalten („nein, es sei denn…“) – vorgesehen für Fälle, in denen die Nutzung letztlich erlaubt sein soll, „but with terms attached“. Als eigenständiger Opt-Out waren die CC Signals aber nicht gedacht.
Nachdem CC die CC Signals 0.1 im Sommer 2025 vorgestellt hatte, pochten Communities allerdings auf einen verbindlichen und damit rechtlich durchsetzbaren Ansatz.
Diesen Ruf hat CC inzwischen erhört und im Frühjahr 2026 angekündigt, auf einen bindenden Mechanismus umzustellen: Unverbindliche Präferenzen allein, so CC, könnten keine Handlungsmacht schaffen in einem System, an dem viele nicht freiwillig teilnähmen. Außerdem hätten KI-Labore in Workshops signalisiert: Ein „ja, wenn…“ oder „nein, es sei denn…“ würden sie womöglich als pauschales „Nein“ behandeln. Offenes Wissen, das nur mit der Bitte um Namensnennung geteilt wird, wäre dann für KI, die Vorbehalte achtet, schlicht unsichtbar. Der erwünschte Effekt – Sichtbarkeit der Inhalte für KI, aber eben unter Bedingungen – bliebe aus.
Wie genau wird der Mechanismus aussehen?
Details zur kommenden Iteration der CC Signals sind noch nicht klar. Die grobe Richtung zeichnet sich aber ab: Es wird auf einen „conditional access“ hinauslaufen, also im Ergebnis ein Werkzeug, das den Zugang von Bedingungen abhängig macht. Zuletzt sprach CC von einem „experimental legal tool“, mit dem der Massenzugriff („bulk access“) auf große Sammlungen an Bedingungen geknüpft werden soll.
Wie könnte so etwas aussehen? Denkbar ist hier eine Mischung aus technischer Zugangssteuerung und vertraglicher Bindung: Bots werden erkannt und gestoppt, während gleichzeitig vertragliche Bedingungen für den Zugang formuliert werden.
Die Kreativität im KI-Zeitalter steht vor einer wichtigen Herausforderung: Einerseits sind die KI-Modelle hungrig nach immer neuen Trainingsdaten, mit möglichst viel Schöpfungshöhe. Andererseits pochen die Urheberinnen dieser Daten bzw. die Inhaber der Rechte an den Daten auf eine angemessene Vergütung. Eine neue Initiative namens „Really Simple Licensing“, abgekürzt RSL, verheißt eine unkomplizierte Lösung.
» mehr
Sie sieht vor, dass Crawler vor dem Zugriff einen Vertrag schließen müssen, der etwa ein Crawling nur gegen Gegenleistungen gestattet. Nach diesem Prinzip müssen beide Seiten die Spezifikation einsetzen und sich vorab auf Leistung und Gegenleistung festlegen, die sie zu erbringen bereit sind (zum Beispiel „pay per crawl“). Nur dann kann der Vertragsschluss automatisiert ablaufen.
Vermutlich steht zudem noch eine Entscheidung darüber aus, ob die CC Signals sich auf die KI-Crawler und den „bulk access“ beschränken oder ob der „machine use“ generell im Anwendungsbereich bleiben soll. Schließlich ist KI-Nutzung nicht gleich KI-Nutzung: Neben dem Abziehen ganzer Sammlungen durch Crawler gibt es etwa die KI-gestützte Suche oder die KI-gestützte Auswertung von Inhalten. Der Begriff des „conditional access“ spielt vor allem auf die KI-Crawler an, also nur diesen Teilbereich des „machine use“, den die CC Signals ursprünglich etwas breiter im Blick hatten.
Warum keine neue Urheberrechtslizenz?
Wahrscheinlich wird CC auch weiterhin davon absehen, eine neue CC-Lizenzvariante zu schaffen. Dies hat mehrere (gute) Gründe. Zum einen griffe eine CC-Lizenzbedingung „Non-AI“ in das Gefüge der gesetzlichen Erlaubnisse ein. Denn viele Nutzungen im KI-Kontext sind gesetzlich erlaubt und das CC-Lizenzmodell lässt das rechtlich Zulässige seit jeher unangetastet. Restriktivere Lizenzen einzusetzen, träfe darüber hinaus vor allem die erwünschte Nachnutzung durch Menschen – während die KI-Nutzung dadurch kaum verhindert würde, wie CC schreibt.
Zum anderen hat es noch einen weiteren Charme, nicht auf Urheberrechtslizenzen zu setzen: Viele Akteure, die die KI-Nutzung steuern möchten – etwa weil sie unter der Last auf ihre Infrastruktur ächzen –, haben gar kein Urheberrecht inne, auf das sie eine urheberrechtliche Beschränkung stützen könnten. Ein Beispiel ist das gemeinfreie Kulturerbe. Frei nach der Wikimedia Foundation: „Die Inhalte von Wikimedia sind frei, die Infrastruktur dahinter ist es nicht.“
Es braucht daher einen Ansatz, der unabhängig von Urheberrechten Geltung beanspruchen kann – und damit abseits des CC-Lizenzmodells.
Schränken CC Signals die Openness ein?
Die Organisation CC wirft die große Frage auf: Wie offen kann das Open Web im KI-Zeitalter bleiben? „In einigen Fällen ist bedingter Zugang besser als kein Zugang“, heißt es, und: „Begrenzungen sind nicht zwangsläufig Hindernisse für Offenheit.“
Auch wenn der genaue Mechanismus noch nicht feststeht, ist es aus Sicht der Openness zwingend, die Zugänglichkeit und Nutzbarkeit des einzelnen Inhalts nicht einzuschränken, sondern nur das massenhafte Abziehen durch KI-Crawler. Zudem sollte Wert darauf gelegt werden, Forschung und Archive nicht auf dieselbe Weise einzuschränken wie kommerzielle Bots. So kündigt CC an, dass Nutzungen im öffentlichen Interesse ganz ausgenommen sein sollten, während „resource-heavy bulk reusers“ mehr Bedingungen erfüllen müssten.
In welcher Phase befinden wir uns gerade?
Derzeit hört CC in den Communities genau hin und führt Konsultationen durch. Nach diversen Workshops kündigte CC zudem an, das Werkzeug gemeinsam mit einer kleinen Gruppe von Sammlungsverwaltern („data stewards“) als Pilottestern zu entwickeln, und rief Interessierte auf, sich zu melden. Ein fertiges Werkzeug oder einen Zeitplan hat CC bislang nicht veröffentlicht.
Bleibt es bei dem bisherigen Signals-Set?
Ob es bei den bisherigen Signals „Credit“, „Direct Contribution“, „Ecosystem Contribution“ und „Open“ bleibt, scheint ebenfalls noch offen zu sein. Jedenfalls wird aber das Signal „Credit“ wahrscheinlich in den neuen Ansatz überführt. Denn die Namensnennung ist für CC ein Eckpfeiler der CC-Werkzeuge und der Openness, der auch im KI-Zeitalter Geltung beanspruchen muss: „Today we believe that attribution must be a requirement“, hieß es im Mai, und kürzlich bekräftigte CC, die Namensnennung als Designprinzip für KI-Systeme verankern zu wollen.
Bei der Frage, was genau eine angemessene Namensnennung ist, wird noch Denkarbeit zu leisten sein. Zwar betrachtet CC fehlende Quellenangaben in KI-Outputs häufig eher als im Design begründet denn als technische Notwendigkeit. Doch nicht jede unterlassene Namensnennung ist bei KI eine verwerfliche Designentscheidung. Wie CC selbst feststellt, lässt sich nicht jede Information, die ein Sprachmodell ausgibt, auf die eine Quelle zurückführen, die in das Modell eingeflossen ist. Anders liegt es, wenn ein System eine Quelle live abruft und zusammenfasst. Dann kann es genau auf diese Quelle verlinken. Aber das ist nur ein Anwendungsfall von vielen.
Noch mal grundsätzlich: Was bringen Opt-Outs?
Angesichts der Diskussionen um die Steuerung der KI-Nutzung lohnt sich noch einmal ein grundlegender Blick auf die Frage: Ist der reine Erklärungsweg überhaupt vielversprechend, solange die Nutzung technisch einfach möglich bleibt?
Wer die KI-Nutzung allein mit Opt-Outs oder Präferenzen steuern will, setzt schließlich die Bereitschaft des Gegenübers voraus, die gesetzten Bedingungen auch einzuhalten. Eine soziale Norm in Form von KI-Präferenzen wirkt nur, wenn Adressaten sie befolgen. Sind die Bedingungen dagegen rechtlich verbindlich, müssen sie im jeweiligen Land der Nutzung auch gelten und praktisch durchsetzbar sein.
Und, wie oben ausgeführt: Bei weitem nicht alle Inhalte, bei denen die Steuerung von KI-Crawlern ein legitimes Anliegen ist, sind urheberrechtlich geschützt. Ein Schutzrecht – Urheberrecht, Leistungsschutzrecht, Datenbankrecht – ist aber Voraussetzung dafür, dass ein Nutzungsvorbehalt (hierzulande nach Paragraph 44b Absatz 3 UrhG) überhaupt Wirkung entfaltet. Insgesamt scheint die faktische Steuerung über Technik – kombiniert mit vertraglichen Bedingungen – vielversprechender zu sein.
Umgekehrt ist aber auch der Versuch, bestimmte KI-Nutzungen technisch zu beschränken, mit ungewollten Nebeneffekten verbunden. Wissenschaft, Archive und Start-ups sollten keine zu hohen Hürden auferlegt bekommen. Die Qualität der zukünftigen CC Signals wird sich auch daran messen lassen, inwieweit sie Kollateralschäden vermeiden können.
Redaktioneller Hinweis: Dieser Beitrag entstand im Rahmen der fachlichen Arbeit von NFDI4Culture. Das Konsortium befasst sich mit der Infrastruktur für Kulturdaten in der Wissenschaft.
Sie möchten iRights.info unterstützen?
iRights.info informiert und erklärt rund um das Thema „Urheberrecht und Kreativität in der digitalen Welt“. Alle Texte erscheinen kostenlos und offen lizenziert.
Wenn Sie mögen, können Sie uns über die gemeinnützige Spendenplattform Betterplace unterstützen und dafür eine Spendenbescheinigung erhalten. Betterplace akzeptiert PayPal, Bankeinzug, Kreditkarte, paydirekt oder Überweisung.
Besonders freuen wir uns über einen regelmäßigen Beitrag, beispielsweise als monatlicher Dauerauftrag. Für Ihre Unterstützung dankt Ihnen herzlich der gemeinnützige iRights e.V.!
Mel Robbins hat mit ihrem Buch «The Let Them Theory» ein Mantra populär gemacht: Let them – lass die anderen tun, was sie tun. Du kannst es ohnehin nicht kontrollieren. Und Let me – kümmere dich stattdessen darum, wie du selbst agierst und auf andere reagierst. Dieser Gedanke ist der Kern der stoischen Philosophie, trifft aber offenbar heute einen Nerv.
Nur nicht bei der Mediennutzung von Jugendlichen. Hier sind Ratschläge populär, die primär auf strengen Regeln und viel Kontrolle beruhen. Eltern, so das verbreitete Mindset, müssten sich intensiv darum kümmern, was Teenager mit ihren Handys machen, und dafür sorgen, dass ihre Bildschirmzeit möglichst kurz ausfällt und sich auf medienpädagogisch wertvolle Aktivitäten beschränkt. Dieser Druck geht nicht nur von Eltern aus, sondern erhält auch politische Resonanz: Statt problematische digitale Plattformen rechtlich zu regulieren, denken viele politische Gremien über Handy- und Social-Media-Verbote für Teenager nach.
Ich plädiere für Let them. Teenager befinden sich in einer Lebensphase, in der sie Erfahrungen machen müssen, die ihnen auch schaden können. Das betrifft nicht nur ihre Mediennutzung, sondern auch ihre Ernährung, ihr Risikoverhalten, ihre Schlafhygiene, finanzielle Entscheidungen, ihre Modeentscheidungen, den Umgang mit Drogen, ihre Beziehungen und ihre Sexualität. Die Vorstellung, Eltern oder die Politik seien dafür verantwortlich, dass Jugendliche nichts tun, was negative Auswirkungen auf sie haben kann, ist in dieser Lebensphase nicht nur schräg, sie stellt schlicht eine Überforderung dar. Teenager spielen abends lange digitale Games und sind am Morgen müde? Let them. Sie geben zu viel Geld für ein T-Shirt aus? Let them. Sie hangen mit Freundn:innen ab, die seltsame Kleider tragen und wirre Dinge erzählen? Let them.
Robbins’ Ansatz wird zu Recht kritisiert. Er kommt zu glatt daher und ignoriert Bereiche, wo Menschen Verantwortung übernehmen sollten, sich kritisch positionieren könnten oder Widerstand gegen schädliches Verhalten leisten könnten. Wo Machtgefälle bestehen und wo Menschen tatsächlich Verantwortung für andere tragen, ist Let them verwerflich. Wenn Kinder Gefahr laufen, sich auf dem Spielplatz den Kopf aufzuschlagen, wenn sie vom Klettergerüst fallen, ist Let them keine Lösung.
Die Pointe bei der Mediennutzung Jugendlicher ist die, dass sie keine Kinder mehr sind, die Eltern vor Gefahren bewahren müssen, die sie nicht einschätzen können. Jugendliche können medienpädagogische Risiken oft deutlich besser beurteilen als ihre Eltern und Lehrpersonen. Nur nehmen sie diese halt oft bewusst in Kauf, weil sie die damit verbundenen Erfahrungen machen wollen oder machen müssen. Let them. Sie lernen dabei, wiederholen Fehler meist nicht und sind nach intensiven Phasen oft an Dingen nicht mehr interessiert, die ihnen nicht guttun.
Mel Robbins‘ Rat hat zwei Teile. Wir müssen über Let me sprechen: Was können Eltern tun, wie sollten sie agieren und reagieren?
Das Wichtigste ist Interesse: Eltern sollten sich darüber informieren, was jungen Menschen wichtig ist, wie sie die Welt wahrnehmen, welche Ziele sie haben, wie sie Entscheidungen fällen.
Eltern unterstützen Teenager, wenn sie sich mit Problemen konfrontiert sehen, die sie selber nicht lösen können. Sie schaffen eine Umgebung, in der Teenager sich wohl fühlen und sicher sind.
Sie dürfen und müssen mit Jugendlichen über Gefahren, Probleme und langfristige Auswirkungen von problematischem Medienkonsum sprechen. Dabei dürfen sie auch ihre Erfahrungen und Ängste ansprechen.
Sie reflektieren ihren eigenen Lebensstil und ihre Mediennutzung, verantworten ihre Entscheidungen und versuchen ihre Rolle positiv zu gestalten. Sie wissen, was ihnen selbst guttut und was nicht.
Sie können sich von ihren Ängsten lösen und schaffen es, sie zu relativieren, statt sich von ihnen beherrschen zu lassen. Sie halten nicht besserwisserisch an dem fest, was sie über Medien und ihre Auswirkungen zu wissen meinen, sondern sie offen für andere Praktiken und Sichtweisen.
Let them bedeutet nicht, Teenager Gefahren auszusetzen und sie nicht zu begleiten. Es bedeutet aber, sie das tun zu lassen, was sie gerne tun. Darüber darf man mit ihnen sprechen, auch um zu verstehen, warum das Spass macht und ihnen wichtig ist. Selbstverständlich darf man auch Alternativen anbieten. Aber Zwang und Kontrolle sind immer etwas, was mehr mit Erwachsenen zu tun hat als mit Jugendlichen. Let them bedeutet auch, unnötige Konflikte zu vermeiden, die in diesem Alter eine enorme Belastung für Eltern wie Kinder darstellen und den möglichen Nutzen, den eine reduzierte oder gefahrenfreie Mediennutzung hätte, meist aufheben. Eine gute Orientierung stellt das dar, was man sich als Teenager selbst von den Eltern gewünscht hätte.
Wie kann im KI-Zeitalter Vertrauen in Medieninhalte sichergestellt werden? Ein neues Thesenpapier des iRights.Lab behandelt diese Frage.
Die Frage, wie Vertrauen in digitale Inhalte sichergestellt werden kann, begleitet das Web von Anfang an. Zentrale Aspekte in diesem Diskurs sind die Authentizität und Glaubwürdigkeit digitaler Inhalte, ihre Verlässlichkeit, Transparenz und Nachvollziehbarkeit. Die Etablierung generativer KI-Modelle verschärft die Notwendigkeit, tragfähige Lösungen zur Kennzeichnung von KI-Output zu entwickeln. Artikel 50 der europäischen KI-Verordnung definiert Transparenzpflichten für Anbieter und Betreiber bestimmter KI-Systeme.
iRights.info informiert und erklärt rund um das Thema „Urheberrecht und Kreativität in der digitalen Welt“. Alle Texte erscheinen kostenlos und offen lizenziert.
Wenn Sie mögen, können Sie uns über die gemeinnützige Spendenplattform Betterplace unterstützen und dafür eine Spendenbescheinigung erhalten. Betterplace akzeptiert PayPal, Bankeinzug, Kreditkarte, paydirekt oder Überweisung.
Besonders freuen wir uns über einen regelmäßigen Beitrag, beispielsweise als monatlicher Dauerauftrag. Für Ihre Unterstützung dankt Ihnen herzlich der gemeinnützige iRights e.V.!
Auf digitalen Plattformen kursieren Beiträge, die zwei Arten von Tricks zeigen. Mit beiden soll nachgewiesen werden, dass die jeweils andere Seite einer Lehr-Lern-Beziehung nicht sauber gearbeitet hat.
Auf der einen Seite steht die Lehrperson, die Schreibaufgaben mit unsichtbaren Anweisungen ergänzt. Kopieren Schüler:innen die Aufgabe in einen KI-Chatbot, befolgt dieser die versteckten Anweisungen und fügt etwa unpassende Wörter wie «Madagaskar» in den Text ein. Daran erkennt die Lehrperson dann, dass die Schüler:innen einen Chatbot verwendet haben, obwohl sie das nicht durften.
Auf der anderen Seite fügen Lernende Sätze in ihre Arbeiten ein, mit denen sie feststellen können, ob die Lehrenden diese wirklich lesen oder die Bewertung KI-Tools überlassen. Hier die eher humorvolle Reaktion eines Professors auf dieses Verfahren:
Nun: All das hat es schon immer gegeben. Schriftliche Arbeiten bieten Lernenden die Affordanz, Abkürzungen zu nehmen und weniger Aufwand zu betreiben, als eigentlich erwartet würde. Sie haben schon immer Textteile kopiert, Ghostwriter beauftragt, Texte künstlich in die Länge gezogen usw. Gleichzeitig haben Korrigierende schon immer nach Wegen gesucht, ihren Zeitaufwand zu reduzieren, und Arbeiten deshalb nur überflogen. An vielen deutschen Universitäten erhalten Studierende nur dann Feedback auf Seminararbeiten, wenn sie es ausdrücklich einfordern – teilweise ist das sogar nur möglich, wenn sie eine schlechte Note erhalten haben.
Die Verfügbarkeit von KI spitzt das Problem nur zu, weil der zeitliche Aufwand auf beiden Seiten auf null gesunken ist. Studierende können die Aufgabenstellung in ChatGPT eingeben und erhalten eine fertig formatierte Hausarbeit mit Quellenangaben – Lehrende können diese Arbeit bei ChatGPT hochladen und erhalten ohne Aufwand eine Bewertung samt wohlformulierter Rückmeldung.
Wenn es nun Settings und Formate gibt, in denen Vertrauen grundsätzlich nicht möglich ist, stellt sich die Frage, wie es wiederhergestellt werden kann. Vertrauen kann – im Gegensatz zu Misstrauen – nicht durch ein «System» entstehen. Vertrauen entsteht in Beziehungen und durch Beziehungsarbeit. Sind Hausarbeiten Teil dialogischer Lernverfahren, dienen sie also dazu, das eigene Denken einem Gegenüber verständlich zu machen, das wiederum darauf reagiert, dann kann das eingangs beschriebene Misstrauen gar nicht erst entstehen. Fehlen Beziehungen aber fast gänzlich, dann stehen Lernende und Lehrende nur einem unpersönlichen System gegenüber und fragen sich: Wie kann ich mit möglichst wenig Aufwand möglichst viele Credits und gute Noten erhalten? Mit KI. Wie bewältige ich all meine Aufgaben so, dass ich mich nicht ins Burnout arbeite und nicht kritisiert werde? Mit KI. Sind Arbeiten und Rückmeldungen hingegen Teil einer funktionierenden Beziehung, dann geht es darum, einem Gegenüber einen eigenen Eindruck, eine eigene Denkleistung zu vermitteln.
Nur: Das ist leichter gesagt als getan. Viele Betreuungsverhältnisse und Stellen sind so ausgestattet, dass die Zeit für den Aufbau und die Pflege von Beziehungen nicht ausreicht. Dann sind Misstrauen und Effizienzsteigerung die Regel – und es ist schlicht vernünftig anzunehmen, dass sich niemand aus moralischem Pflichtgefühl an Vorgaben hält. In diesem Falschen gibt es dann eben nichts Richtiges mehr.
Creativly ist ein kleines Tool, mit dem man ohne Anmeldung unterschiedlichste Varianten von KI-Bildern generieren kann. Dabei erfolgt allerdings eine Einschränkung auf bestimmte Kategorien von Bildern und Grafiken, die erzeugt werden können:
Isometrische Icons, Retro Toy Box, Typografische Poster, sogar Crocs-Schuhe können ‚personalisiert‘ werden. Nach Auswahl eines der vielen vorhandenen Generatoren kann man sein gewünschtes Design erstellen.
Es macht auf jedem Fall Spaß, eigene Ideen auf einfachste Art und Weise in Bilder zu übertragen.
Hier drei kleine Beispiele, wie die erzeugten Bilder aussehen können. Es zahlt sich auf jeden Fall aus, ein wenig in der Vielzahl der vorhandenen Generatoren zu stöbern.
Schneekugel
Minimalistisches Filmposter
Historische Abbildung eines Telefons
Auch eigene Generatoren lassen sich nach Auswahl einer Kategorie und Eingabe der gewünschten Ergebnisse erzeugen.
WEBSITE: Creativly | creativly.app/Home

+ Kostenfreie Nutzung
+ Viele Bildgeneratoren können sofort ausprobiert werden
+ Eigene Ideen lassen sich umsetzen, indem vorgefertigte Fragen zum gewünschten 'Bildgenerator' beantwortet werden
– eingeschränkte Möglichkeiten der freien Bildgenerierung
– Oberfläche in englischer Sprache
Wie lizenziert man OERs, wenn diese aus so genanntem „gemischtem Material“ mit KI-Anteil bestehen? Und wann haben solche Inhalte urheberrechtliche Relevanz? Mehr dazu hier:
Künstliche Intelligenz unterstützt Schaffende auch bei der Erstellung von OERs in variablem Umfang. Häufig entstehen dabei so genannte „gemischte Materialien“. Damit gemeint sind Materialien, die entweder aus einer Zusammenstellung von KI-generierten und persönlich erstellten Elementen bestehen oder aus einem Inhalt, für dessen Erstellung KI und Mensch zusammenwirken. Je nachdem, wie das gemischte Material beschaffen ist, gibt es dabei in Bezug auf die Lizenzierbarkeit und die Kennzeichnung des KI-Dienstes verschiedene Aspekte zu beachten.
Was sind gemischte Inhalte?
Bei gemischten Materialien ist zwischen Inhalten mit trennbaren Elementen und Inhalten mit einem Hauptelement mit zwei Erstellungsmethoden zu unterscheiden:
Verfasst eine Autorin für einen Online-Artikel beispielsweise einen Text und fügt diesem ein KI-generiertes Titelbild hinzu, handelt es sich bei der Kombination aus Text und Bild um ein gemischtes Material, wobei das Bild und der Text dabei zwei voneinander trennbare Elemente sind.
Lässt die Autorin den Text selbst teilweise mit KI erstellen und verfasst ihn teilweise selbst, liegt mit dem Text ein Hauptelement mit zwei Erstellungsmethoden vor.
Wann wird ein KI-Beitrag urheberrechtsrelevant?
Da ein urheberrechtlicher Schutz – und damit auch eine Lizenzierung mit CC BY – eine persönliche geistige Schöpfung voraussetzt, sind KI-generierte Materialien mangels menschlicher Schöpfung nicht schutz- und lizenzierfähig. KI-Output ist damit von sich aus gemeinfrei bzw. „open“.
Prompt versus persönliche geistige Schöpfung
KI-Outputs werden durch das Eingeben eines Befehls, eines so genannten Prompts, erzeugt. Eine persönliche geistige Schöpfung setzt voraus, dass eine Person ein Werk durch eigene kreative, individuelle Entscheidungen formt. Da ein Prompt als Steuerung eines technischen Systems zu verstehen und rein anweisend ist, erfüllt er nicht die Voraussetzung einer persönlichen geistigen Schöpfung.
In der Praxis wird der Output nach dem Prompt häufig noch verfeinert. In so einem Fall kann es urheberrechtlichen Schutzfähigkeit des Prompts kommen, wenn der kreative Beitrag der Erstellerin stärker hervortritt, als die KI-generierten Inhalte. Mehr dazu hier.
Wie lizenziere ich gemischte Inhalte?
Hier gilt Unterschiedliches, je nachdem, ob es sich um Inhalte mit trennbaren oder untrennbaren Elementen handelt.
1. Inhalte mit trennbaren Elementen
Da die KI-generierten Inhalte naturgemäß gemeinfrei sind, sollten diese mit einem Public Domain Mark versehen werden. Die selbst erstellten, urheberrechtlich geschützten Inhalte können lizenziert werden. Damit der Inhalt als OER genutzt werden kann, empfiehlt sich die Lizenzierung mit der CC BY 4.0-Lizenz. Soll das gemischte Material einheitlich lizenziert werden, empfiehlt sich die CC0-Lizenz. Da diese Lizenz die lizenzierten Inhalte in die Gemeinfreiheit entlässt, eignet sie sich auch zur Kennzeichnung von vornherein gemeinfreien Inhalten. Genaueres dazu hier.
2. Inhalte mit einem Hauptelement
Bei Inhalten, die aus einem Hauptelement bestehen, durch die Mischung aus KI-Generierung und persönlichem Schaffen entstanden sind und bei denen der Schwerpunkt der Erstellung im persönlichen Schaffen liegt, kann der Inhalt insgesamt mit einer Lizenz wie der CC BY 4.0-Lizenz versehen werden. Liegt der Schwerpunkt in der KI-Generierung, ist der Inhalt insgesamt als gemeinfrei zu kennzeichnen. In beiden Fällen kann auch hier eine CC0 Lizenz verwendet werden.
Wie mache ich KI-Anteile transparent?
Im Kontext der KI-Verordnung hat die EU-Kommission jüngst einen Verhaltenskodex für die Kennzeichnung von KI-Inhalten veröffentlicht. In diesem Leitfaden finden sich auch Vorschläge für KI-Kennzeichnungs-Symbole, die hier näher dargestellt werden. Auch wer individuelle OER-Materialien erstellt, kann hieraus Orientierungshilfen für die KI-Kennzeichnung ableiten. Generell empfiehlt es sich bei der Erstellung von OER-Materialien mit KI den verwendeten KI-Dienst zu nennen. Darüber hinaus sollten Erstellende darstellen, wofür KI genau verwendet wurde und der Prompt sollte allgemein beschrieben werden. Bei Materialien mit trennbaren Anteilen bietet sich die Kennzeichnung so nah am KI-Inhalt wie möglich an (beim Text-Bild-Beispiel also direkt unter dem Bild). Bei Materialien mit einem Hauptelement kann der Hinweis unter dem Inhalt erfolgen.
iRights.info informiert und erklärt rund um das Thema „Urheberrecht und Kreativität in der digitalen Welt“. Alle Texte erscheinen kostenlos und offen lizenziert.
Wenn Sie mögen, können Sie uns über die gemeinnützige Spendenplattform Betterplace unterstützen und dafür eine Spendenbescheinigung erhalten. Betterplace akzeptiert PayPal, Bankeinzug, Kreditkarte, paydirekt oder Überweisung.
Besonders freuen wir uns über einen regelmäßigen Beitrag, beispielsweise als monatlicher Dauerauftrag. Für Ihre Unterstützung dankt Ihnen herzlich der gemeinnützige iRights e.V.!
Künstliche Intelligenz unterstützt Schaffende auch bei der Erstellung von OERs in variablem Umfang. Häufig entstehen dabei so genannte ‚gemischte Materialien‘. Damit gemeint sind Materialien, die entweder aus einer Zusammenstellung von KI-generierten und persönlich erstellten Elementen bestehen oder aus einem Inhalt, für dessen Erstellung KI und Mensch zusammenwirken. Je nachdem, wie das gemischte Material beschaffen ist, gibt es dabei in Bezug auf die Lizenzierbarkeit und die Kennzeichnung des KI-Dienstes verschiedene Aspekte zu beachten.
Bunte Bonbons aus der Tüte – Süße Verlockung für Naschkatzen. Bild: Marco Verch via CCNull.de, CC BY 2.0; Seitenverhältnisse geändert von Angela Karnoll
Ein Beitrag von Lea Singson
Was sind gemischte Inhalte?
Bei gemischten Materialien ist zwischen Inhalten mit trennbaren Elementen und Inhalten mit einem Hauptelement mit zwei Erstellungsmethoden zu unterscheiden:
Verfasst eine Autorin für einen Online-Artikel beispielsweise einen Text und fügt diesem ein KI-generiertes Titelbild hinzu, handelt es sich bei der Kombination aus Text und Bild um ein gemischtes Material, wobei das Bild und der Text dabei zwei voneinander trennbare Elemente sind.
Lässt die Autorin den Text selbst teilweise mit KI erstellen und verfasst ihn teilweise selbst, liegt mit dem Text ein Hauptelement mit zwei Erstellungsmethoden vor.
Wann wird ein KI-Beitrag urheberrechtsrelevant?
Da ein urheberrechtlicher Schutz – und damit auch eine Lizenzierung mit CC BY – eine persönliche geistige Schöpfung voraussetzt, sind KI-generierte Materialien mangels menschlicher Schöpfung nicht schutz- und lizenzierfähig. KI-Output ist damit von sich aus gemeinfrei bzw. „open“.
Prompt versus persönliche geistige Schöpfung
KI-Outputs werden durch das Eingeben eines Befehls, eines so genannten Prompts, erzeugt. Eine persönliche geistige Schöpfung setzt voraus, dass eine Person ein Werk durch eigene kreative, individuelle Entscheidungen formt. Da ein Prompt als Steuerung eines technischen Systems zu verstehen und rein anweisend ist, erfüllt er nicht die Voraussetzung einer persönlichen geistigen Schöpfung.
In der Praxis wird der Output nach dem Prompt häufig noch verfeinert. In so einem Fall kann es urheberrechtlichen Schutzfähigkeit des Prompts kommen, wenn der kreative Beitrag der Erstellerin stärker hervortritt, als die KI-generierten Inhalte. Mehr dazu hier.
Wie lizenziere ich gemischte Inhalte?
Hier gilt Unterschiedliches, je nachdem, ob es sich um Inhalte mit trennbaren oder untrennbaren Elementen handelt.
Inhalte mit trennbaren Elementen
Da die KI-generierten Inhalte naturgemäß gemeinfrei sind, sollten diese mit einem Public Domain Mark versehen werden. Die selbst erstellten, urheberrechtlich geschützten Inhalte können lizenziert werden. Damit der Inhalt als OER genutzt werden kann, empfiehlt sich die Lizenzierung mit der CC BY 4.0-Lizenz. Soll das gemischte Material einheitlich lizenziert werden, empfiehlt sich die CC0-Lizenz. Da diese Lizenz die lizenzierten Inhalte in die Gemeinfreiheit entlässt, eignet sie sich auch zur Kennzeichnung von vornherein gemeinfreien Inhalten. Genaueres dazu hier.
Inhalte mit einem Hauptelement
Bei Inhalten, die aus einem Hauptelement bestehen, durch die Mischung aus KI-Generierung und persönlichem Schaffen entstanden sind und bei denen der Schwerpunkt der Erstellung im persönlichen Schaffen liegt, kann der Inhalt insgesamt mit einer Lizenz wie der CC BY 4.0-Lizenz versehen werden. Liegt der Schwerpunkt in der KI-Generierung, ist der Inhalt insgesamt als gemeinfrei zu kennzeichnen. In beiden Fällen kann auch hier eine CC0 Lizenz verwendet werden.
Wie mache ich KI-Anteile transparent?
Im Kontext der KI-Verordnung hat die EU-Kommission jüngst einen Verhaltenskodex für die Kennzeichnung von KI-Inhalten veröffentlicht. In diesem Leitfaden finden sich auch Vorschläge für KI-Kennzeichnungs-Symbole, die hier näher dargestellt werden. Auch wer individuelle OER-Materialien erstellt, kann hieraus Orientierungshilfen für die KI-Kennzeichnung ableiten. Generell empfiehlt es sich bei der Erstellung von OER-Materialien mit KI den verwendeten KI-Dienst zu nennen. Darüber hinaus sollten Erstellende darstellen, wofür KI genau verwendet wurde und der Prompt sollte allgemein beschrieben werden. Bei Materialien mit trennbaren Anteilen bietet sich die Kennzeichnung so nah am KI-Inhalt wie möglich an (beim Text-Bild-Beispiel also direkt unter dem Bild). Bei Materialien mit einem Hauptelement kann der Hinweis unter dem Inhalt erfolgen.
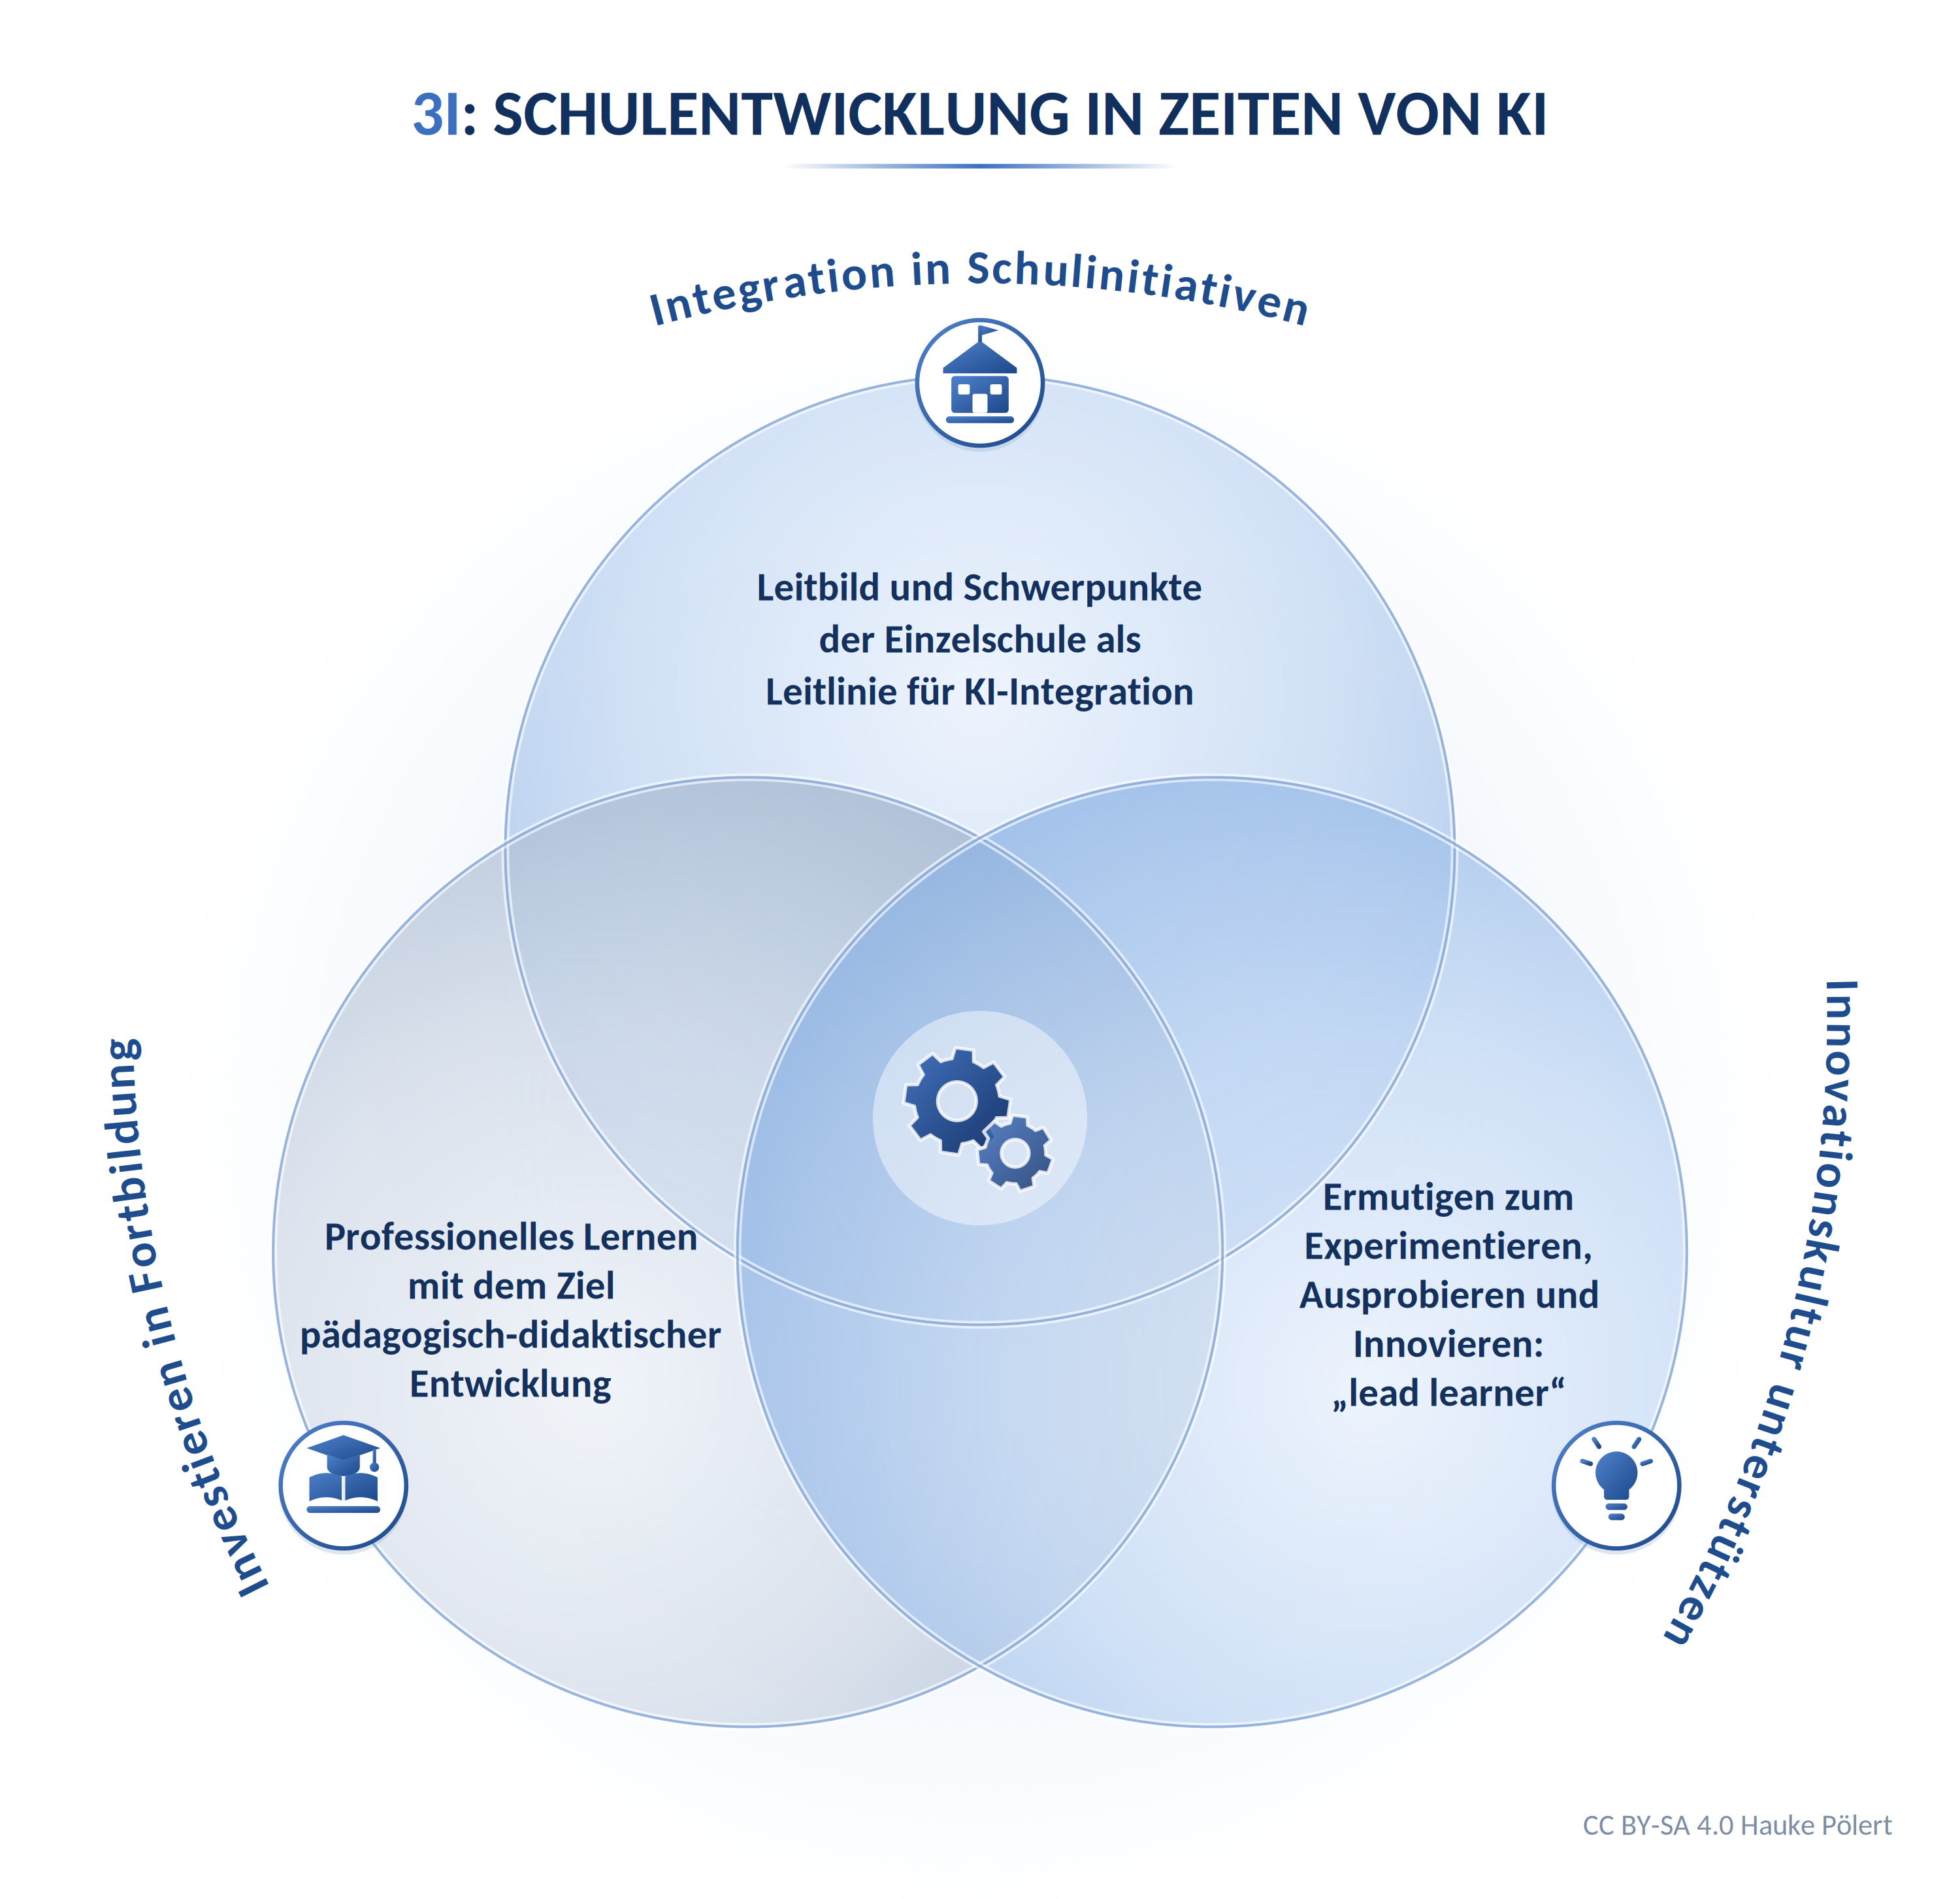
Wie wichtig Basis-Professionalisierung und der Einstieg in systematische Unterrichtsentwicklung mit Blick auf genKI nach wie vor sind, zeigen die aktuellen PISA 2025-Ergebnisse deutlich. Gerade Pädagogische Tage zu gutem Lernen im Kontext von genKI verlaufen dann auch immer konstruktiv und motivierend. Zu offensichtlich scheint allen Beteiligten zu sein, wie sehr (eigenständiges) Lernen und (langjährige) Schulpraxis durch genKI in Frage gestellt werden. Schwieriger dagegen ist die Frage, was nach 3, 6 oder 12 Monaten vom Pädagogischen Tag in die alltägliche Praxis eingeflossen ist. In diesem Beitrag stelle ich einen Prozessvorschlag vor, der aus einem konkreten Fortbildungsprojekt heraus entstanden ist und mit dem Schulen nach einem gemeinsamen Einstieg strukturiert weiterarbeiten können – angepasst an die eigenen Schwerpunkte und Zielsetzungen und mit Blick auf die schulinternen Bedarfe.
Was kommt nach dem Pädagogischen Tag?
Intensives Programm: Pädagogischer Tag „KI und Lernen“
Kürzlich war ich an der Deutschen Schule Málaga als Referent zu Gast. Nach zwei vollgepackten Tagen zu Blended Learning im Herbst 2023 stand nun das Thema generative KI im Fokus. Gemeinsam gestalteten wir einen intensiven Pädagogischen Tag mit drei großen Modulen für Grundschule und Oberschule, differenzierten Materialien für die Aufgabenfelder und einem sehr motivierten Kollegium, das Prompt-Karten und formatives KI-Feedback ausprobiert, KI-Klassenräume eingerichtet und über Lernen in Zeiten von KI diskutiert und die eigene Perspektive (hoffentlich) geschärft hat. Ich denke, nach diesem so anstrengenden wie motivierenden Tag stand vor allem eine gemeinsame Erkenntnis: Diesen fundamentalen Wandel müssen, wollen und werden wir (aktiv) und hoffentlich gut unterstützt mitgestalten.
Und trotzdem ist an dieser Stelle nach meiner Abreise eine ganz entscheidende Frage noch nicht beantwortet, auf die eigentlich jede Fortbildung hinausläuft: „Und wie machen wir jetzt weiter, wo wollen wir damit als Schule hin – und wie machen wir das als Kollegium und Schulgemeinschaft?“
Die Schulentwicklungsforschung hat für das, was (leider zu häufig) nach „Fortbildung“ passiert, einen Begriff geprägt: den Implementation Dip. Nach dem Impuls folgt der Alltag, der Alltag ist voll, stressig und mit zahlreichen neuen Belastungen gefüllt, und die Energie eines einzelnen Tages hält dann selten über das Schuljahr an. Was bleibt, sind ein paar Kolleginnen und Kollegen, die allein oder in einer Projektgruppe weitermachen – und das sind dann meist die, die ohnehin schon vorher angefangen hatten. Die späte Mehrheit, also die eigentlich entscheidende Gruppe, bleibt eher zurück und gerät wieder in den Strudel des Schulalltags.
Das ist meist weniger ein Versagen der punktuellen Fortbildung, sondern ein strukturelles Problem: Ein Tag ist ein begrenztes Ereignis, vielleicht ein kick-off, Schulentwicklung ist aber ein komplexer Prozess von längerer Dauer. Was Schulen daher brauchen, ist nicht ausschließlich der einzelne Fortbildungstag, sondern eine kontinuierlich gedachte Struktur, in die eine Einzelinitiative einmündet.
Schon etwas müde und abgekämpft hatten wir in Málaga am Abend noch die Energie übrig, uns genau mit diesem Ziel zusammenzusetzen und mit der Steuergruppe zu arbeiten. Dabei habe ich mir einzelne Schlüsselbegriffe notiert, aus denen anschließend auf dem Rückflug der hier vorgestellte Prozessvorschlag entstand. Passend erschien mir dabei, dass einige Tage zuvor während eines Pädagogischen Tages an der OBS Berenbostel ganz ähnliche Aspekte das Auswertungsgespräch prägten. Dieser Vorschlag ist also keine schnelle KI-Schöpfung, sondern stellt in seinen Begriffen und Zusammenhängen eine Rekombination der Gesprächsthemen und Überlegungen dar – und lässt sich mit einem sehr passenden Kürzel beschreiben: KURS.
Und für mich besonders spannend: Mehrere Schulen in mehreren Bundesländern (NRW, Hessen, Niedersachsen) beginnen in diesen Tagen mit der Schuljahresarbeit – und nutzen dafür die KURS-Vorlage.
Kurzer Doppelexkurs: Typische Schwierigkeiten – Wunsch nach Tools und einem Vollkonzept
Doch einen Aspekt möchte ich noch kurz vorwegschieben. Denn zwei ganz typische Reaktionen auf einen Fortbildungstag sind so nachvollziehbar wie schwierig, auch wenn sie gut und richtig gemeint sind und ja auch das „Vom Wollen ins Machen kommen!“ forcieren.
Tool-Fokus: Man legt eine Liste erlaubter Tools und/oder Plattformen fest, schult diese, und hält das für Umsetzung. Das Problem ist nicht, dass Tool-Kenntnis unnötig wäre, sondern eher, dass damit wichtige pädagogische Fragestellungen übersprungen oder gar nicht erst in den Blick genommen werden. Wer mit einer spannenden Plattform beginnt, landet dann fast zwangsläufig bei der Frage, wofür man es denn jetzt noch einsetzen könnte, obwohl es doch eigentlich andersherum laufen sollte. Gerade beim Thema KI haben Schulen aber zugleich recht enge Spielräume, wenn z.B. nur Pädagogische KI wie fobizz, paddy oder SchulKI und DSGVO-konforme Plattformen wie FelloFish oder KorrekturKumpel eingesetzt werden dürfen – Tools und pädagogisches Konzept sollten dann zumindest permanent abgestimmt werden.
Vollständigkeitsfalle: Man nimmt sich vor, genKI in der ganzen Schule, in allen Fächern, über alle Jahrgänge zu verankern, und schreibt ein umfassendes, häufig curricular aufgebautes Konzept. Nach einem halben Jahr ist das Konzept zwar fertig, aber die Akzeptanz kaum vorhanden und/oder die Implementierung kaum praktikabel.
Der Befund der Fortbildungsforschung ist an dieser Stelle ziemlich eindeutig: Fokus und Tiefe wirken stärker als Umfang.
Exkurs: Wichtige Erkenntnisse aus der Fortbildungsforschung (Lynch et. al.) zum Nachlesen (hier klicken)
Zu der Frage, was wir über wirksame (KI-)Fortbildung wissen, erschien 2025 eine umfangreiche Meta-Analyse (betrachtet wurden von Lynch et. al. zwar 46 Studien aus dem MINT-Bereich, die Befunde lassen sich aber meines Erachtens mit etwas Vorsicht und unter Berücksichtigung möglicher Fachunterschiede auf andere Bereiche übertragen). Die zentralen Erkenntnisse decken sich mit der anekdotischen Evidenz sicherlich vieler an Fortbildung und Professionalisierung interessierten Beteiligten – hier nur in aller Kürze:
Erkenntnisse zu wirksamer Fortbildung nach Lynch et. al.:
Gezielte Fortbildungen können signifikante Veränderungen im Lehrkräftehandeln bewirken.
Verbesserungen im Unterrichtshandeln korrelieren mit besseren Leistungen von Schülerinnen und Schülern.
Das bedeutet: Es ist also kein „verlorenes Spiel“, Lehrkräfte in komplexen, neuen Themen wie KI nachzuqualifizieren, wenn das bislang eher versäumt worden ist.
Qualität schlägt Quantität:
Kein signifikanter Zusammenhang zwischen Dauer der Fortbildung und Erfolg.
Entscheidend sind Fokus, Qualität und materialgestützte Kontinuität.
Endlose Zertifikatskurse sind nicht per se besser als fokussierte, intensive Interventionen.
Fachwissen ist zentral:
Fortbildungen mit Fokus auf Fachwissen – oder um es mit dem DPACK-Modell zu beschreiben: Content Knowledge (CK) – zeigen stärkere Effekte.
Reine Methodenschulungen („Wie nutze ich Tool X?“) greifen zu kurz.
Lehrkräfte müssen die Funktionsweise von KI verstehen, um didaktisch wirksam zu handeln.
Formatives Assessment als Hebel:
Fortbildungen mit Fokus auf formatives Feedback zeigen besonders starke Effekte.
Der stärkste didaktische Hebel von KI scheint also genau hier zu liegen: im formativen Feedback, also in der konstruktiven Lernbegleitung/Lernunterstützung, und damit in einer zentralen Dimension von Unterrichtsqualität.
Fortbildungen sollten primär auf solche Elemente der Tiefenstrukturen von Unterricht fokussieren, nicht auf „Content-Generierung“ – denn schon jetzt bleibt KI-Anwendung allzu häufig auf der Angebotsebene von Unterricht („Jetzt kann aus Material X per Klick das Material Y machen!“ etc.), wie ich im Blogbeitrag zum Angebots-Nutzungs-Modell in Zeiten von KI ausführlicher beschreibe.
Weitere wichtige Studien zur Lehrkräfteprofessionalisierung bestätigen diese Befunde: Die Hattie-Metaanalyse zu Professional Development zeigt ähnliche Muster, ebenso Studien zum Modell der Lehrkräftefortbildung in Singapur, das als internationales Vorbild gilt (und das ich daher sehr gerne einmal besuchen würde).
Wirksame Professionalisierung ist also im besten Fall fachbezogen, über einen längeren Zeitraum angelegt und arbeitet an wenigen Fragen gründlich, anstatt viele Themen ansatzweise zu streifen. Das spricht gerade zu Beginn gegen ein großes Gesamtkonzept, wobei sich das natürlich nicht zwangsläufig ausschließen muss, und eher für einen wiederkehrenden Zyklus mit jeweils einem Schwerpunkt.
KURS-Zyklus: 4 Phasen, 1 Schwerpunkt, 1 Schuljahr
Das aus den im Abendgespräch notierten Begriffen entstandene Prozessvorschlag (oder wie immer man das jetzt nennen will), der als iterativer Zyklus angelegt ist, heißt KURS und besteht aus vier Schritten:
Und natürlich ist klar: Das ist ein ziemlich normaler Prozessablauf, den wir ganz ähnlich mit Planung, Umsetzung, Reflektion, Überarbeitung als typische iterative Spirale kennen. Der aus dem unternehmerischen Qualitätsmanagement bekannte PDCA-Zyklus z.B. bietet eine ganz ähnliche Grundlage, hat aber einen ganz anderen Kontext.
Ich habe daher auch gar nicht den Anspruch, dass KURS nun sensationell neu und originell wäre.
Das Akronym KURS finde ich als Prozessvorschlag für die Schulpraxis gerade in turbulenten Zeiten aber dennoch ganz passend. Denn ein Kurs – auf See, im Flugzeug oder beim Wandern – wird mit einem Ziel vor Augen bestimmt, gefahren und ggf. korrigiert. Er steht nicht fest, aber er ist auch nicht beliebig, denn er läuft auf ein zu erreichendes Ziel zu. Und in der Regel wird (Autopiloten mal außen vor) der Kurs von Menschen gesteuert und gehalten, nicht von der Maschine.
Mit Blick auf die vorher skizzierte Studienlage und langjährige eigene Praxiserfahrungen in Schule und Fortbildungen erscheinen daher
ein Entwicklungsschwerpunkt pro Zyklus und
ein Zyklus pro Schuljahr
in vier aufeinanderfolgenden Schritten als sinnvolle Vorgehensweise.
Wer z.B. mit Blick auf formatives Feedback in einem Schuljahr KI-gestütztes Schreibfeedback in drei Fachschaften wirklich durchdringt und didaktisch verankert, hat wohl konzeptuell mehr erreicht als eine Schule, die zwölf Tools in acht Fächern angetestet hat.
K – Klären: An welchem Lernproblem arbeiten wir, und wo stehen wir?
Die erste Phase beginnt nicht bei genKI, sondern beim Lernen unserer Schülerinnen und Schüler – und zwar aus beiden Perspektiven, also sowohl der Lernenden als auch der Lehrenden (analog zum Kompetenzmodell „Lehren und Lernen“).
Welches konkrete Problem im Lernen unserer Schülerinnen und Schüler wollen wir bearbeiten und bestenfalls verbessern? Schreibkompetenz, Feedback im Prozess, Differenzierung, Prüfungsformate, sprachsensibler Fachunterricht sind dann typische Schwerpunkte je nach Schulproful, „Wir führen fobizz ein“ dagegen ist keiner.
Dazu gehört dann auch eine ehrliche Standortbestimmung: Wo steht das Kollegium wirklich, welche Chancen und Gefahren sehen die Kolleginnen und Kollegen aus ihrer Perspektive? Das Kompetenzmodell „KI-Kompetenzen für Lehrende und Lernende“ von Alles, Falck, Flick und Schulz liefert dafür mit vier Bereichen (Verstehen, Anwenden, Reflektieren, Mitgestalten) und drei Niveaustufen ein sehr hilfreiches Raster. Nützlich ist außerdem ein Blick auf die bisherigen Fortbildungen: Wie viel davon lag im Bereich des reinen Anwendens – und wie viel im Verstehen, im Bewerten, im Bereich ethischer Fragen? Eine gewisse Schieflage ist schon aus der Natur der Sache heraus an den meisten Schulen vorhanden.
Und schließlich gehört in diese Phase die Frage, die (eben nicht nur) skeptische Kolleginnen und Kollegen am direktesten anspricht: Was muss menschlich bleiben? Welche Kompetenzen sollen die Lernenden selbst beherrschen und deshalb auch ohne KI üben? Solange Abschlussprüfungen mit Stift und Papier geschrieben werden, ist das auch eine ganz pragmatische Frage.
Und wer diesen „geschützten Kern“ zuerst benennen darf, gerade aus einer bereits vorhandenen kritischen Position heraus, steigt anders in den Prozess (mit) ein als jemand, der gegen eine bereits gefallene Entscheidung argumentieren soll.
Ergebnis dieser Phase: ein Schwerpunkt in einem Satz und ein Bedarfsprofil des Kollegiums.
U – Umsetzen: Was müssen wir verstehen, und was entwickeln wir gemeinsam?
Die erste Ebene stellt eine gemeinsame fachliche Basis her: wie generative Systeme grundsätzlich funktionieren, warum sie konfabulieren, wo Verzerrungen entstehen, in welchen Bereichen allgemeindidaktisch welche Chancen und Gefahren von genKI zu sehen sind. Das ist eine wichtige Voraussetzung, die man am besten im Kollegium – zumeist an einem oder mehreren Pädagogischen Tagen (mit schulinternen Folgeveranstaltungen) – angeht, die aber zugleich nur Voraussetzug für die eigentliche (didaktische) Unterrichtsentwicklung ist.
Die zweite Ebene ist die eigentliche Arbeit, die zumeist in die Fachschaften oder Jahrgangsteams (das hängt natürlich auch von der Schulform und dem jeweiligen Lernkonzept der Einzelschule ab) gehört. Denn was KI im Schreibprozess des Deutschunterrichts verändert, ist eine andere Frage als das, was sie in der Quellenarbeit des Geschichtsunterrichts oder im Beweisverständnis der Mathematik verändert. Diese Fragen lassen sich nicht zentral beantworten und sollten fachspezifisch angegangen werden.
Entscheidend ist dabei das Format: Lehrkräfte entwickeln gemeinsam Material, Aufgaben und Prüfungsformate, statt sich Anwendungsbeispiele vorführen zu lassen. Ein Vortrag über KI-Feedback erzeugt vielleicht Zustimmung und Motivation, aber keine veränderte Schulpraxis. Wie auch Eure Kolleginnen und Kollegen ganz einfach ins Arbeiten und Entwickeln neuer Aufgaben- und/oder Prüfungsformate kommen können, das zeige ich hier in Kürze mithilfe einer neuen Planungsmatrix, die auf der wunderbaren Vorlage von Manuel Flick (3×3-Matrix) aufbaut und diese didaktisch erweitert.
Zwei Stunden, in denen eine Fachschaft an eigenen Aufgaben, Prüfungsformaten und fachlichen Fragestellungen arbeitet, erzeugen beides – hier lohnt vielleicht ein Blick nach Singapur und auf die dortige Praxis.
Für die Rolle, die genKI im Unterricht bekommt, hat sich eine Unterscheidung bewährt, die ich in mehreren Artikeln ausführlicher beschrieben habe: KI als Tutor oder Sparringspartner, der eigenständiges Denken begleitet – und nicht als „false buddy“, der es abnimmt. Der Unterschied ist keinesfalls theoretischer Art: Ein kontrolliertes Feldexperiment mit rund tausend Schülerinnen und Schülern (Bastani u. a. 2024) zeigt beides in einer Studie: Der ungezügelte Zugang zur Antwortmaschine verbesserte die Leistung während der Nutzung und verschlechterte sie sich deutlich, sobald die technische Unterstützung wegfiel. Die als Tutor gestaltete Variante, die zum Mitdenken anhielt, zeigte diesen Effekt nicht. Dieselbe Technik, zwei Ergebnisse, und mal wieder die Erkenntnis: Die Mischung macht’s.
Ergebnis dieser Phase: erprobte, dokumentierte Methoden und/oder Materialien aus der eigenen Schule.
R – Reflektieren: Was tun unsere Schülerinnen und Schüler tatsächlich?
Letztlich sollte die relevante Prüfgröße im Verlauf eines solchen KURS-Zyklus weniger die Zufriedenheit des Kollegiums (die natürlich ebenfalls wichtig ist, bitte hier nicht falsch verstehen!) und auch nicht die Zahl der eingesetzten Tools sein, sondern die Veränderung im Lernprozess.
Die Unterscheidung, um die es hier geht, ist die zwischen Entlastung und Wirkung – auch das ein typisches Thema im Rahmen Pädagogischer Tage (wie in Málaga oder Berenbostel, zuletzt auch in Köln). Dass eine Lehrkraft schneller ggf. sogar besseres Material erstellt, ist ein echter Gewinn – aber das bedeutet noch keinen Lernzuwachs. Dass eine Schülerin schneller einen fertigen Text hat und ihn ggf. mit KI überarbeiten kann ebensowenig. Relevante Fragen, die in dieser Phase zielführend erscheinen, sind konkreter:
Nutzen die Lernenden das KI-Feedback, um ihren Entwurf zu überarbeiten, übernehmen sie es unkritisch oder nutzen sie es gar nicht?
Verstehen sie die Rückmeldung, die sie bekommen?
Motiviert die erhaltene Rückmeldung zur Weiterarbeit?
Verlagert sich die Denkarbeit auf die Maschine?
Diese Perspektive ist letztlich die des Angebots-Nutzungs-Modells, das ich hier kürzlich unter KI-Bedingungen beleuchtet habe: Es zählt nicht nur, was angeboten wird, sondern eben vor allem, was Lernende (in Mediationsprozessen) daraus machen. Sichtbar wird das nicht in Umfragen, sondern in Schülerprodukten, in Arbeits- und Lernprozessen, in kollegialer Hospitation und in gemeinsamer Auswertung.
An diese Stelle gehört u.a. auch die ethische Reflexion, aber eben nicht als nachgereichtes, isoliertes Modul, sondern gebunden an konkrete Entscheidungen über konkrete Werkzeuge in konkreten Klassen.
Ergebnis dieser Phase: eine begründete Entscheidung – beibehalten, verändern oder verwerfen?
S – Sichern: Was davon verfolgen wir im nächsten Schuljahr weiter?
Die vierte Phase ist die, die in der Praxis am häufigsten wegfällt oder in diffuses Weitermachen übergeht, dabei sollte die damit verbundene Frage nach dem „Wie weiter?“ ganz konkret besprochen werden. Sie umfasst dreierlei: die Überführung der Ergebnisse in verbindliche Vereinbarungen (Nutzungsregeln, Aufgaben- und Prüfungsformate, Kommunikation an Eltern und Lernende), die Ablage z.B. von Materialien an einem Ort, den auch neue Kolleginnen und Kollegen finden – und die strukturelle Verankerung des Formats selbst.
Das ist der unspektakulärste, aber vielleicht wichtigste Punkt: Termine im Jahresplan, benannte Verantwortliche, Zeitfenster, die nicht aus Restzeit bestehen, sondern von der Schule (im Rahmen ihrer Möglichkeiten) fest verankert werden. Diese Überlegungen wurden gerade diese Woche in Köln im Rahmen eines großen Pädagogischen Tages im Kontext der NRW-Oberstufenreform ganz konkret und, wie ich finde, von den Kollegien und Schulleitungen sehr bedacht als Jahresentwicklungsprozess eingeplant.
Zum Sichern gehört ausdrücklich auch das begründete Nein. Wenn sich zeigt, dass ein Vorhaben nichts bringt, ist das ein vollwertiges, dokumentiertes Ergebnis – es erspart anderen dieselbe Sackgasse. Ein Zyklus, der nur Zustimmung produzieren darf (z.B. auch, weil eine Plattform oder eine methodische Praxis bereits eingeführt worden ist), ist keine Reflexion, sondern eine Bestätigungsschleife.
Ergebnis dieser Phase: eine Struktur, in die der nächste Durchgang einsteigt.
Die Anpassung an die eigene Schule: 3I
Aus meiner eigenen Fortbildungspraxis ist mir natürlich auch klar, dass letztlich jede Schule individuell auf neue Herausforderungen im Rahmen ihres Schulprofils und ihrer Schulleitungs-Kollegiums-Konstellation reagiert. Daher soll KURS auch eher eine Struktur oder Denkvorlage anbieten, um aus dem diffusen Brainstorming, das genKI häufig in all ihren Facetten mit Blick auf Lernen und Lehren hervorruft, in konkrete Unterrichtsentwicklung zu kommen.
Der Punkt, an dem KURS dann schulspezifisch wird, ist die Anbindung an bzw. Integration in das, was ohnehin schon Entwicklungsziel oder Profil der Einzelschule ist. Dafür nutze ich seit einigen Jahren das 3I-Modell, das als Überbau mit Blick auf Schulleitungshandeln vielleicht helfen kann.
3I-Modell als Rahmen für Schulentwicklung (Hauke Pölert in Anlehnung an Dr. Catlin Tucker 2025)
Integration – in bestehende Schulinitiativen. Der Schwerpunkt des Zyklus wird nicht neu erfunden, sondern aus dem Leitbild und den laufenden Vorhaben abgeleitet. Arbeitet eine Schule an Feedbackkultur, ist KI-gestütztes Schreibfeedback der naheliegende Einstieg. Arbeitet sie an Differenzierung oder hat diesen Schwerpunkt z.B. als Auslandsschule sowieso durch ihr Schulprofil, sind es vielleicht adaptive Materialien. Das kann ein doppelter Vorteil sein: Das Kollegium erkennt die Anschlussfähigkeit, und KI wird nicht als zusätzliche Themenstellung gesehen, sondern als Hebel für etwas, das ohnehin auf der Agenda steht.
Investition – in Fortbildung, die auf das Schwerpunktthema zielt und nicht auf Tools. Nicht „Einführung in Tool X“, sondern „Wie geben wir in Klasse 9 besseres Feedback im Schreibprozess – und kann genKI dabei helfen?“
Innovationskultur – Freiräume zum Erproben, zum Scheitern, zum Verwerfen als Selbstverständlichkeit in der Schulpraxis. Diese sind ja letztlich auch Voraussetzung für die Phasen Reflektieren und Sichern, die Neugier und Motivation und gleichzeitig einen sicheren Rahmen für Scheitern und Korrektur bieten.
Beides baut also aufeinander auf: KURS ist der Prozess, 3I die grundlegende Haltung.
Verzahnung von Pädagogik und Technik
Ein verbreitetes Missverständnis sollte noch ausgeräumt werden, weil es die Arbeit erschwert. „Erst die Pädagogik, dann die Technik“ klingt vernünftig, ist wohl letztlich eine Überzeugung, die wir alle zunächst teilen, führt aber doch in die Irre. Denn der bekannte Slogan suggeriert, man könne didaktische Entscheidungen unabhängig von der digitalen Wirklichkeit treffen, in der Lernende längst leben und eben in der Schule auch lernen.
Näher an der Praxis ist für mich die Logik des hier bereits vorgestellten DPACK-Modells: Professionelles Handeln entsteht in der Verzahnung von pädagogischem Wissen, fachlichem Gehalt und Digitalität und nicht in deren Trennung oder Phasierung. Wer eine Schreibaufgabe für Klasse 10 plant, plant sie heute in einer Welt, in der ein Sprachmodell drei Klicks entfernt ist – das erfordert ganz neue Überlegungen auf allen Ebenen des Angebots-Nutzungs-Modells und geht weit über die einfache Aufgabenstellung hinaus (eines der Kernthemen eines guten Pädagogischen Tages zum Thema genKI).
Vom Entweder-Oder zum Sowohl-als-auch des DPACK-Modells (mehr dazu im Blogbeitrag zu DPACK)
Leitfrage in der Phase Klären wird dann eher: Was soll warum gelernt werden, was davon bleibt warum menschlich, und wie soll die Lernumgebung aussehen, in der das an unserer Schule stattfindet?
Von der Theorie in die Praxis auf 3 Ebenen – wo stehen wir gerade? 5 Dimensionen (Falck), AKTIV (Flick) und KURS (Pölert)
Ein solcher Zyklus, wie ich ihn mit KURS versuche zu skizzieren, sagt noch nichts darüber aus, wo eine Schule oder eine einzelne Lehrkraft auf dem Weg stehen. Dafür bietet sich beispielsweise das AKTIV-Framework von Manuel Flick an, das den Kompetenzaufbau in fünf aufeinander aufbauenden Schritten beschreibt: Ausprobieren und Anwenden, Kommunizieren und Klarheit schaffen, Transformieren von Lernprozessen, Integratives Prüfen und Bewerten, Verändern und Mitgestalten.
Poster-Vorschlag für das Kollegium: Zusammenspiel der Ebenen und Frameworks (Claude, prompted by Hauke Pölert 2026)
Beide greifen ineinander, weil sie verschiedene Fragen beantworten. AKTIV beantwortet „Wo stehen wir?“, KURS beantwortet „Wie gehen wir den nächsten Schritt?“ Auf jeder AKTIV-Stufe lässt sich ein KURS-Zyklus planen, denn eine Fachschaft, die noch beim Ausprobieren ist, wählt einen anderen Schwerpunkt aus als eine, die schon an Prüfungsformaten arbeitet – das Verfahren bleibt in beiden Fällen dasselbe.
Den Rahmen für beide bildet allerdings eine Unterscheidung, die ich in Fortbildungen inzwischen an den Anfang stelle und die auch in Málaga der Ausgangspunkt des Impulsvortrags war: die 5 Dimensionen „Lernen und KI“ (nach Joscha Falck) – Lernen mit, über, durch, trotz und ohne KI. Sie beantworten keine Prozessfrage, sondern eine wichtige, aber vorgelagerte inhaltliche Frage: In welchem Verhältnis kann und sollte Lernen zu KI stehen?
Schon an dieser Stelle entscheidet sich meiner Erfahrung nach, ob eine Diskussion im Kollegium in die Alles-oder-Nichts-Falle läuft („KI verbieten“ gegen „KI überall“ mal als hypothetische Polarisierung) oder ob sie differenziert geführt wird. Denn wer benennen kann, dass eine Aufgabe bewusst ohne KI angelegt ist, eine andere das Lernen über KI zum Gegenstand macht und eine dritte adaptive Unterstützung durch KI nutzt (oder im besten Fall diese Dimensionen in einem Lernprozess begründet kombiniert), diskutiert nicht mehr über KI an sich, sondern über einzelne didaktische Entscheidungen.
Damit ergibt sich eine Arbeitsteilung, die ich bewusst auch gar nicht größer machen will, als sie ist:
Die 5 Dimensionen liefern den handlungsleitenden Überbau und vor allem die präzise Sprache dafür.
AKTIV klärt, wo wir gerade in einem (langen und dynamischen) Entwicklungsprozess in Zeiten von KI stehen.
KURS klärt, wie wir den nächsten Schritt in diesem Prozess gehen.
Sowohl AKTIV als auch KURS bahnen also allein schon begrifflich die schulinterne Konkretisierung als Leitplanken für Schulleitung, Steuergruppe und Kollegium an – nicht mehr, aber eben auch nicht weniger. Die eigentliche Entscheidung, was in welchem Fach mit, über, durch, trotz oder ohne KI gelernt werden soll, nehmen sie genauso wenig ab wie die Frage, welche Schule genKI in welcher Form und in welchem Umfang für die Stärkung eigener Initiativen nutzt.
Wie könnte ein KURS-Zyklus im Schuljahr aussehen?
Das ist natürlich nur beispielhaft gedacht, aber so könnte in etwa ein Zyklus aussehen, bei dem ich mich jetzt am aktuellen Beispiel der Auslandsschule orientiere, diese Planung aber auch für meine eigene Schule gemeinsam mit der Steuergruppe überarbeite:
Vor den Sommerferien oder zum Schuljahresbeginn steht der gemeinsame Einstieg, wie z.B. ein Pädagogischer Tag wie in Málaga oder eine SchiLf (wie zuvor an der OBS Berenbostel). Ziel ist nicht, alles zu klären und bereits ganz konkret zu werden, sondern eine gemeinsame Ausgangsbasis zu schaffen und genug Erfahrung zusammenzutragen, sodass die Diskussion in der Folge konkret werden kann.
In den Wochen danach arbeitet z.B. die Steuergruppe die Phase Klären aus: Welcher Schwerpunkt? An welche laufende Initiative docken wir an? Wo steht das Kollegium? Im Optimalfall ist das Ergebnis dann nur eine kurze Bestandsaufnahme und kein neues Papier.
Im ersten Halbjahr liegt die Phase Umsetzen in den Fachschaften. Feste Termine, konkrete Produkte, ggf. moderierende Personen in den Teams.
Gegen Ende des ersten Halbjahres setzt Reflektieren ein: Hospitationen, gemeinsame Durchsicht von Schülerprodukten, ehrliche Bilanz – das dann im besten Fall wieder mit dem gesamten Kollegium und im fachlichen wie überfachlichen Austausch (so auch in Málaga für Januar 2027 geplant).
Vor den Sommerferien folgt Sichern: Was soll verbindlich werden, wo liegen die Materialien, welche Termine stehen schon für das nächste Jahr – und welchen Schwerpunkt wollen wir im nächsten neu oder weiterhin verfolgen?
Blick über den Tellerrand: Das PRISMA-Framework (Urban) – hier klicken für mehr Information
Wer sich in diesem Feld umschaut, könnte auch auf das PRISMA-Framework von Felix Urban, entwickelt am Carl-Fuhlrott-Gymnasium Wuppertal und im Januar 2026 mit dem KI-Schulpreis ausgezeichnet, stoßen. Die Gemeinsamkeiten von KURS und PRISMA sind sicherlich kein Zufall: Beide Modelle wehren sich gegen Technikgläubigkeit ebenso wie gegen den reinen Abwehrreflex, beide sind für einen Blick von der gesamten Schule bis zur einzelnen Stunde gedacht und begreifen Mehrwert als Hypothese, die erst durch Analyse beziehungsweise Reflexion zur Implementierung wird. Der Unterschied liegt im Zuschnitt: PRISMA ist ein Analysewerkzeug mit sechs Perspektiven – Potenziale, Risiken, Integration, Skills, Mehrwert, Analyse –, die bei jedem einzelnen Vorhaben gleichzeitig mitgedacht werden, wie durch ein Prisma betrachtet aus wechselnden Blickwinkeln. Das eignet sich hervorragend für die gründliche, mehrdimensionale Prüfung eines Vorhabens, gerade wenn eine KI-Koordination diese Analyse fachkundig verantwortet. AKTIV und KURS stellen dagegen die zwei oben beschriebenen Achsen dar: eine Reifegradachse, die zeigt, wo ein Kollegium oder eine Fachschaft im Entwicklungsprozess stehen, und ein Jahreszyklus mit fester Taktung, der einen Entwicklungsschwerpunkt mit vier Phasen in einem Schuljahr mit anschließender Neufokussierung für das nächste Schuljahr vorsieht.
Für die eigene Schule heißt das: Wer die analytische Tiefe pro Vorhaben in den Vordergrund stellen will und eine Person oder ein Team hat, das diese Analyse leisten kann und will, könnte mit PRISMA gut beraten sein. Wer eher einen verlässlichen, in den Jahresplan einbaubaren Rhythmus braucht, in dem auch ein weniger analytisch aufgestelltes Kollegium einen Anfang findet, kommt mit AKTIV und KURS wahrscheinlich leichter ins Arbeiten. So ist letztlich auch das KURS-Framework aus der Fortbildungspraxis heraus entstanden.
Beides schließt sich dabei nicht aus: PRISMAs sechs Perspektiven lassen sich ohne Weiteres als Prüfraster in die Phasen Klären und Reflektieren einziehen.
Fazit für heute: Was zu erproben wäre…
Der Gewinn eines solchen Zyklus für ein Kollegium oder eine Schule liegt weniger im Kompetenzzuwachs Einzelner als in dem, was die Bildungsforschung kollektive Wirksamkeitserwartung nennt: in der geteilten Überzeugung eines Kollegiums, gemeinsam etwas bewegen zu können und das dann auch anzugehen. Dafür bieten die 5 Dimensionen einen guten Ausgangspunkt, das KURS-Framework dagegen einen praxisnahen Einstieg mit klarem Fokus auf das schulintern Machbare und Gewünschte.
Dass ausgerechnet eine Technologie, die vor allem individuelle Arbeitserleichterung verspricht, den Anlass für eine solche kollektive Bewegung liefern könnte, empfinde ich durchaus als Ironie, zugleich ist das aber natürlich auch den enormen Herausforderungen geschuldet, denen sich (eigenständiges) menschliches Lernen gegenüber sieht.
Florian Nuxoll hat die Grundhaltung, um die es dabei geht, vor einiger Zeit treffend formuliert: „Wir brauchen mehr KI in der Schule, und wir brauchen weniger KI – wichtig ist, dass wir in beide Richtungen entschieden handeln.“ Genau das leistet ein Zyklus, der sowohl ein begründetes Ja als auch ein begründetes Nein gleichermaßen zulässt.
Und die Ausgangsthese gilt unverändert: Gute KI-Entwicklung an Schulen ist im Kern gute Unterrichtsentwicklung. Sie fragt nicht, welche Werkzeuge zur Verfügung stehen, sondern was Schülerinnen und Schüler lernen sollen – und was wir können müssen, damit das unter den heutigen Bedingungen gelingt. Dafür soll KURS ein Vorschlag sein, den wir sicherlich noch gemeinsam überarbeiten und integrieren werden.
Hier geht es zur übersichtlichen KURS-Website, die sich z.B. für Pädagogische Tage als Einführung und Arbeitsvorlage eignet.
Materialien für die Arbeit im Kollegium
Zum Framework gehören Arbeitsmaterialien, die alle derselben Logik folgen: ein Schwerpunkt, vier Phasen und die Möglichkeit schulinterner Anpassung und Überarbeitung.
Poster: KURS im Überblick
Poster: KURS im Kontext (5 Dimensionen / AKTIV / KURS)
Fachtabelle: Vorlage für die Arbeit in Fachschaften / Fachkonferenzen / Jahrgangsteams als Vorarbeit für das Medienkonzept
Planungsbogen für Steuergruppen – ein vollständigen KURS-Zyklus mit gezielten Fragen je Phase
In der KI-Infoecke vor meinem Büro hängen vier Poster – gut sichtbar sowohl für das Kollegium als auch für die Schülerinnen und Schüler der Oberstufe. Auf jedem Poster sind die Ergebnisse einer Studie zusammengefasst, die sich mit Lernen unter KI-Bedingungen befasst und von der ich denke, dass die Schulgemeinschaft sie kennen sollte. Klar ist: Jede Studie ist aus einem anderen Land, mit einem anderen Design, aus einer anderen Forschungslogik heraus entstanden – und mit jeweils ganz eigenen Limitierungen. Die Poster habe ich vor allem deshalb gestaltet, weil ich Kolleginnen und Kollegen etwas an die Hand geben wollte, das sich in zehn Minuten Pause erfassen lässt. Und natürlich auch, weil ich selbst sortieren musste, was da eigentlich gerade passiert – ein Poster ist da ähnlich hilfreich wie ein Blogbeitrag…
Infowand mit Studienpostern während eines Pädagogischen Tages (Pölert 2026)
Bei aller Freude über die entstehende Übersicht und die klar sichtbaren Implikationen wurde mir zugleich etwas unwohl: Denn mehrere Studienposter nebeneinander an einer Infowand, das mache ich auch gerne in Fortbildungen, erzeugen einen Eindruck von Gesamtevidenz, den keine der Studien jeweils für sich hergibt. Im Schulsystem könnte daraus evtl. sogar ein „Jetzt wissen wir es!“ entstehen. Genau davor möchte ich in diesem Beitrag warnen, und zugleich beschreiben, was sich meiner Ansicht nach eben doch an ersten Konturen abzeichnet.
Sehr dankbar bin ich für die Unterstützung von Dr. Benedikt Wisniewski, der sich sofort bereit erklärt hat, meine Einordnungen mit kurzen Videokommentaren aus seiner wissenschaftlichen Perspektive zu ergänzen. Benedikt ist promovierter Schulpsychologe, Supervisor und Coach. Er war lange als Lehrer und in der Lehrerbildung tätig und forschte zum Thema Feedback an der Universität Augsburg. Als Fachbuchautor und in seinem Podcast „Psychologie fürs Klassenzimmer“ beschäftigt er sich mit psychologischen Themen im Kontext Schule, moderiert aber auch gemeinsam mit Hendrik Haverkamp den Podcast „Kompass KI“, der aktuelle KI-Forschungsergebnisse für Lehrkräfte aufbereitet.
Vier Studien rund um Lernen und KI – China, Türkei und USA
Studie 1: The Generative AI Learning Penalty: Evidence from Chinese Secondary Education
Die erste Studie, Strömberg, Lei und Wu (2026), wertet 30 Monate Paneldaten von 26.811 Schülerinnen und Schülern der Klassen 7 bis 12 in einem Landkreis in Zentralchina aus. Über diesen Zeitraum stieg die selbstberichtete KI-Nutzung von nahezu null auf rund 80 Prozent. Das Ergebnis, das die Autoren „Learning Penalty“ nennen: Die Hausaufgabenleistung steigt um 18 Prozent, die Bearbeitungszeit sinkt um 30 Prozent, und in den monatlichen Klausuren ohne KI brechen die Leistungen um 20 Prozent ein. Bei den Abschlussprüfungen zeigt sich der volle Effekt erst nach etwa zwei Jahren. Die Autoren führen das auf ein Nutzungsmuster zurück, das sie „Homework Outsourcing“ nennen: sehr kurze Bearbeitungszeit bei gleichzeitig sehr guten Hausaufgabennoten, dann aber schwache Klausurergebnisse.
Kommentar von Benedikt Wisniewski zur Studie
Infoposter zur Studie
Studie 2: Generative AI Without Guardrails Can Harm Learning: Evidence from High School Mathematics
Die zweite Studie, Bastani et al. (2025), ist ein randomisiertes Feldexperiment mit knapp 1.000 Schülerinnen und Schülern der Klassen 9 bis 11 in der Türkei, veröffentlicht in PNAS. Drei Gruppen übten Mathematik: ohne KI, mit freiem GPT-4-Zugang und mit einem gemeinsam mit Lehrkräften entwickelten Tutor, der Hinweise statt Lösungen gibt. Die Übungsleistung stieg in beiden KI-Gruppen deutlich, beim Hinweis-Tutor sogar am stärksten. In der anschließenden Prüfung ohne KI schnitt aber nur die Gruppe mit freiem Zugang signifikant schlechter ab als die Kontrollgruppe. Beim Tutor mit Leitplanken verschwand dieser Effekt.
Kommentar von Benedikt Wisniewski zur Studie
Infoposter zur Studie
Studie 3: One Click Away: AI Tutoring with Khanmigo in a Two-Year School Experiment
Die dritte Studie, Oreopoulos et al. (2026), ist ein Feldexperiment mit über 6.000 Schülerinnen und Schülern der Klassen 6 bis 8 in Tennessee. Untersucht wurde unter anderem eine „Mastery“-Regel, bei der drei richtige Antworten in Folge nötig sind, bevor es weitergeht. Diese Regel erhöhte die Zahl derer, die solche Erfolgsserien erreichten, um 28,7 Prozentpunkte. Auf den Test eine Woche später hatte sie praktisch keinen Effekt. Der KI-Tutor wiederum verlangsamte das Üben, half aber dabei, nach Fehlern häufiger richtig weiterzumachen. Ein kleiner Lerneffekt zeigte sich nur in der Kombination beider Elemente, und auch der war nur knapp signifikant.
Kommentar von Benedikt Wisniewski zur Studie
Infoposter zur Studie
Hintergrund-Studie 4: AI tutoring outperforms in-class active learning: an RCT introducing a novel research-based design in an authentic educational setting
Die vierte Studie, Kestin et al. (2025), weist in eine andere Richtung als die ersten drei. Sie erschien in Scientific Reports und untersucht 194 Studierende in Harvards großem Einführungskurs Physik im Herbst 2023. Das Design ist ein randomisiertes Crossover: Dieselben Studierenden erlebten in zwei aufeinanderfolgenden Wochen beide Bedingungen, einmal eine nach allen Regeln der Kunst gestaltete aktivierende Präsenzstunde, einmal eine Lerneinheit mit einem eigens entwickelten KI-Tutor. Die Studierenden lernten mit dem KI-Tutor etwa doppelt so viel, und das in kürzerer Zeit. Sie fühlten sich zudem motivierter und stärker eingebunden. Der Vergleichsmaßstab war dabei nicht der schlechte Frontalunterricht, sondern aktivierendes Lehren, also ein hoher Standard.
Infoposter zur Studie
Vier so eng zugeschnittene Interventionsstudien würden wohl eher Randnotizen bleiben, träfen sie nicht auf den aktuellen KI-Hype und eine hoch angespannte Lage im Bildungssystem. Die in dieser Woche veröffentlichten PISA-2025-Ergebnisse für Deutschland zeigen, dass die Hälfte der Fünfzehnjährigen mindestens wöchentlich KI-Chatbots zum Lernen nutzt, der OECD-Schnitt liegt bei 46 Prozent. Fragt man nicht nach Frequenz, sondern schlicht danach, ob überhaupt genutzt wird, ändert sich das Bild noch deutlicher: Nur 9 Prozent der befragten Jugendlichen geben an, KI nie oder fast nie für Schulaufgaben einzusetzen, umgekehrt gerechnet also rund 91 Prozent zumindest gelegentliche Nutzung, ziemlich genau der Wert, den auch die JIM-Studie 2025 für die 12- bis 19-Jährigen insgesamt findet. So unterschiedlich die Frageformulierungen der einzelnen Jugendstudien im Detail auch ausfallen, in der Größenordnung sind sich PISA und JIM hier einig: KI-Nutzung im schulischen Kontext ist für die meisten Jugendlichen längst Alltag, nicht Ausnahme, und das bei einer Geschwindigkeit der Verbreitung, die selbst innerhalb eines Jahres auffällt, allein die JIM-Zeitreihe zur Grundnutzung steigt von 62 auf 91 Prozent.
Vier Studien mit ganz eigenen Limitierungen
Zwei der vier Arbeiten sind Preprints. Die China-Studie liegt als SSRN-Paper vor, die Tennessee-Studie als NBER Working Paper. Beide haben also kein Peer-Review durchlaufen, was einen erheblichen Vorbehalt darstellt. Working Paper werden auf ihrem Weg zur Publikation regelmäßig korrigiert, in ihren Effektstärken relativiert oder in ihrer Analysestrategie in Frage gestellt. Wer sie zitiert, zitiert einen Zwischenstand – da sollten wir ganz vorsichtig sein. Und weitere Punkte sprechen für Vorsicht:
Bei der China-Studie von Strömberg, Lei und Wu (2026) kommt hinzu, dass der Zeitpunkt der ersten KI-Nutzung auf Selbstauskunft beruht, dass es sich um einen einzelnen „Landkreis“ handelt und dass die eindrucksvoll wirkenden Standardabweichungen teilweise ein Rechenartefakt der Mittelung über viele Fächer sind. Der Zusammenhang zwischen Hausaufgabenzeit und Klausurleistung, der die zentrale Erklärung stützt, ist zudem (wie so oft) korrelativ und nicht kausal belegt.
Bei der Tennessee-Studie ist das zentrale Lernergebnis mit einem p-Wert um 0,065 nur knapp signifikant, der Test umfasste vier Fragen, und die Messung erfolgte eine Woche später.
Die beiden peer-reviewten Arbeiten sind methodisch stärker und dafür in ihrer Reichweite aber noch limitierter:
Bastani et al. betrifft nur Mathematik, nur vier Sitzungen und nur eine einzige Schule.
Für Kestin et al. gelten Einschränkungen, die man beim Lesen unbedingt im Hinterkopf haben muss – deshalb ist die Studie hier auch nur als Exkurs / Rückblick aufgrund ihrer teils unkritisch positiven Rezeption mit aufgeführt:
194 Harvard-Studierende sind eine hochselektive und ausgesprochen lernmotivierte Gruppe,
es ging um zwei einzelne Lerneinheiten eines Physikkurses, und
der Test erfolgte direkt im Anschluss.
Über Lernleistung nach Wochen oder Monaten sagt die Studie nichts.
Der eingesetzte Tutor war zudem kein Standard-Chatbot, sondern ein von Fachdidaktikerinnen und Fachdidaktikern aufwendig entwickeltes System mit hinterlegten Denkschritten, Vorgaben zur Gesprächsführung und Sicherungen gegen falsche Auskünfte.
Und die Bedingungen unterschieden sich nicht nur in der Methode: Die Präsenzstunde fand im Hörsaal statt, die KI-Einheit zu Hause.
Alle vier Studien stellen also enge Ausschnitte dar und keine davon misst wirklich in der Gesamtheit, was uns alle umtreibt oder was sich in der Gesamtschau als Eindruck ergeben könnte: Nämlich was mit Bildungsprozessen über Jahre hinweg passiert, wenn generative KI selbstverständlicher Teil des Alltags von Lernenden ist.
KI-Studien und confirmation bias
Studien wie diese finde ich natürlich nicht zufällig, sondern, weil sie zu meinen subjektiven Eindrücken und Erfahrungen passen und weil sie in meiner Peer-Group (gerade bei LinkedIn) präsentiert und diskutiert werden. Wer seit Jahren über Aufgabenkultur und Eigenständigkeit schreibt, für den ist eine Studie mit dem Titel „The Generative AI Learning Penalty“ ein passender Mosaikstein: Die Ergebnisse bestätigen (jetzt endlich auch evident!), was man im Unterricht zu beobachten glaubt (confirmation bias).
Und wer auf Basis dieser Studien direkt mit der Negativ-Interpretation à la „KI schadet dem Lernen!“ beginnt, bedenkt nicht: Auch die Bastani-Studie ist zur Hälfte ein eigentlich positiver Befund, was in der öffentlichen Rezeption regelmäßig untergeht. Denn der KI-Tutor mit Leitplanken hat die Übungsleistung am stärksten gesteigert, ohne dabei dem Lernen zu schaden. Der Titel enthält nicht ohne Grund die in meinen Augen ganz wichtige Einschränkung „Without Guardrails“. Dass Kestin et al. hier trotz der klaren Limitierungen mit dabei sind, ist mir aus eben diesem Grund wichtig, denn ohne diese Arbeit ließe sich aus den anderen drei eine (Negativ-)Erzählung stricken, die so nicht begründet ist.
Dazu kommt ein Publikationsmechanismus, der in beide Richtungen wirkt. Aufsehenerregende Negativbefunde werden derzeit sehr schnell und sehr breit geteilt, gerade in einem Bildungsdiskurs, der Bestätigung für seine Skepsis sucht (denken wir nur an „Your Brain on ChatGPT“). Zugleich hat die Ed-Tech-Branche jahrelang jede kleine positive Effektstärke zum Durchbruch erklärt, und die Harvard-Studie wird genau dafür seit einiger Zeit verwendet, meist ohne die genannten Einschränkungen zumindest zu erwähnen.
Was sich trotzdem als „Konturen“ abzuzeichnen beginnt
Warum dann überhaupt dieser Beitrag? Einmal, weil ich gemeinsam mit Joscha Falck einen Beitrag für das FelloFish-KI-Forum vorbereite und wir diese Studien und ihre Implikationen in den Blick nehmen wollen. Und weil ich sehr dafür plädiere, im Bildungsdiskurs zwischen „Evidenz“ und „Kontur“ zu unterscheiden. An diesen vier Studien finde ich spannend, dass sie aus völlig unterschiedlichen Settings, mit unterschiedlichen Methoden und unterschiedlichen Erkenntnisinteressen in unterschiedlichen Ländern auf ähnliche Muster stoßen, die dann auch noch ziemlich genau dem entsprechen, was viele von uns im Unterricht ohnehin beobachten. Diese Kombination aus schwacher Einzelevidenz und starker Alltagsresonanz bietet keine Gewissheit, aber erste Anhaltspunkte. Konturen eben, die sich abzuzeichnen beginnen.
Für mich zeichnen sich momentan mit Blick auf Lernen und KI drei Konturen aus diesen Studien ab:
Kontur 1: Sichtbarer Fortschritt und tatsächliches Lernen entkoppeln sich
In den ersten drei Studien steigt jeweils ein Wert, der im Schulalltag als Erfolg gilt, während der eigentliche Lernstand stagniert oder fällt. In China ist es die Hausaufgabennote, bei Bastani die Übungsleistung, in Tennessee die Erfolgsserie (bemerkenswert ist dabei, dass die Mastery-Regel gar keine KI-Intervention ist). Das Auseinanderfallen von Fortschrittsanzeige und Lernstand ist also kein KI-Problem, sondern ein älteres didaktisches Problem, das durch KI nur sehr viel schneller und sehr viel schwieriger zu trennen wird. Bei Kestin fielen Erleben und Ertrag dagegen zusammen, die Studierenden fühlten sich mit KI-Tutor motivierter und lernten anscheinend mehr. Dass diese Entkopplung kein Ergebnis kleiner Stichproben ist, bestätigt sich in der PISA-Erhebung auf einer ganz anderen Ebene: Wer KI nie oder fast nie für konkrete Schulaufgaben nutzt, schneidet im Mittel am besten ab, während diejenigen, die KI wöchentlich für allgemeine Zwecke einsetzen, ähnliche Ergebnisse erzielen wie Nichtnutzende. Die OECD selbst beschreibt diesen Zusammenhang als komplex, und das trifft den Stand der Dinge ziemlich gut: Es ist nicht die Nutzung an sich, die über den Lernerfolg entscheidet, sondern was dabei getan wird, und daran ändert eine Stichprobe von 700.000 Jugendlichen gegenüber einer Stichprobe von 26.811 wie in China erstmal wenig.
Für die Praxis heißt das vor allem: Jede Rückmeldung, die auf einem Produkt beruht, das außerhalb unserer Wahrnehmung entstanden ist, verliert an diagnostischem Wert.
Kontur 2: Nicht das Sprachmodell oder Tool entscheidet, sondern die Gestaltung der Nutzung
Bastani zeigt Lern-Unterschiede innerhalb desselben Modells, Kestin zeigt, was passieren kann, wenn dieselbe Technologie konsequent nach fachdidaktischen Prinzipien konzipiert wird. Die China-Studie dagegen kommt aus einer anderen Richtung zum selben Ergebnis: Lernende, die trotz KI-Nutzung ähnlich viel Zeit in ihre Hausaufgaben investierten, hatten kaum Lernverluste.
Ich habe hier im Blog schon mehrfach mit dem Angebots-Nutzungs-Modell argumentiert, weil ein Großteil unserer Debatte auf der Angebotsseite stehenzubleiben scheint. Diese Befunde verschieben den Blick aber in die mindestens genauso wichtige Richtung, nämlich auf die Nutzungsseite. Und sie zeigen zugleich, dass die Angebotsseite dabei nicht verschwindet: Der Kestin-Tutor ist ein Angebot, das die Nutzung von vornherein in eine bestimmte Richtung lenkt.
Kontur 3: KI verstärkt die vorhandene pädagogische Ausrichtung (Verstärker-These)
In der Tennessee-Studie zeigte der KI-Tutor allein kaum Wirkung, erst eingebettet in eine Struktur, in der Fehler Konsequenzen haben (Mastery-Regel), entstand ein Effekt. Umgekehrt entfaltet freier Zugang ohne jede Rahmung sein Schadenspotenzial genau dort, wo ohnehin ergebnisorientiert und nicht prozessorientiert gearbeitet wird (Stichwort: „Skill-Skipping“ und „Deskilling“). Kestin ist dann eher der Beleg aus entgegengesetzter Perspektive: Dort stand hinter der Plattform ein Team, das seine Fachdidaktik bereits sehr genau durchdacht hatte, und die KI dafür gezielt nutzte. Jöran Muuß-Merholz‘ Formel vom „großen Verstärker“, die ich in meinem Beitrag zur Renaissance des Menschlichen aufgegriffen habe, findet hier eine empirische Entsprechung. Eine Schule, die Lernen bereits auf Produktabgabe reduziert hat, wird mit KI vor allem effizienter reduzieren.
Eine vierte Beobachtung will ich vorsichtiger formulieren, weil sie stärker interpretiert als belegt ist: Auffällig ist, wer in diesen Studien jeweils die Gestaltungsarbeit leistet. Bei Kestin und beim Bastani-Tutor waren es Lehrende und Fachdidaktikerinnen und Fachdidaktiker, die die Leitplanken vorab eingebaut haben. In der China-Studie wurden die Lernenden dagegen mit allgemein verfügbaren Tools allein gelassen. Der Unterschied im Ergebnis scheint mir doch ziemlich genau mit diesem Unterschied zusammenzufallen.
Das spricht dafür, die Verantwortung für gute KI-Nutzung in diesem Kontext zunächst bei uns als Lehrpersonen zu verorten und nicht bei den Lernenden. Auch das lässt sich an der aktuellen PISA-Erhebung ablesen, nur eine Ebene höher: Etwas bessere Leistungen zeigen sich dort, wo häufige KI-Nutzung mit Gelegenheiten einhergeht, KI-Kompetenzen systematisch aufzubauen. Solche Gelegenheiten kommen aber überproportional sozioökonomisch begünstigten Jugendlichen zugute, wie die OECD selbst anmerkt, mit der Folge, dass sich die KI-Kluft eher vergrößern als schließen könnte. Wenn die Gestaltungsarbeit ausbleibt, wird sie sich also wohl eher entlang bestehender Ungleichheiten verteilen und diese im schlimmsten Fall sogar verstärken („AI Divide“).
Was das für Unterricht und Schulentwicklung bedeutet
Die naheliegende Konsequenz aus einem Befund wie dem der China-Studie wäre, Hausaufgaben abzuschaffen oder KI zu verbieten. Beides halte ich in seiner Absolutheit für falsch, und zwar nicht aus Prinzip, sondern weil die Studien selbst diese Schlussfolgerung gar nicht hergeben. Spätestens mit der Harvard-Studie ist die Verbotsposition auch empirisch schwer zu halten.
Aus meiner Sicht folgen daraus fünf Ansatzpunkte, die ich kürzlich auch schonmal bei Instagram versucht hatte herauszuarbeiten:
Übungszeit schützen, statt Tools zu verbieten
Der gemeinsame Nenner der kritischen Befunde ist nicht, dass KI per se schlecht ist, sondern dass die kognitive Anstrengung, die Lernen erzeugt, umgangen wird. Bei Kestin wurde diese Anstrengung nicht umgangen, sondern gezielt herbeigeführt, nur eben effizienter. Anstrengung braucht Zeit und einen Ort. Wenn das z.B. die Hausaufgabe in ihrer üblichen Form nicht mehr zuverlässig sein kann, muss diese Phase im Unterricht liegen oder muss eine Übungsaufgabe anders gestaltet werden (Darstellung / Aufgabe / Rahmenbedingungen – siehe Manuel Flicks hilfreicher Vorschlag).
Den Prozess sichtbar machen, nicht nur das Produkt bewerten
Das ist keine neue Forderung, aber sie wird durch diese Befunde natürlich verstärkt. Im gemeinsam Gerold Brägger und Joscha Falck entwickelten Modell zum eigenständigen Schreiben unter KI-Bedingungen haben wir versucht zu beschreiben, wie das konkret aussehen kann, wenn jede Phase mit eigenständiger Arbeit beginnt und KI subsidiär mitgedacht wird. Dieser Grundgedanke lässt sich auf viele Fächer übertragen.
Prompts und Tools als didaktisches Material behandeln
Wenn der Unterschied zwischen „learning penalty“ und deutlichem Lernertrag in der Gestaltung der KI-Interaktion im Lernprozess liegt, dann ist ein Prompt oder ein eingeführtes Tutor-/Feedbacksystem eben kein technisches Detail, sondern Lernmaterial. Für Fachschaften könnte das im Sinne professionellen Lernens z.B. heißen: gemeinsam entwickeln, teilen, überarbeiten, ähnlich wie bei Aufgaben oder Klausurentwürfen. Eine einzelne Lehrkraft wird kein System konzipieren wie das Harvard-Team, eine Fachschaft kann aber sehr wohl eine brauchbare Fassung für ein wiederkehrendes Thema erarbeiten und diese dann gemeinsam mit den Lernenden weiterentwickeln (was auch Werkstatt-Projekte an zahlreichen Schulen zeigen).
Aufklärung: Über die Kosten der Abkürzung („learning penalty“) sprechen
Die Studien legen nahe, dass Lernende den Zusammenhang zwischen leichter Bearbeitung und schwächerem Lernen selbst (zunächst) nicht herstellen. Das lässt sich thematisieren, und zwar nicht als Ermahnung, sondern als gemeinsame Auswertung. Eine Klausur ohne KI nach einer Übungsphase mit KI ist dafür ein brauchbarer Anlass, wenn man den Vergleich anschließend auch bespricht. Zudem gilt unverändert mein Plädoyer und ganz praktischer Versuch, in wirklich jeder Unterrichtsstunde in irgendeiner Form über und ggf. auch mit KI zu arbeiten und zu sprechen.
Unsere Erfolgsanzeigen selbst prüfen
Der Tennessee-Befund rückt auch eine Perspektive in den Blick, die wir selten berücksichtigen, nämlich die Erfolgs-Metriken, die unsere Lernplattformen, Materialien, aber auch unsere Bewertungssysteme im Unterricht ausgeben. Wenn eine Erfolgsserie im Lern-System (Kahoot sei als extremstes Beispiel genannt) wenig bis nichts über den Lernstand aussagt, ist das System nicht neutral, sondern irreführend, für Lernende wie für uns. Ähnliches gilt inzwischen wohl auch für die „sonstige Mitarbeit“, wenn sie unverändert ausschließlich die „mündliche Leistung“ umfasst.
Auf der Ebene der Schulentwicklung heißt das wohl vor allem, den Diskurs nicht auf der Tool-Ebene zu führen. Wie wichtig hier das Zusammenwirken als Schulgemeinschaft ist, zeigt auch ein Blick ins Lehrerzimmer: Während annähernd jede zweite Schülerin und jeder zweite Schüler KI inzwischen wöchentlich zum Lernen nutzt, geben im Deutschen Schulbarometer erst 19 Prozent der Lehrkräfte an, KI mehrmals wöchentlich beruflich einzusetzen, ein Anteil, der sich gegenüber dem Vorjahreswert von 9 Prozent zwar mehr als verdoppelt hat, die Kompetenzlücke zwischen Klassenraum und Lehrerzimmer damit aber eher sichtbar macht als schließt. Ich habe an anderer Stelle beschrieben, warum Fortbildung und Schulentwicklung zusammengehören und warum Impulse ohne strukturelle Verankerung verpuffen.
Die vier Studien liefern dafür ein zusätzliches Argument, weil keine der ableitbaren Konsequenzen sich in einer Tool-Schulung unterbringen lässt. Sie betreffen Aufgabenkultur (Stichwort: „guardrails“ bei Bastani), Prüfungskultur und die Frage, worüber wir mit Lernenden eigentlich in welcher Form sprechen. Wer hier ansetzen will, braucht eben keine neuen Plattformen, sondern ein gemeinsames Verständnis darüber, wo im Lernprozess eigenständige Denk-/Übungs- und damit Lernzeit stattfindet und wie sich diese schützen und unterstützen lässt.
Für den Einstieg in einen solchen Prozess mit Schülerinnen und Schülern habe ich basierend auf der Arbeit von Manuel Flick ein Konzept in sechs Schritten als Projekttag skizziert, für die Fachschaftsarbeit wird hier in Kürze ein Prozessvorschlag folgen und mit Blick auf systematischen Aufgaben-Remix sind aus einer aktuellen Fortbildung neue Ideen entstanden…bald mehr dazu…
Fazit
Vier Studien sind keine Evidenzlage. Zwei davon sind Preprints, alle vier sind schmale Ausschnitte aus sehr spezifischen Kontexten. Wer sie als Beleg dafür nimmt, dass KI per se dem Lernen schadet, liest sie falsch – und wer meint, aus der Harvard-Studie ablesen zu müssen, dass KI „das Lernen verdoppelt“, liest diese Studie nicht weniger falsch.
Sehr wohl bleiben aber sich abzeichnende Konturen – auch wenn alle Poster nebeneinander hängen: Sichtbarer Fortschritt und tatsächliches Lernen fallen unter KI-Bedingungen leichter auseinander als zuvor. Die Gestaltung der Nutzung entscheidet stärker über den Ertrag als das Tool an sich, und diese Gestaltungsarbeit liegt momentan in erster Linie bei uns Lehrpersonen im Zusammenspiel mit der ganzen Schulgemeinschaft. Diese Konturen sind nicht bewiesen, werden aber mit Blick auf die Studienergebnisse plausibel, und treffen in dieser Woche auf die PISA-Ergebnisse, die dieselbe Grundspannung noch einmal in großem Maßstab bestätigen. Für schulische Entwicklungsarbeit ist das in meinen Augen schon genug, solange wir den Unterschied zwischen Evidenz und Kontur nicht aus den Augen verlieren und verwischen.
Besonders dankbar bin ich dabei Benedikt Wisniewski für seine differenzierten Kurzanalysen zu den drei aktuell relevanten Studien und damit insbesondere für einen momentan besonders wichtigen Aspekt: Rückversicherung, ob wir als „einfache“ Lehrpersonen mit unseren Annahmen wirklich richtig liegen. Ich denke, Benedikts Einschätzungen bestätigen die vorsichtig weiter zu verfolgende Linie, die sich aus den Konturen dieser Studien ergibt: Aufklären, Ausprobieren, Aktiv werden – aber mit klaren Leitplanken.
Mir ist dabei am wichtigsten, dass wir uns die Fähigkeit erhalten, unsere eigenen Annahmen zu prüfen. Das ist im Übrigen genau die Kompetenz, die wir bei unseren Schülerinnen und Schülern im Umgang mit generativer KI ja irgendwie voraussetzen.
Verwendete Quellen
Strömberg, D., Lei, V. & Wu, Y. (2026): The Generative AI Learning Penalty: Evidence from Chinese Secondary Education. SSRN Working Paper 6868618.
Bastani, H., Bastani, O., Sungu, A., Ge, H., Kabakcı, Ö. & Mariman, R. (2025): Generative AI Without Guardrails Can Harm Learning: Evidence from High School Mathematics. PNAS 122(26): e2422633122.
Oreopoulos, P., Liut, M., Sungu, A. & Low, H. (2026): Making AI Tutoring Productive: Evidence from a Mastery-Based Math Practice Experiment. NBER Working Paper 35621.
Kestin, G., Miller, K., Klales, A., Milbourne, T. & Ponti, G. (2025): AI tutoring outperforms in-class active learning: an RCT introducing a novel research-based design in an authentic educational setting. Scientific Reports 15: 17458.
OECD (2026): PISA 2025 Ergebnisse, Band I – Ländernotiz Deutschland.
Heute habe ich an der SIKJM-Jahrestagung übers Schreiben mit Schüler:innen gesprochen. Vorangestellt habe ich die Bemerkung, dass ich hier im Blog zunehmend ins Leere schreibe – Resonanz erzeugen primär meine Videos, nicht meine aufwendigeren, differenzierteren Texte. Christoph Engemann hat dafür in der Keynote den Begriff Plattform-Oralität aus seinem Buch «Zukunft des Lesens» vorgestellt, der genau dieses Phänomen erfassen kann: Mündliche Rede erhält mehr Gewicht, kann durchsucht und adressiert werden – ist aber ökonomisch durch die Logik der Plattformen bestimmt. Meine Videos funktionieren nur, wenn TikTok und Instagram sie ausspielen. Mein Blog ist davon unabhängig.
Vibe Writing bezeichnet eine Schreibpraxis, bei der die schreibende Person nicht mehr formuliert, sondern eine LLM-KI dazu anleitet: Sie gibt Prompts vor, bewertet Ergebnisse, lässt sie ändern – sie hängt aber nicht selber Buchstaben an Buchstaben, Wort an Wort, Satz an Satz. Diese Praxis ist weit verbreitet.
Zunächst muss man sie nicht bewerten – es gibt Menschen, die Texte so herstellen, wahrscheinlich immer mehr. Wenn man sich auf Vibe Coding bezieht, also die Co-Kreation von Programmen mit einer KI, die den ganzen Programmiercode nach Vorgaben von Menschen schreibt, dann könnte man sich fragen, ob Menschen überhaupt noch programmieren bzw. schreiben lernen müssen. Diese Frage lasse ich offen, sie passt in einen Katalog von Unsicherheiten, bei denen ich keine sicheren Antworten kenne.
Prozess oder Produkt?
Die Schreibdidaktik weist seit Jahrzehnten darauf hin, dass schulisches Schreiben mehr Aufmerksamkeit auf Schreibprozesse und weniger auf konkrete Produkte legen sollte. Vereinfacht könnte man folgende Faustregel formulieren:
Wer ein möglichst gutes Textprodukt herstellen möchte, sollte Vibe Writing mit einer KI betreiben. Wer sein Schreiben entwickeln möchte, muss bewusste Schreibprozesse ohne KI durchlaufen.
Beim schulischen Schreiben lassen sich Produkt- und Prozessebene oft nicht so schön trennen, wie das in der Theorie sinnvoll erschiene. Warum? Erstens fehlen die Ressourcen, um Schreibprozesse intensiv begleiten zu können. 1:1-Schreibtraining kann ich als Deutschlehrer vielleicht mit maximal 5 Schüler:innen gleichzeitig betreiben – in meinen Schulzimmern befinden sich aber über 25 Lernende. Zweitens müssen viele Lehrpersonen die Arbeiten von Schüler:innen bewerten. Weil sie keinen direkten Zugriff auf die Prozessqualität haben, hängt ihre Beurteilung vom Textprodukt ab. (Das passiert in der schulischen Beurteilungspraxis generell zu oft: Aufgrund von schriftlichen Texten werden unzulässige Rückschlüsse auf kognitive Kompetenzen gezogen.)
Sobald Produkte in der Schule wichtig werden, wird es für Lernende sehr attraktiv, Vibe Writing (oder Vibe Thinking) mit einer KI zu betreiben, weil sie so in vielen Fällen schneller zu besseren Ergebnissen kommen.
Wie sieht ein Schreibprozess aus?
Sehr kompliziert. Die Abbildung zeigt das überarbeitete Modell von Hayes in einer Version von 2014. Was wir umgangssprachlich Schreibprozess nennen, umfasst drei Ebenen, von denen wiederum eine die Prozessebene ist, die auf verschiedene Ressourcen zugreift und kontrolliert wird.
Im schulischen Schreiben meinen wir damit etwas anderes, nämlich eine didaktische Strukturierung in Arbeitsphasen. Wenn Lehrkräfte hier sinnvolle Methoden einsetzen, dann reflektieren und üben Schüler:innen beim Durchlaufen dieser Phasen wichtige Prozesselemente des Schreibens (ihre Schreibfähigkeit verbessert sich). Hier eine einfache Darstellung dieser Phasen (Grafik mit ChatGPT erstellt):
Für unser Thema können einige erste Grundeinsichten formuliert werden:
Guter Schreibunterricht schafft ein Bewusstsein für den Schreibprozess.
Im Schreibunterricht sollten die Phasen bewusst getrennt werden, so dass bei Schüler:innen ein Bewusstsein dafür entsteht.
KI-Tools dürfen innerhalb eines Prozessschrittes eingesetzt werden, aber
KI-Tools dürfen nicht benutzt werden, um Prozessschritte zu überspringen.
Vibe Writing geht mit 3. und 4. nicht mehr. Das lässt sich didaktisch gut begründen: Schüler:innen schreiben, weil sie lernen, später besser zu schreiben. Und nicht, weil sie Texte herstellen, die möglichst genau bestimmten Vorgaben entsprechen. Das kann eine Maschine besser.
Das ist eine oft harte (und für einige Lehrpersonen nicht ganz leicht umsetzbare) Einsicht: Schüler:innen sollen also Texte nicht zusammenfassen, um eine möglichst gute Zusammenfassung zu schreiben, sondern um Prozesse zu durchlaufen, die ihnen helfen, später besser lesen und schreiben zu können. Genauso wie ich nicht Tennis spiele, damit ein möglichst gutes Tennis-Spiel stattfindet (das gibt es auf YouTube), sondern damit ich Spass am Sport habe und beweglich bleibe oder werde.
Die Fachkompetenzschwelle
An dieser Stelle sei noch einmal auf die Fachkompetenzschwelle verwiesen. Im ausführlicheren Beitrag dazu habe ich auf die Darstellung von Dominic Hassler verwiesen, aus der deutlich wird: Schüler:innen verbringen in der Schule viel Zeit mit Dingen, die die KI besser kann. Wir müssen ihnen dabei helfen, den Reflex, deswegen zur KI zu greifen, zu unterdrücken.
Gute Schreibprompts und gute KI-Prompts
Der Begriff Prompt meint sinnigerweise zwei Aufforderungen: Die Schreibaufgabe, welche eine Lehrperson schreibenden Schüler:innen stellt – und die Eingabeaufforderung, mit der eine KI-Nutzerin ein LLM dazu auffordert, einen bestimmten Text zu generieren.
Gestern habe ich die Teilnehmer:innen an meinem Workshop aufgefordert, 5 Sätze zu folgendem Thema zu schreiben: «Die Stadt Zürich und ich.»
Diese Schreibaufgabe scheint zunächst KI-resistent zu sein: Was weiss eine KI schon über mein Verhältnis zur Stadt Zürich? Hier muss ich mich ausdrücken, meine Emotionen, Erlebnisse und Meinungen formulieren. Das scheint auf den ersten Blick klug. In der Diskussion im Workshop haben sich aber bei mir zwei Bedenken eingestellt:
Wir reduzieren Schreibaufgaben so auf den Ausdruck von Innerlichkeit und Subjektivem. Schreiben kann aber so viel mehr sein – warum sollte man sich durch KI einschränken lassen bei der Wahl von Schreibaufgaben?
Wer Modelle wie Claude intensiv mit eigenen Arbeiten füttert (ich mache das zum Beispiel), kann problemlos auch solche Texte generieren.
Hier sind wir an einem Punkt, an dem der KI-Einsatz irgendwie auch unheimlich wird: Menschen fällt es oft schwer, ihre Gedanken sprachlich auf den Punkt zu bringen. Wenn sie Maschinen dazu auffordern, das zu tun, dann wird etwas leichter, was wohl nicht leicht sein sollte. Mein Ringen mit der Sprache ist ein Ringen mit mir und den Verhältnissen und Beziehungen, in denen ich lebe. Mich verständlich zu machen ist eine zutiefst menschliche Aufgabe, die nicht leichter gemacht werden sollte – wie Babys keine Gehhilfe brauchen, wenn sie laufen lernen. Das muss für sie schwierig sein.
Noch eine weitere Bemerkung: Wer eine Schreibaufgabe gibt, müsste eigentlich am Text interessiert sein. Wenn ich einen Brief schreibe, dann fordere ich den Adressaten auf, mir bestimmte Dinge mitzuteilen. Das wäre ein quasi natürlicher Schreibprompt. Nur: Lehrpersonen sind oft nur an wenigen Texten aus einer Klasse interessiert. Wie müsste eine Aufgabe lauten, bei der mich alle Antworten in einer Klasse interessieren? Und wäre das dann nicht wieder eine subjektorientierte? Viele offene Fragen.
Dafür habe ich aber zu Prompts ebenfalls einige Grundeinsichten formuliert:
Schreibprompts können Anregungen für jede Stufe des Schreibprozesses enthalten. (Auch mehrteilige Prompts für jede Schreibphase sind oft sinnvoll.)
Schreibprompts sind Teil von pädagogischer Beziehungsarbeit.
Gute Schreibprompts dürfen nicht 1:1 als KI-Prompts verwendet werden.
Gute KI-Prompts sind auf die Prozessstufe bezogen: «Bitte gib mir Feedback zu meinem Text. Wichtig ist mir besonders, ob verständlich wird…»
KI-Prompts sind keine Zaubersprüche («Boomer-Prompts»). Es ist sinnvoll, eine bewusste Interaktion mit einer KI zu pflegen, die Ergebnisse genau zu lesen, Änderungswünsche zu formulieren etc. Die Interaktion löst Probleme besser als ein riesiger Prompt zu Beginn, der alle Fallen voraussieht.
Vertrauen in die eigene Schreibstimme finden
Erwachsene überschätzen in vielen Bereichen das Selbstvertrauen von Jugendlichen. Besonders beim Schreiben ist der ChatGPT-Reflex auch Ausdruck von Unsicherheit – Schüler:innen vertrauen nicht darauf, dass sie die richtigen Formulierungen finden, dass sie korrekt und fokussiert schreiben können. Deshalb greifen sie schnell zu KIs – so erhalten sie die Sicherheit, einen sinnvollen, klaren, korrekten Text zu haben, mit dem sie die schulischen Anforderungen erfüllen.
Daran sieht man: Diese Anforderungen sind ein Teil des Problems – auch wenn sie teilweise von Schüler:innen nur imaginiert werden. Wenn Texte benotet werden, wenn es Kriterien gibt, denen sie genügen müssen, wenn «schlechte» Texte zu Kritik und Abwertung führen, wenn Fehler negative Konsequenzen haben, dann ist die Schule oder die Lehrperson direkt dafür verantwortlich, dass Schüler:innen KI benutzen. Sie schaffen so starke Anreize, denen wenige Menschen widerstehen können. Es ist dann ein paradoxes Signal, an die Moral von Schüler:innen oder an ihre Einsicht zu appellieren, wenn sie gleichzeitig anhand ihrer produzierten Texte beurteilt werden.
Was hilft, sind dialogische Prozesse, Gespräche über Texte. Darin tritt die Lehrperson als interessiertes Gegenüber, als Leserin oder Leser auf. Sie interessiert sich für das, was Schüler:innen schreiben. Der Schreibprozess bekommt so eine Richtung, er ist in eine Beziehung eingebettet, was Schüler:innen selber tun, spielt eine Rolle. Texte sind echte Antworten auf echte Fragen. Das Gegenüber kann, gerade bei älteren Schüler:innen, auch jemand anderes sein.
Soweit das Ideal – in der schulischen Realität hat es oft keinen Platz und wird durch schlechtere Schreibformen ersetzt. Dennoch auch hier einige Grundeinsichten:
Schreiben in Heften und von Hand gibt mehr Vertrauen ins eigene Können. (KI-Überarbeitung ist nicht verboten, aber erfolgt in einem zweiten Schritt.)
Schreiben kann eine Person, wenn sie etwas zu sagen hat.
Wer in einem guten Prozess schreibt, kann problemlos transparent machen, wofür KI eingesetzt worden ist. Wer etwas verheimlicht oder verheimlichen möchte, arbeitet in einem schlechten Prozess.
KI kann das, was jemand sagen kann, glätten und verflachen. Das merkt man aber erst, wenn man den eigenen Text mit einem KI-Text vergleicht.
Menschen können besser schreiben als eine KI, aber erst, wenn sie sehr gut schreiben können (Fachkompetenzschwelle).
Offene Fragen
Ich schreibe viel und gerne. Diesen Text habe ich mir von Claude entwerfen lassen und nichts davon übernommen – der KI-Text drückte nicht das aus, was ich schreiben wollte. Es fiel mir leichter, alles selber zu schreiben. Das hat mir noch einmal zu Klarheit verholfen, in künftigen Vorträgen oder Workshops werde ich schneller auf passende Formulierungen zurückgreifen können.
Mein Schreiben ist aber kein guter Ausgangspunkt, um über das zukünftige Schreiben von Schüler:innen nachzudenken. Nur wenige werden jemals so schreiben wie ich, vielleicht niemand. Deshalb formuliere ich zum Schluss einige Fragen, auf die ich keine Antworten kenne:
Werden junge Menschen später längere Texte schreiben müssen?
Wird Schreiben ein wichtiger Weg bleiben, um vertiefte und differenzierte Gedanken formulieren zu können?
Was hilft Lernenden dabei, beim Vibe Writing Texte kritisch zu prüfen und sie differenziert zu verbessern?
In the media and on social media, there has been a growing number of concerned reports about AI companies that are buying up used books in large quantities and in a rather ominous manner. It is speculated that the large quantities of books acquired in this way are scanned, used for AI training, and irretrievably destroyed in the process. It is often suggested that copyright law is the reason why the books are being destroyed. Can this assumption be substantiated?
The Destructive Scanning of Books
The retro-digitization (usually referred to simply as “digitization”) of books is typically carried out using scanning technology. Modern book scanners are capable of scanning books non-destructively. However, non-destructive scanning of books is a complex process, as irregularities caused by the book’s binding must be compensated for during the scanning process.
In contrast, in so-called destructive scanning, the book’s binding is mechanically removed. This turns a book into a loose collection of pages that can be conveniently digitized using a sheet-fed scanner. Once the scanning process is complete, the book pages are then disposed of as waste paper.
Why Antiquarian Bookstores Are Important for AI Training
Digital data sources, such as web archives, have long been incorporated into the training of current AI models. The digitization of printed books is now the next stage in data acquisition. According to observers, tech companies are particularly focused on non-fiction books published between the 1970s and the 1990s.
These books are likely to be of interest for three reasons: First, nonfiction books are valuable for AI training because of their content; they contain factual information that is still largely accurate and is integrated into linguistically sophisticated patterns of argumentation. Second, book titles published before the mid-1990s were generally released exclusively as print editions and have not been digitized since. Third, books from the period in question are still predominantly subject to copyright, which expires only 70 years after the author’s death in both Germany and the U.S.
Obtaining scans of these books from dubious third-party sources would be illegal. Therefore, from a copyright perspective, the purchased print editions of these books are particularly valuable to the companies.
Technical Reasons for Destructive Scanning
But why do AI companies accept the destruction of the books during the scanning process?
First, technical aspects play a significant role in large-scale retro-digitization of books: As explained at the outset, destructive scanning is simpler, faster, and therefore more cost-effective. Although the AI industry appears economically strong, observers interpret the decision to use the most cost-effective digitization method as an indication of cost pressure in this “highly competitive industry.”
Competitive considerations may also play a role, because while the books in question are not particularly old or unique, many of them are nevertheless rarely available on the antiquarian book market due to low print runs and scarcity. Whoever buys them first effectively removes them from the competition’s reach, thereby gaining a small advantage for their AI model.
Destructive Scanning Out of Concern for Copyright?
A lawsuit between three plaintiff authors and the AI company Anthropic before the United States District Court for the Northern District of California (Bartz v. Anthropic) established a legal precedent regarding destructive book scanning in 2025.
The central question here was whether destructive scanning, on the one hand, and the training of AI models using the content of acquired digitized books, on the other, fall under the so-called “fair use principle.”
What is the fair use principle?
The fair use principle is a legal doctrine found in some common law countries. It permits the use of copyrighted material for purposes of public education or intellectual production without requiring authorization for such use. Classic areas of application for fair use include commentary, criticism, parody, news reporting, research, and scholarship. Under German copyright law, instead of a general clause like fair use, there are narrow exceptions that permit certain uses (such as quotations, caricatures, parodies, educational and scholarly purposes, reporting on current events, etc.) regardless of the copyright holder’s consent.
The two central questions to be decided by the court must be considered separately:
First, whether training AI models with the content of purchased digitized books is protected by the fair use doctrine.
Second, whether destructive scanning constitutes a copyright-relevant copy of a work.
According to Judge William Alsup, training AI models using the content of purchased digitized books was “transformative in the truest sense of the word” and therefore protected by the fair use doctrine. Destructive scanning should be classified as “replacement scanning,” in which a printed work is replaced by a digital work. This conversion of a purchased printed book into a digital book was classified by the court as a “format change” rather than a copy and is therefore also covered by fair use.
A Landmark Ruling with Significant Implications
The rule on format conversion—also known as the “format-shifting rationale”—thus promises, according to this landmark ruling, a certain degree of legal certainty for AI companies that destroy the books they have acquired for AI training through destructive scanning. The method that is more efficient from a technical standpoint is therefore also the more legally advisable one.
However, it is a fallacy to assume that the court’s ruling requires AI companies to destroy the digitized books. The lawsuit merely examined the specific digitization process as applied by Anthropic as part of “Project Panama”—and classified it as fair use.
E-books Instead of Print Books?
If e-books were used for training instead of their printed counterparts, the time-consuming step of scanning—and the associated issues of transportation, storage, and reuse—would be eliminated.
However, e-books can only become training data for AI models in two ways: the legal way—that is, with the involvement of the rights holders of those e-books—or by training with pirated copies. For AI companies, the legal route entails a significantly higher “legal/practice/business slog” (quote from Anthropic co-founder and CEO Dario Amodei).
Training AI with pirated copies of e-books is not covered by fair use and thus constitutes a clear copyright infringement, Judge Alsup ruled.
Fears of ‘Fahrenheit 451’ Scenarios
Reports of AI companies purchasing large quantities of books from used bookstores have sparked, in some cases, fierce reactions in the media. The media discussion often references Ray Bradbury’s novel *Fahrenheit 451*, a dystopia in which books are banned.
A closer look at the relevant court ruling in this specific case reveals that there is no legal obligation to destroy retro-digitized books. Economic reasons for choosing the most cost-effective digitization method therefore appear to be the decisive factor when the AI industry employs destructive book scanning. Against the backdrop of the actions taken by major AI companies, calls for open-source AI models are currently growing louder, and with regard to the retro-digitization of books, there are also increasing calls for “an open-source initiative or a similar nonprofit project.”
Would you like to support iRights.info?
iRights.info provides information and explanations on the subject of “Copyright and creativity in the digital world”. All texts are published free of charge and openly licensed.
If you like, you can support us via the donation platform Betterplace and receive a donation receip. Betterplace accepts PayPal, direct debit, credit card, paydirekt or bank transfer.
We would be particularly pleased to receive a regular contribution, for example as a monthly standing order. The non-profit organization iRights e.V. would like to thank you for your support!
In so gut wie jeder Fortbildung, die ich in den letzten Monaten gegeben habe, kam irgendwann derselbe Einwand: „Skandinavien geht doch längst wieder zurück zu Buch und Stift – die haben die Digitalisierung ja auch zurückgedreht.“ Meistens folgt daraus ein Plädoyer, bei KI in der Schule lieber zu bremsen als zu gestalten, oder gleich ein generelles Störgefühl gegenüber allem Digitalen im Unterricht. Die Beobachtung stimmt sogar, nur eben nicht in der reflexhaft artikulierten Form. Und wenn dann die WELT beispielsweise vor einigen Wochen titelt „Holt Euch das Klassenzimmer zurück! Skandinavien zieht die Digitalisierungs-Notbremse“ führt das sicher zu vielen Klicks und fast 500 Kommentaren, wirft aber Digitalisierung, Infrastruktur, persönliche Smartphones und generative KI einfach zusammen – trägt aber sicherlich nicht zu einer differenzierten Debatte bei.
Vom Mythos zum Realitätscheck – eine Falschmeldung und ihr Kontext (Hauke Pölert / NotebookLM 2026)
Und dieses Muster, aus einer differenzierten Entwicklung im Ausland eine deutsche Entweder-oder-Debatte zu machen, ist Teil eines größeren Problems, das mich schon länger umtreibt: Wir diskutieren Digitalisierung und jetzt KI in der Schule in Deutschland viel zu polarisierend. Zeit, sich die skandinavischen Fälle einzeln und mit Zahlen anzuschauen – und danach zu fragen, was wir wirklich daraus lernen wollen.
Diagnose: Eine Schlagzeile, 2-3 völlig unterschiedliche Geschichten
Auslöser für viele der jüngeren Gespräche ist eine Tagesschau-Meldung über neue Regeln gegen KI-Nutzung an dänischen Gymnasien. Kombiniert mit älteren Berichten über Schwedens Rückkehr zu gedruckten Schulbüchern, entsteht daraus ein Bild: Die „skandinavischen Länder“ würden sich geschlossen von der Digitalisierung abwenden. Der Tenor vieler Artikel lässt sich auf eine Formel bringen – Skandinavien kehrt der Digitalisierung den Rücken.
Das Problem an dieser Formel ist nicht nur, dass sie ungenau ist. Sie bedient auch einen Reflex, den ich aus der deutschen Debatte der letzten zehn, fünfzehn Jahre nur zu gut kenne: das Bedürfnis, sich für eine Seite zu entscheiden. Erst hieß es, 1:1-Tablet-Klassen seien gleichbedeutend mit „moderner Bildung“, das „Ende der Kreidezeit“ werde eingeläutet, Fortschritt zeige sich am Gerät in der Hand. Jetzt, mit Blick auf Skandinavien, droht die Gegenbewegung: Wenn die „Vorreiterländer“ angeblich zurückrudern, dann muss das ja heißen, dass wir es auch dürfen – oder sollen. Beide Positionen eint, dass sie Digitalisierung als Ja-oder-Nein-Frage behandeln, nicht als Gestaltungsaufgabe. Schaut man auf die tatsächlichen Maßnahmen, Zahlen und – vor allem – Zeitpunkte in Skandinavien, zerfällt die vermeintlich einheitliche „Trendwende“ ohnehin in mindestens zwei eigenständige Geschichten, zu denen sich mit Norwegen noch eine dritte, gegenläufige gesellt.
Fall 1 – Lesekrise und Kurswechsel in Schweden
Schwedens Kurswechsel beginnt 2022, unter Bildungsministerin Lotta Edholm – und damit deutlich vor dem generativen KI-Boom, den ChatGPT ab Ende 2022 auslöste. Ausgangspunkt waren nicht KI-Sorgen, sondern rückläufige PISA-Ergebnisse und eine sinkende Lesekompetenz, auf die unter anderem der Karolinska-Institut-Forscher Sissela Nutley öffentlich hingewiesen hatte – seine Kritik an einer zu forcierten Bildschirm-Frühdigitalisierung erhielt in der schwedischen Bildungspolitik erhebliches Gewicht.
rund 180 Millionen Euro Investition in gedruckte Lehrbücher und Bibliotheken (die genaue Summe schwankt je nach Quelle und Berichtszeitraum zwischen rund 104 und 183 Millionen Euro – ich beziehe mich hier auf die aktuellere, 2026 genannte Zahl);
ein spürbar zurückgefahrener digitaler Unterricht für jüngere Kinder, insbesondere in der Vorschule und den ersten Grundschuljahren;
ein landesweites Handyverbot an Schulen;
ein neuer, deutlich stärker analog ausgerichteter Lehrplan, der bis 2028 vollständig eingeführt sein soll.
Sowohl-als-auch-Politik in Schweden – am ehesten: 2 Schritte vor, 1 Schritt zurück in einem hochdigitalisierten System (Hauke Pölert / NotebookLM 2026)
Schweden reagiert also auf eine Lesekrise bei jüngeren Jahrgängen, die lange vor dem KI-Thema entstanden ist – nicht auf ein Problem mit generativer KI. Bemerkenswert daran ist aus meiner Sicht vor allem eines: Auch Schweden korrigiert nicht „digital“ durch „analog“, sondern eine zu einseitige frühe Bildschirmnutzung durch eine bewusstere Balance. Genau diese Differenzierung geht in der deutschen Rezeption meistens verloren.
Fall 2: Prüfungsrealität und Kurswechsel in Dänemark
Dänemarks Maßnahmen sind neueren Datums – sie greifen 2025/26 – und beruhen auf einer anderen Diagnose. Laut Berichten über eine Erhebung des Danmarks Evalueringsinstitut nutzt inzwischen rund ein Drittel (≈ 33 %) der Gymnasiast:innen KI-Werkzeuge täglich, und rund 40 % der KI-Nutzenden geben in Befragungen an, sich durch die Nutzung selbst fauler oder weniger konzentriert zu fühlen. Diese Zahlen stammen aus Sekundärberichten über die Studie, nicht aus der Primärquelle selbst – als grobe Größenordnung eignen sie sich aber zur Orientierung.
Reagiert wird darauf mit gezielten, prüfungsbezogenen Maßnahmen:
mehr Aufgaben, die unter Aufsicht in der Schule statt zu Hause bearbeitet werden,
gesperrter KI-Zugriff während der eigentlichen Prüfungssituation.
Wichtig ist der Blick darauf, was dabei nicht passiert: Dänemark verbietet KI nicht grundsätzlich, sondern reguliert die Technologie kontextspezifisch für Oberstufenschüler. Ein Pilotprojekt erlaubt KI bereits in mündlichen Englischprüfungen, ab 2026 soll genKI offiziell in mündliche Abiturprüfungen integriert werden, und parallel entsteht eine nationale KI-Bildungsstrategie.
KI in geregelte Bahnen bei selbstverständlicher Nutzung – Beispiel Dänemark (Hauke Pölert / NotebookLM 2026)
Das Ziel ist also nicht der Rückzug aus der KI, sondern der Schutz des eigenständigen Denkens in der konkreten Prüfungssituation – bei gleichzeitiger Öffnung für KI dort, wo sie den Lernprozess unterstützen kann, statt ihn zu ersetzen. Das ist im Kern genau die Art von kontextsensibler, aufgabenbezogener Entscheidung, die in Deutschland in der öffentlichen Debatte kaum eine Rolle spielt, weil wir lieber grundsätzlich diskutieren: KI-Verbot oder KI-Freigabe, statt: In welcher Lernsituation hilft was?
Fall 3: Konsequente Digitalisierungsstrategie in Norwegen
Wer von „Skandinavien“ spricht, sollte auch Norwegen nicht vergessen – und das zeigt mit Blick auf digitale Strukturen gerade keine Kehrtwende, sondern das Gegenteil. 93% der norwegischen Grundschulen und 96% der Sekundarschulen gelten dort als hoch digital ausgestattet. Norwegen verfolgt seit 2015 konsequent eine Digitalisierungsstrategie und verankert digitale Kompetenz fest in allen Fächern, ohne aktuell eine vergleichbare Kurskorrektur wie Schweden einzuleiten. Mit Blick auf KI wird allerdings ganz aktuell ebenfalls eine klare Regelung eingeführt, bei der die Regierung einem gestuften Modell folgt, das sich am Alter der Kinder orientiert. Für die Klassenstufen eins bis sieben, also für Kinder im Alter von sechs bis 13 Jahren, gilt künftig ein generelles KI-Verbot. In der Sekundarstufe eins, bei den 14- bis 16-Jährigen, dürfen KI-Tools zwar zum Einsatz kommen, aber nur unter strenger Aufsicht der Lehrkräfte und mit großer Vorsicht. Erst in der gymnasialen Oberstufe für Jugendliche zwischen 17 und 19 Jahren sieht das Konzept eine gezielte Vermittlung von KI-Kompetenzen vor, damit die Heranwachsenden angemessen auf die Anforderungen von Hochschule und Arbeitswelt vorbereitet werden.
Von einer einheitlichen skandinavischen Bewegung „zurück zum Papier“ kann also schon rein empirisch keine Rede sein.
Im Überblick: Drei Länder, drei Ausgangslagen
Schweden
Dänemark
Norwegen
Zeitpunkt der Kurskorrektur
seit 2022
seit 2025/26
keine – kontinuierliche Digitalisierung seit 2015
Auslöser
sinkende Lesekompetenz, rückläufige PISA-Werte
KI-gestützter Prüfungsbetrug, Sorge um Kompetenzerwerb
– (Strategie unverändert fortgeführt)
Betroffene Altersgruppe
vor allem jüngere Jahrgänge (Vorschule, Grundschule)
vor allem ältere Jahrgänge (Gymnasium, Abitur)
alle Jahrgangsstufen
Zentrale Maßnahme(n)
≈ 180 Mio. € für gedruckte Bücher/Bibliotheken, Handyverbot, neuer Lehrplan bis 2028
mündliche Verteidigung schriftlicher Arbeiten, mehr Aufsicht, KI-Sperre während Prüfungen
flächendeckende digitale Ausstattung, digitale Kompetenz in allen Fächern
Umgang mit KI
im Fokus der Maßnahmen kaum thematisiert (Fokus liegt auf Screentime/Lesen)
reguliert, nicht verboten – Pilotprojekt für KI in mündlichen Prüfungen, ab 2026 Teil des Abiturs
fester Bestandteil des Digitalcurriculums, zugleich Neueinführung einer abgestuften Regelung mit KI-Verboten
Digitalisierungsgrad der Schulen
rückläufig bei jüngeren Jahrgängen
im Prüfungskontext reguliert, sonst unverändert
93–96 % „hoch digital ausgestattet“
Die Tabelle macht sichtbar, was die Schlagzeile verdeckt: Es handelt sich nicht um eine konsequente und einheitliche Bewegung à la „Skandinavien macht…“, sondern um drei unterschiedliche Antworten auf drei unterschiedliche Fragen – Lesekompetenz, Prüfungsintegrität und kontinuierliche Digitalstrategie. Keines der drei Länder trifft dabei eine grundsätzliche Entscheidung für oder gegen Digitalisierung oder KI. Alle drei entscheiden situativ, altersgruppen- und kompetenzbezogen – also genau so, wie es im Rahmen differenzierter Unterrichtsentwicklung eigentlich immer passieren sollte.
Übersicht: Unterschiedliche skandinavische Länder und ihre Bildungspolitik – keine Einheitlichkeit, sondern differenziertes Vorgehen (Hauke Pölert / NotebookLM 2026)
Konsequenz: Was das für deutsche Schulen bedeutet
Die Schlagzeile „Skandinavien wird analog“ verwischt also, dass es um zwei unterschiedliche Probleme geht: Lesekompetenz auf der einen, Prüfungsintegrität auf der anderen Seite. Wer daraus pauschal „KI raus aus der Schule“ ableitet, überträgt eine dänische Prüfungsreform auf ergriffene Maßnahmen im Kontext einer schwedischen Lesekrise – und übersieht, dass beide Länder KI in ihren älteren Jahrgängen gerade stärker in geregelte Bahnen lenken, nicht abschaffen.
Für die Diskussion im Rahmen deutscher Lehrkräfteprofessionalisierung lassen sich daraus vier konkrete Ansatzpunkte mitnehmen, die ich auch hier im Blog genauso wie viele Kolleginnen und Kollegen immer wieder diskutiere:
Prüfungsformate diversifizieren: Mündliche Anteile und Prozessbewertung, wie in Dänemark erprobt, entziehen sich der reinen Texterzeugung durch KI und geben ehrlicheren Aufschluss über tatsächlich erworbene Kompetenz. Das lässt sich auch ohne dänisches Vorbild in bestehende Prüfungsformate integrieren, etwa durch verpflichtende mündliche Rückfragen zu schriftlichen Hausarbeiten. Vergleichbar geht inzwischen auch Niedersachsen mit den Kombinierten Leistungsnachweisen im Rahmen der Oberstufenreform vor – ein sinnvoller Schritt in die richtige Richtung.
Analoge Grundfertigkeiten nicht der Digitalisierung opfern: Schwedens 180-Millionen-Investition zeigt, wie teuer eine Korrektur wird, wenn Handschrift, Lesekompetenz und Konzentrationsfähigkeit in der Grundschule zu früh zugunsten von Bildschirmzeit zurückgestellt werden. Das ist kein Gegensatz zu späterer KI-Kompetenz, sondern deren Voraussetzung und sollte daher sehr systematisch diskutiert und angegangen werden.
KI-Kompetenz nicht verbieten, sondern in klare Leitplanken einbetten: Weder freie Nutzung noch pauschale Sperrung überzeugen – gefragt sind, wie in Dänemark, Regeln, die zwischen Prüfungssituation und Lernprozess unterscheiden und KI dort gezielt zulassen, wo genKI den Kompetenzerwerb nicht untergräbt, sondern im Optimalfall sogar Selbstwirksamkeit und Bewusstsein für Eigenständigkeit stärkt.
Skandinavien differenziert zitieren: Wer sich in Fortbildungen oder Konferenzen auf „die Skandinavier“ beruft, sollte Land, Zeitpunkt und Ursache benennen, statt zu pauschalisieren. Aus einer differenzierten Beobachtung darf nicht ein bequemes Feigenblatt für Stillstand, Blockade und Ablehnung werden.
Was bedeutet das für Deutschland? Weg aus der Entweder-Oder-Debatte und hin zu Lösungsansätzen (Hauke Pölert / NotebookLM 2026)
Persönliche Einordnung: Das eigentliche (typisch deutsche?) Problem liegt tiefer
Mir scheint, die Skandinavien-Debatte ist nur das jüngste Symptom eines viel älteren deutschen Musters. In den letzten zehn, fünfzehn Jahren haben wir Digitalisierung an Schulen zu oft mit 1:1-Tablet-Konzepten gleichgesetzt und die Frage „Sind wir ‚modern‘?“ nur auf der Oberflächenebene beantwortet: Welches Gerät nutzt ihr? Seid ihr eine iPad-Schule? Ist bei euch die „Kreidezeit“ vorbei?
Viel zu oft an der Oberfläche – und das seit vielen Jahren: Die Diskussion rund um Digitalisierung, Digitalität und KI in Deutschland (Hauke Pölert / NotebookLM 2026)
Diese Fragen fühlen sich nach Fortschritt an, sagen aber wenig darüber aus, ob sich schulisches Lernen und mit ihm der Unterricht selbst verändert haben. Wirkliche Unterrichtsentwicklung im Kontext von Digitalität – also die Frage, wie sich Aufgabenkultur, Zusammenarbeit, Prüfungsformate und Lernbegleitung verändern (müssen), wenn digitale Werkzeuge verfügbar sind – bleibt dabei zu oft Nebenaspekt.
Deshalb scheint mir der Skandinavien-Reflex, den ich eingangs beschrieben habe, so nachvollziehbar (Stichwort: Eisberg-Modell) wie ärgerlich: Der Bezug darauf bietet die bequeme Hoffnung, dass die vermeintlichen „Vorreiterländer“ die Antwort schon gefunden hätten – nämlich zurück zu Buch und Stift. Diese Hoffnung übersieht, dass keines der drei Länder eine solche Entscheidung getroffen hat oder trifft. Schweden korrigiert eine Altersgruppe, Dänemark reguliert eine Prüfungssituation, Norwegen zieht sein digitales Curriculum unbeirrt durch. Eine differenzierte, konzeptionell durchdachte deutsche Antwort hätte ohnehin nie „entweder digital oder analog“ heißen müssen, sondern von Anfang an: digitale und analoge Formen dort kombinieren, wo sie sich sinnvoll ergänzen – Blended Learning im eigentlichen, konzeptionellen Sinn, nicht als Worthülse für „mal ein Tablet, mal ein Buch“. Wenn wir aus Skandinavien etwas lernen wollen, dann nicht die in der Schlagzeile enthaltene Hoffnung auf ein diffuses „Zurück“, sondern die Grundhaltung dahinter: genau hinschauen, wer welches Problem hat, und dann eine begründete Antwort darauf finden.
Und auch seit vielen Jahren mein Plädoyer: Hin zu Blended Learning-Konzepten statt Entweder-Oder-Diskussionen (Hauke Pölert / NotebookLM 2026)
Fazit
Nicht „zurück zum Papier“, sondern: genauer hinschauen. Skandinavien liefert kein einheitliches Modell, das sich einfach kopieren ließe – sondern mehrere Blaupausen für unterschiedliche Probleme, aus denen sich lernen lässt: Schweden für den Umgang mit Lesekompetenz und früher Bildschirmzeit, Dänemark für die Regulierung von KI in Prüfungssituationen, Norwegen als Beleg dafür, dass konsequente Digitalisierung und gute Schule sich nicht ausschließen.
Ich würde mir für uns wünschen, dass wir nicht reflexhaft die Nachahmung einer vermeintlichen Trendwende fordern, sondern an unserer Grundhaltung arbeiten: Gute Regulierung entsteht aus konkreter Diagnose und iterativer Entwicklung – nicht aus einem pauschalen Digital-vs.-analog-Reflex.

 Anmelden